
Grunnleggende AI
Hva er kvantedatamaskiner?

 Legg til Unite.AI blant dine foretrukne kilder på Google
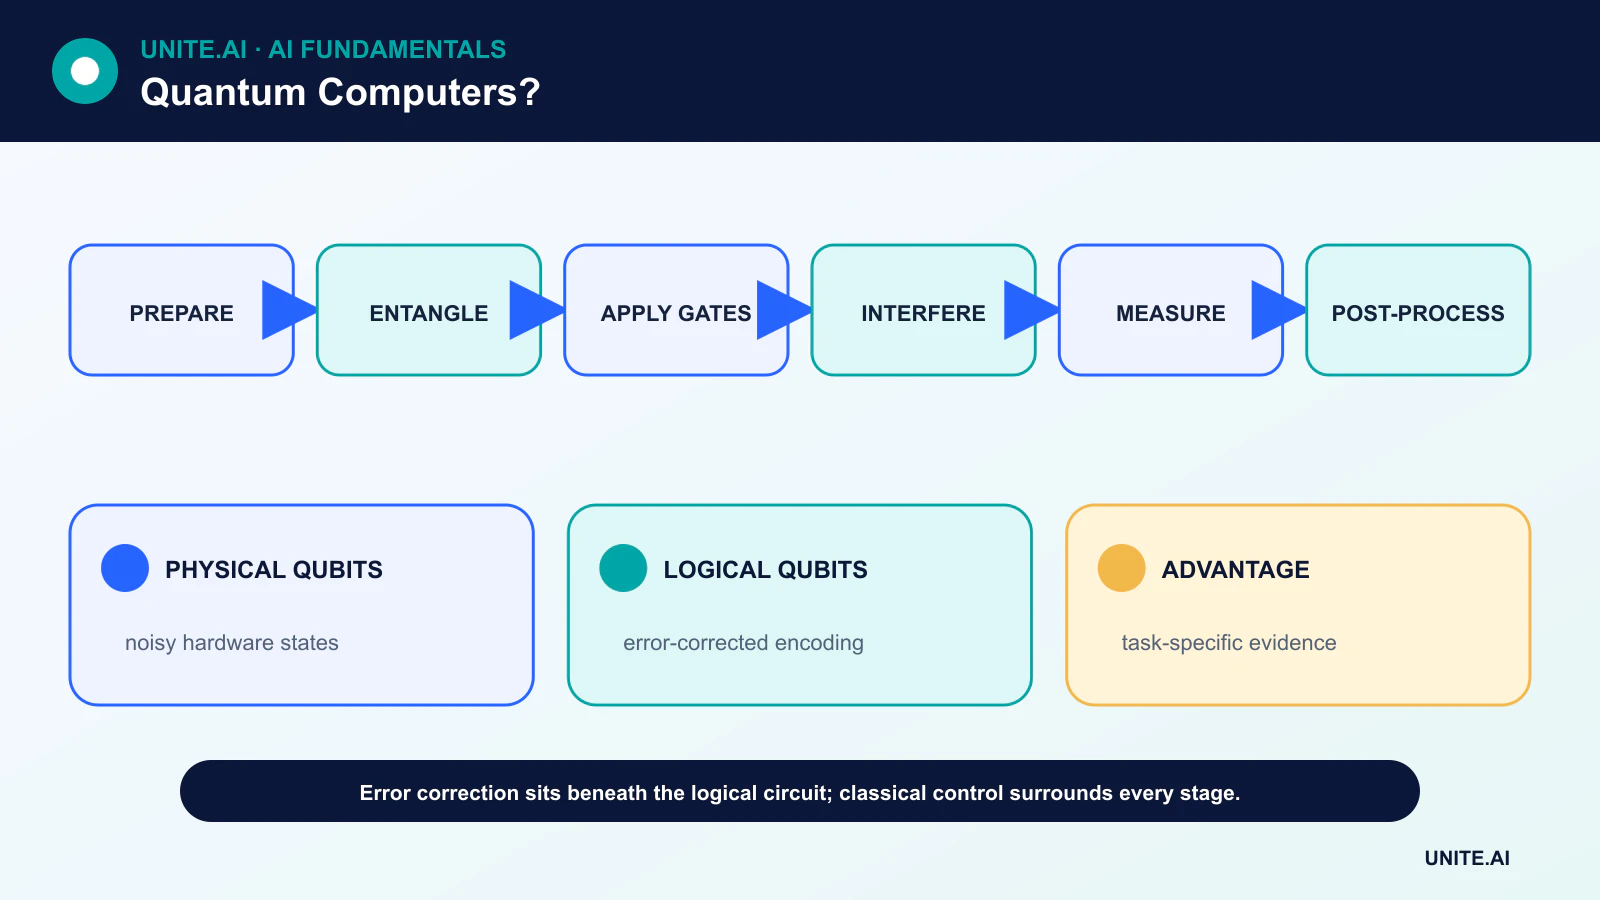
Kvantedatamaskiner prosesserer informasjon med kvantetilstander. Deres grunnleggende enhet, qubit, kan forberedes i en superposisjon og korreleres med andre qubits gjennom sammenfiltring. Kvanteporter former amplituder slik at interferens øker sannsynligheten for nyttige måleutfall.
En kvantedatamaskin prøver ikke bare alle svar parallelt og viser det beste. Måling gir et begrenset klassisk resultat. En nyttig algoritme må bevisst konstruere interferens og vanligvis gjenta kretsen mange ganger for å estimere sannsynligheter.
Viktige punkter
- Qubits er kvantetilstander; porter manipulerer amplituder og måling gir klassiske resultater.
- Sammenfiltring skaper korrelasjoner som klassiske beskrivelser kan representere ineffektivt, men det er ingen universell hastighetsforbedring.
- Støy begrenser kretsdybde, så nyttige systemer i stor skala krever feilkorrigering og mange fysiske qubits per logisk qubit.
- Kvantfordel er oppgavespesifikk; klassisk databehandling forblir essensiell i hybride arbeidsflyter.
Qubits, superposisjon og måling
En klassisk bit leses som 0 eller 1. En qubit kan forberedes som en vektet kombinasjon av basis‑tilstander, beskrevet av komplekse amplituder der kvadrerte størrelser bestemmer målesannsynligheter. Porter roterer og kobler disse tilstandene på en matematisk kontrollert måte.
Måling er ikke en avlesning av hver amplitude. Den gir et resultat som 0 eller 1 og endrer tilstanden. Algoritmer bruker derfor gjentatte kjøringer, nøye designet interferens og klassisk etterbehandling for å trekke ut et nyttig estimat.
Sammenfiltring og kvantekretser
Sammenfiltring beskriver en felles kvantetilstand som ikke kan faktoriseres i uavhengige tilstander for hver qubit. Den kan være en beregningsressurs, men sammenfiltring alene løser ikke et problem. En krets kombinerer tilstandsfremstilling, én‑ og to‑qubit‑porter, måling og ofte en klassisk optimaliserer.
Hybrid‑variational‑algoritmer kjører gjentatte ganger parameteriserte kretser og oppdaterer parametere på en klassisk datamaskin. De er attraktive for nær‑term‑eksperimenter, selv om bevis på praktisk fordel må sammenlignes med sterke klassiske referanser, inkludert total prøvetaking og kostnad for feil‑mitigering.
Støy og kvantefeilkorrigering
Fysiske qubits mister koherens og porter introduserer feil. Å legge til flere støyende operasjoner kan forverre resultatet. Kvantefeilkorrigering koder én logisk qubit over mange fysiske qubits, oppdager feil‑syndromer og korrigerer feil uten å direkte måle den beskyttede informasjonen.
Den nødvendige overheaden avhenger av maskinvarens feilrater, kodevalg, tilkoblingsgrad og mål‑algoritmen. Antall fysiske qubits fra ulike systemer er derfor ikke direkte sammenlignbare, og et stort antall fysiske qubits er ikke det samme som en stor feil‑tolerant maskin.
Hvor kvantealgoritmer kan være til nytte
Kjente algoritmer gir teoretiske fordeler for spesifikke oppgaver som faktorisering, usortert søk og simulering av kvantesystemer. Forskning utforsker også optimalisering og maskinlæring, men mange forslag overgår ennå ikke den beste klassiske metoden under realistiske maskinvare‑ og data‑innlastingsforutsetninger.
Et troverdig påstand bør navngi problemet, inndata‑størrelse, feilmodell, nøyaktighetsmål, klassisk sammenligningsgrunnlag og total ressursestimat. «Kvantoverlegenhet» eller «fordel» er en eksperimentell påstand om en definert oppgave, ikke bevis på at kvantedatamaskiner generelt er raskere.
Kvantedatabehandling og cybersikkerhet
En tilstrekkelig kapabel feil‑tolerant kvantedatamaskin vil true mye brukte offentlige nøkkelsystemer basert på faktorisering og diskrete logaritmer. Den vil ikke automatisk knekke alle symmetriske chiffer eller hash‑funksjoner.
NIST fullførte sine første post‑kvante‑kryptografistandarder i 2024, så organisasjoner bør kartlegge kryptografiske avhengigheter og planlegge migrering lenge før en kryptografisk relevant kvantedatamaskin eksisterer. Dette er et cybersikkerhets‑ og data‑livssyklus‑spørsmål fordi fanget kryptert data kan forbli verdifull i flere år.
Qubits, porter og kvanteinformasjon
En qubit beskrives av en kvantetilstand der amplitudene bestemmer målesannsynligheter. Superposisjon tillater en tilstand å kombinere basis‑muligheter, mens sammenfiltring skaper korrelasjoner som ikke kan representeres som uavhengige qubits. Kvanteporter er reversible unitære operasjoner; en krets forbereder en tilstand, anvender porter og måler klassiske biter. Måling avslører ikke amplituder direkte, så en algoritme må arrangere interferens som øker nyttige resultater og undertrykker andre. Kvante‑parallellisme alene betyr ikke at hvert mulig svar leses samtidig.
Fysiske qubits kan bruke supraledende kretser, fangede ioner, nøytrale atomer, fotoner, spinn eller andre systemer. Hver plattform varierer i port‑hastighet, tilkoblingsgrad, pålitelighet, koherens, måling, kontroll, kjøling og produksjonsmuligheter. Støy akkumuleres under beregning. Kvantefeilkorrigering koder en logisk qubit over mange fysiske qubits og oppdager gjentatte ganger feil uten å direkte måle den beskyttede logiske informasjonen. Nyttige feil‑tolerante maskiner krever feilrater under terskler og betydelig overhead for logiske porter og dekoding.
Algoritmer, kompleksitet og nåværende maskinvare
Shors algoritme gir polynomisk‑tid faktorisering og diskrete logaritmer på en tilstrekkelig kapabel feil‑tolerant datamaskin, noe som motiverer migrering til post‑kvante‑kryptografi. Grovers algoritme gir en kvadratisk hastighetsøkning for usortert søk, ikke en eksponential. Kvantesimulering er et naturlig mål fordi kvantesystemer er vanskelige å representere klassisk. Variasjonsalgoritmer kombinerer korte kvantekretser med klassisk optimalisering, men støy, trenbarhet og klassisk konkurranse begrenser bevis på praktisk fordel på dagens maskiner.
Et påstand om kvantefordel må definere oppgaven, inndata, utdata‑kvalitet, maskinvare‑tid, prøvetaking, forhåndsbehandling, feil‑mitigering og det sterkeste klassiske referansegrunnlaget på sammenlignbare ressurser. Kun antall qubits er utilstrekkelig; kretsdybde, tilkoblingsgrad, pålitelighet og logisk feil er viktig. Noen demonstrasjoner løser spesielt konstruerte prøvetakingsproblemer med begrenset anvendelse. Tilgang til skyen er nyttig for forskning og utdanning, men arbeidsbelastninger kan stå i kø, avhenge av proprietær kalibrering, og returnere sannsynlige prøver som krever statistisk analyse.
Ansvarlig planlegging for kvantedatabehandling
Organisasjoner bør kartlegge kryptografi og starte standardbasert post‑kvante‑migrasjon uavhengig av spådommer om en kryptografisk relevant maskin. For applikasjoner, identifiser en presis beregningsflaskehals, estimer logiske ressurser, og sammenlign stadig forbedrede klassiske algoritmer og maskinvare. Beskytt sensitiv data som sendes til sky‑kvantedatatjenester og bevar reproducerbare krets‑, kompilator‑ og kalibrerings‑registre. Kvantedatabehandling er en annen beregningsmodell med dokumenterte teoretiske hastighetsgevinster og aktiv ingeniørutvikling, men den er ikke en generell erstatning for CPU‑er, GPU‑er eller klassisk AI.
Arbeidseksempel: evaluering av et kvante‑optimaliseringspåstand
En logistikkstudie kartlegger et rute‑delproblem til en kvantekrets og sammenligner det med klassiske heuristikker. Evalueringen inkluderer data‑koding, krets‑kompilering, kø, prøvetaking, feil‑mitigering og resultat‑dekoding, og rapporterer løsningskvalitet og reell klokketid. Den bruker den sterkeste tilgjengelige klassiske referansen på tilsvarende problem‑instanser og forklarer om den kvanteenheten løser hele forretningsproblemet eller kun en liten konstruert kjerne.
Resultatene gjentas på tvers av kalibreringer og størrelser, med oppgitt kretsdybde, to‑qubit‑feil, antall skudd og feilrate. Et støyende variational‑resultat som samsvarer med en klassisk løsning kalles ikke kvantefordel. Ressursestimatene viser de logiske qubits og feil‑korrigerings‑overhead som trengs for skalering. Organisasjonen starter separat en post‑kvante‑kryptografiinventar fordi denne sikkerhetsmigrasjonen er fornuftig uavhengig av om optimaliseringseksperimentet gir kortsiktig verdi.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inndata, utdata, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproducerbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, randbetingelser, feil‑ eller manglende inndata, distribusjonsendring, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavens kvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan gjenskape resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndatakvalitet, utdata‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varsel‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagrings‑prosedyrer, og et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Vil kvantedatamaskiner erstatte klassiske datamaskiner?
Nei. De er spesialiserte akseleratorer for bestemte algoritmer og vil være avhengige av klassiske systemer for kontroll, kompilering, nettverk og etterbehandling.
Er en qubit både 0 og 1?
En qubit kan være i en superposisjon av basis‑tilstander, men måling gir et klassisk resultat i henhold til tilstandens sannsynligheter. Uttrykket «begge på én gang» er en ufullstendig forkortelse.
Primære referanser












