AI-modeller og plattformer
Hva er Moores lov, og hvordan påvirker den AI?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Moores lov er den historiske observasjonen at økonomisk nyttige integrerte kretser har en tendens til å øke antall komponenter i eksponentielt tempo. Det er ingen fysisk lov, og den sier ikke at datamaskiner automatisk blir dobbelt så raske på en fast tidsplan.
For AI er transistordensitet viktig fordi den gjør det mulig med flere aritmetiske enheter, minne og interkonnektiviteter. Men praktisk fremgang avhenger også av arkitektur, numerisk presisjon, pakking, minnebåndbredde, algoritmer, programvare, energi, produksjonsutbytte og mengden nyttige data.
Viktige punkter
- Moores opprinnelige artikkel fra 1965 beskrev en økonomisk og teknisk trend, ikke en fysisk garanti.
- Skaleringen av klokkefrekvensen har avtatt; moderne gevinster kommer i økende grad fra parallellitet og spesialiserte akseleratorer.
- AI-ytelse er ofte begrenset av minnebevegelser og energi, ikke kun aritmetikk.
- Sammenlign systemer med arbeidsbelastningsnivåets latenstid, gjennomstrømning, kvalitet, strømforbruk og total kostnad – ikke transistortellingen.
Hva Moore faktisk observerte
Gordon Moore plottet antall komponenter i ledende integrerte kretser og projiserte fortsatt rask vekst med minimal kostnad per komponent. Frekvensen ble senere ofte oppsummert som en fordobling omtrent hvert andre år, men formuleringer og målte størrelser har variert.
Mindre strukturer kan øke tettheten og redusere noen byttekostnader, men produksjonskompleksitet og økonomi avgjør om trenden fortsatt er nyttig. Nodnavn er markedsføringsetiketter, og bør derfor ikke behandles som en direkte fysisk sammenligning på tvers av fabrikkprosesser.
Fra raskere kjerner til heterogen databehandling
Dennard‑lignende spenningsskalering tillot en gang høyere klokkehastigheter uten proporsjonal strømøkning, men dette forholdet svekket. Designerne gikk over til fler‑kjerne‑CPU‑er, GPU‑er, tensor‑enheter, chiplet‑er, avansert pakking og domene‑spesifikke akseleratorer.
Den heterogeniteten er sentral for dyp læring. Tette matriseoperasjoner kan kjøres effektivt på parallell maskinvare, mens CPU‑er koordinerer uregelmessig logikk og databevegelse. Den raskeste komponenten hjelper ikke hvis pipelinen ikke kan holde den forsynt.
Minne, presisjon og algoritmer
Trening og inferens flytter gjentatte ganger vekter, aktivasjoner og cache‑data gjennom et hierarki av på‑chip‑ og av‑chip‑minne. Båndbredde, kapasitet, lokalisering og kommunikasjon kan dominere kostnadene. Lavere numerisk presisjon og kvantisering reduserer bevegelse når kvaliteten fortsatt er akseptabel.
Algoritmiske forbedringer kan redusere beregningene som trengs for å nå et målet. Sparsomme modeller, transformer-effektivitetsmetoder, bedre optimaliserere og høyere‑kvalitetsdata påvirker alle den faktiske fremgangen brukerne opplever.
Hvordan sammenligne AI‑maskinvare
Maksimale operasjoner per sekund er teoretiske. Bruk en representativ modell, batch‑størrelse, sekvenslengde, presisjon, programvare‑stabel og kvalitetsterskel. Rapporter ende‑til‑ende‑latens, gjennomstrømning, energi, minnebruk, utnyttelse og kostnad.
Edge‑systemer kan verdsette personvern og lavt strømforbruk mer enn maksimal gjennomstrømning; datasentre kan prioritere totale token‑ eller prøver per watt. Edge‑AI gjør tydelig hvorfor ett overskrifts‑tall ikke kan beskrive hvert nyttig system.
Hvorfor halvleder‑skalering endret seg
Tidlig fremgang innen integrerte kretser kombinerte mindre enheter, bedre produksjon, lavere kostnad per komponent og designforbedringer. I flere år støttet reduserte transistordimensjoner også raskere switching og lavere energi per operasjon. Til slutt svekket lekkasje, spenningsgrenser, varmetetthet, interkonnekttid og produksjonskostnad den enkle sammenhengen mellom en ny prosessnode og raskere generelle kjerner.
Moderne fremgang er derfor multidimensjonal. FinFET‑ og gate‑all‑around‑enheter forbedrer elektrostatisk kontroll; ekstrem‑ultraviolet litografi støtter mindre mønstre; chiplet‑er lar designere kombinere die‑er laget med ulike prosesser; avansert pakking plasserer beregning og minne nærmere hverandre. Utbytte og pakking avgjør om et teknisk imponerende design er økonomisk i stor skala.
Nedgangen i én skaleringmekanisme betyr ikke at maskinvaren sluttet å forbedre seg. Det betyr at arkitekter må bruke transistorer mer bevisst. Spesialiserte enheter bytter fleksibilitet mot gjennomstrømning eller effektivitet på utvalgte arbeidsbelastninger, mens større cache‑er og interkonnekter prøver å holde disse enhetene forsynt.
Hvordan AI‑arbeidsbelastninger belaster maskinvare
Trening veksler mellom fremover‑beregning, tilbake‑propagering, optimaliserer‑oppdateringer og kommunikasjon over akseleratorer. Inferens spenner fra batch‑vurdering til interaktiv token‑generering. Matrisesmultiplikasjon er viktig, men innbygginger, normalisering, aktiveringsfunksjoner, oppmerksomhet, ruting, cache‑tilgang og verts‑orchestrering bidrar alle til reell ytelse.
Aritmetisk intensitet – mengden beregning utført per flyttet byte – hjelper med å forklare om en arbeidsbelastning er beregnings‑ eller båndbredde‑begrenset. Små batch‑størrelser og autoregressiv dekoding etterlater ofte aritmetiske enheter underutnyttet fordi vekter eller cache‑data må hentes gjentatte ganger. Større batch‑er forbedrer utnyttelsen, men øker latens og minnebruk.
Numerisk format endrer avveiningen. FP32, BF16, FP16, FP8 og heltallsformater varierer i rekkevidde, presisjon, maskinvarestøtte og feil. Blandings‑presisjonstrening bevarer sensitive operasjoner med høyere presisjon; kvantisert inferens krever kalibrering og kvalitetstesting i stedet for et løfte om at hver modell tolererer samme bit‑bredde.
Systemøkonomi og fremtidige retninger
Total AI‑kostnad inkluderer kjøp eller leie av akseleratorer, strømforsyning, kjøling, nettverk, lagring, programvareutvikling, inaktiv kapasitet og mislykkede eksperimenter. En raskere chip kan koste mer samlet dersom utnyttelsen er dårlig eller modellen krever en kostbar distribuert topologi. Mål nyttig output ved en definert kvalitetsterskel.
Skalering er også begrenset av data og algoritmer. Mer beregning kan ikke reparere feilmerkede data eller en evaluering som belønner snarveier. Effektiv oppmerksomhet, bedre optimaliserere, sparsitet, gjenfinning, destillasjon og algoritmiske oppdagelser kan forbedre resultater uten en proporsjonal maskinvareøkning, selv om de kan flytte kostnader andre steder.
Fremtidige systemer vil blande prosess‑fremskritt med tredimensjonal stabling, høy‑båndbredde‑minne, optiske eller avanserte elektriske interkonnekter, domene‑spesifikk dataflyt og sam‑designet programvare. Moores lov forblir en verdifull historisk kontekst, men planlegging bør bruke målte arbeidsbelastningskurver og realistiske forsynings‑, energi‑ og implementasjonsbegrensninger.
Å lese Moores lov korrekt i en AI‑systemdesign
En nyttig analyse skiller transistordensitet, generelle CPU‑ytelser, akselerator‑gjennomstrømning, minnekapasitet, minnebåndbredde, interkonnekter, energi, produksjonsutbytte og kostnad. Disse forbedres ikke i samme tempo. En AI‑arbeidsbelastning dominert av flytting av modellvekter kan få liten gevinst fra flere aritmetiske enheter, mens en liten på‑chip‑modell kan dra betydelig nytte av spesialisert lav‑presisjon‑maskinvare. Siter den eksakte metrikken, presisjonen, arbeidsbelastningen og strøm‑omslaget i stedet for å behandle en prosessnode som ytelse.
Skalering av en AI‑modell endrer også programvare‑ og systemkrav. Større treningskjøringer trenger parallelle algoritmer, pålitelig sjekkpunkt‑lagring, høyhastighets‑nettverk, lagrings‑pipelines og nok data til å utnytte ekstra kapasitet. Ved inferens avhenger latensen av prompt‑lengde, genererte token, batch‑størrelse, cache‑minne og servicenivå‑mål. Algoritmiske forbedringer, sparsitet, kvantisering, gjenfinning og bedre data kan gi gevinster som er uavhengige av transistor‑trender og noen ganger overgår en maskinvare‑generasjon.
For planlegging, benchmark representasjonsmodeller på kandidat‑systemer og modeller total kostnad over distribusjons‑livssyklusen: anskaffelse eller sky‑pris, strøm, kjøling, utnyttelse, ingeniørarbeid, migrasjon og leverandør‑risiko. Bruk scenarier i stedet for én eksponentiell prognose. Moores lov forblir en verdifull historisk observasjon om integrasjonsøkonomi, men den garanterer ikke at AI blir proporsjonalt raskere, billigere, mer kapabel eller mer bærekraftig på en fast tidsplan.
Praktisk implementeringssjekkliste
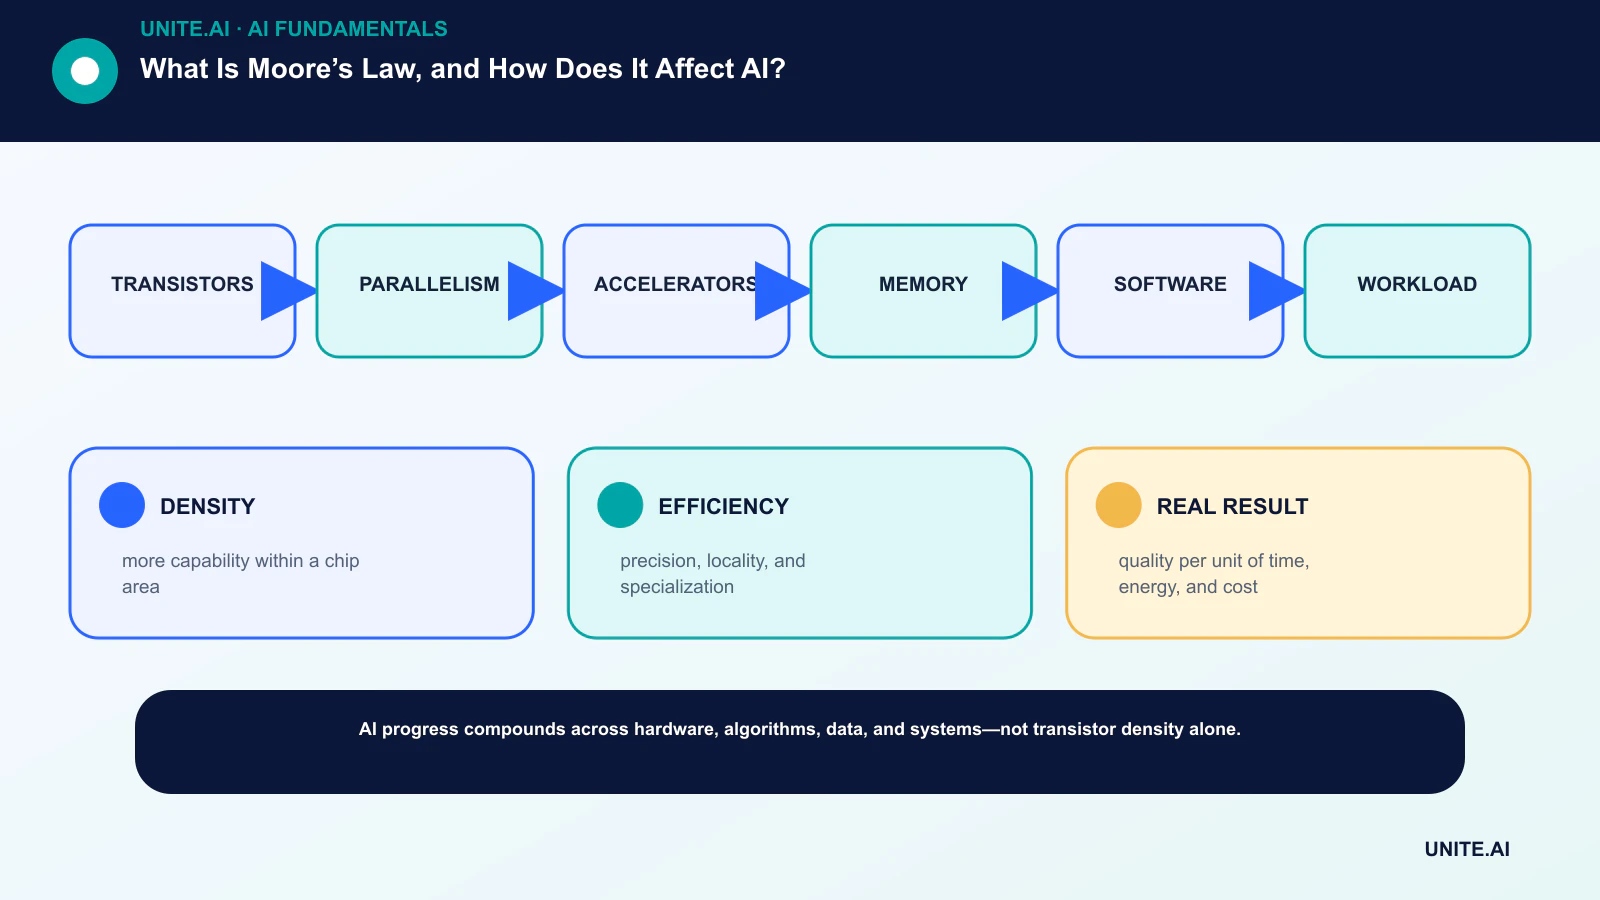
Gjør konseptet til en avgrenset, testbar arbeidsflyt: transistorer → parallellitet → akseleratorer → minne → programvare → arbeidsbelastning. Navngi en ansvarlig eier, dokumenter data og avhengigheter, etabler en enkel basislinje, sett aksept‑ og stoppkriterier, test representative feil, og definer overvåking, tilbakeføring og gjennomgang før omfanget utvides. Registrer versjoner og forutsetninger slik at et annet team kan gjenskape resultatet og forstå hva som har endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med personene som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighetsfeil og misbruk; bevar bevis og uløste risikoer. Definer hvem som kan godkjenne utgivelse, endre en terskel, overstyre et resultat eller stoppe driften. Revurder beslutningen etter at virkelige data kommer, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- TETTHET: mer kapasitet innen et chip‑område.
- EFFISIENS: presisjon, lokalisering og spesialisering.
- REELT RESULTAT: kvalitet per tidsenhet, energi og kostnad.
Ofte stilte spørsmål
Er Moores lov over?
Den enkle historiske trenden har avtatt og endret karakter, men fremgangen innen halvledere fortsetter gjennom enheter, arkitektur, pakking, minne og programvare. Om uttrykket fortsatt passer avhenger av måleparameteren.
Betyr dobbelt så mange transistorer dobbelt AI‑ytelse?
Nei. Ytelsen avhenger av hvordan transistorer brukes og av båndbredde, presisjon, modellstruktur, programvare‑effektivitet, strømforbruk og arbeidsbelastningsbegrensninger.
Primære referanser