
Grunnleggende AI
Hva er en NPU? Nevrale prosesseringsenheter forklart

 Legg til Unite.AI blant dine foretrukne kilder på Google
En nevrale prosesseringsenhet (NPU) er en spesialisert akselerator designet for å utføre vanlige nevrale nettverksoperasjoner effektivt. I telefoner, PC‑er, kjøretøy, kameraer og innebygde systemer kan den kjøre støttede AI‑arbeidsbelastninger med lavere energiforbruk eller frigjøre CPU‑en og GPU‑en for andre oppgaver.
NPU er et bredt industribegrep snarere enn én universell arkitektur. Ytelsen avhenger av støttede operatorer, numeriske formater, minne, kompilator og kjøretid, termiske begrensninger, og hvor mye av en applikasjon som kan forbli på akseleratoren.
Viktige punkter
- NPU‑er fokuserer på matrise-, vektor- og tensoroperasjoner med høy datagjenvinning og lavt strømforbruk.
- Maksimalt TOPS er ikke en ende‑til‑ende‑applikasjonsbenchmark og kan forutsette en bestemt presisjon eller sparsitet.
- En modell kan kreve konvertering, kvantisering, grafpartisjonering og fallback for operasjoner som ikke støttes.
- Sammenlign latenstid, gjennomstrømning, energi, minne, kvalitet, personvern og portabilitet på den faktiske arbeidsbelastningen.
CPU‑, GPU‑ og NPU‑roller
CPU‑er utmerker seg i generell kontrollflyt og bred kompatibilitet. GPU‑er gir programmerbar parallell gjennomstrømning og store programvareøkosystemer. NPU‑er er spesialiserte på gjentatte tensoroperasjoner og kan inkludere lokalt minne, multipliser‑akkumuler‑arrayer og dataflyt optimalisert for inferens.
Heterogene systemer planlegger ulike deler der de passer best. Dette er viktig for edge AI, hvor vedvarende strømforbruk og respons kan være viktigere enn maksimal datasenter‑gjennomstrømning.
Modellkompilering og -utførelse
En rammeverksgraf konverteres til en mellomrepresentasjon, optimaliseres, kvantiseres der det er hensiktsmessig, og kompileres for støttede operatorer. Kjøretiden kan partisjonere grafen slik at ikke‑støttede lag kjører på CPU eller GPU.
Overføringer mellom prosessorer kan oppheve akseleratorfordeler. Statiske former, layout, presisjon, batch‑størrelser og minnegjenvinning påvirker ytelsen. Test det kompilerte artefaktet fordi deep‑learning-modellkvaliteten kan endres etter konvertering.
Forstå TOPS‑ og effektivitetspåstander
TOPS angir billioner av operasjoner per sekund under definerte forutsetninger. Leverandører kan telle multiplikasjon og addisjon separat, bruke lav‑bit heltalls‑presisjon, eller anta sparsitet. Et høyere tall garanterer ikke lavere latenstid for en bestemt modell.
Mål kald og varm oppstart, per‑spørrings‑latenstid, gjennomstrømning, energi, maksimal minnebruk, termisk throttling, støttet kontekst‑ eller bildestørrelse, og andelen av grafen som er akselerert. Bruk tilsvarende nøyaktighet og programvareversjoner.
AI‑trade‑offs på enheten
Lokal utførelse kan redusere nettverksavhengighet og holde rådata på enheten, men nedlastede modeller, logger, sikkerhetskopier og sky‑fallback‑løsninger skaper fortsatt dataflyt. Sikker modelllevering og plattformoppdateringer er fortsatt nødvendige.
NPU‑er kan støtte visjons-, lyd-, språk- og sensorapplikasjoner, inkludert TinyML-relaterte arbeidsbelastninger. Utviklere bør designe elegante fallback‑mekanismer og informere når behandlingen forlater enheten.
NPU‑arkitektur og støttede operasjoner
En NPU akselererer tensoroperasjoner ved å bruke matriser av multipliser‑akkumuler‑enheter, lokalt minne, datafly‑planlegging og spesialiserte numeriske formater. Å holde vekter og aktivasjoner nær beregningen reduserer kostbar databevegelse. Reelle enheter varierer i operatortilgjengelighet, minnehierarki, presisjon, sparsitet, programmerbarhet, og hvordan arbeidet deles med CPU og GPU.
Maksimal ytelse annonseres ofte i TOPS, men TOPS angir ikke presisjon, utnyttelse, minnebegrensninger, operatordekning eller ende‑til‑ende‑latenstid. To prosessorer med samme overskrifts‑tall kan prestere ulikt på samme modell. Benchmark den kompilerte modellen, realistiske batch‑ og sekvensstørrelser, forhåndsbehandling, overføringer og strømmodus.
NPU‑er er effektive for støttede nevrale arbeidsbelastninger som visjon, tale, støydemping, bakgrunnseffekter og kompakte språkmodeller. Ikke‑støttede operatorer kan falle tilbake til CPU eller GPU, noe som skaper overføringer og uforutsigbar latenstid. Undersøk kompilatorrapporter og kjøretidsspor for å bekrefte plassering i stedet for å anta at hele grafen bruker akseleratoren.
Modellkonvertering, kvantisering og distribusjon
Distribusjon går vanligvis fra et treningsrammeverk gjennom eksport, grafoptimalisering, kvantisering, leverandørkompilering og kjøretidsintegrasjon. Statiske former og vanlige operatorer er lettest å akselerere. Dynamisk kontrollflyt, tilpassede kjerner, store mellomliggende tensorer, og ikke‑støttet normalisering eller oppmerksomhetsmønstre kan kreve grafendringer eller hybrid‑utførelse.
Heltall‑ og lav‑presisjonsformater reduserer modellstørrelse, båndbredde, energi og latenstid, men kalibreringsdata må representere reelle innganger. Sammenlign post‑training‑kvantisering med kvantisering‑bevisst trening når kvaliteten er sensitiv. Evaluer per‑klasse‑ og verst‑tilfelle‑atferd fordi gjennomsnittlig nøyaktighet kan skjule forverring i sjeldne eller sikkerhetskritiske tilfeller.
Inferens på enheten forbedrer latenstid, offline‑operasjon og personvern ved å begrense datatransfer, men enheten trenger fortsatt sikre modeller, tillatelsesbevisst data‑tilgang og oppdateringsmekanismer. Beskytt modellfilene der det er hensiktsmessig, signer oppdateringer, opplys om sky‑fallback, og sørg for at telemetrien ikke gjeninnfører den personvernrisikoen den lokale arkitekturen skulle redusere.
Ytelsesvurdering og systemnivå‑trade‑offs
Mål kald‑start‑ og steady‑state‑latenstid, gjennomstrømning, energi per inferens, minne, termisk oppførsel, nøyaktighet og batteri‑påvirkning. Lange tester avdekker throttling som korte benchmark‑tester går glipp av. Inkluder forhånds‑ og etterbehandling fordi endring av størrelse, tokenisering, dekoding eller datakopiering kan dominere en ellers rask akselerator.
Planlegging er et systemproblem. CPU‑en håndterer applikasjonslogikk, GPU‑en kan gjengi eller kjøre ikke‑støttede lag, og NPU‑en kjører kompatible grafer. Samtidige kamera‑, lyd‑, skjerm‑ og AI‑arbeidsbelastninger konkurrerer om minnebåndbredde og strøm. Test det komplette brukerscenarioet i stedet for en isolert modell i et leverandørverktøy.
Portabilitet forblir begrenset på tvers av kompilatorer og kjøretider. Foretrekk standard modellrepresentasjoner der de fungerer, isoler leverandørspesifikk kode bak grensesnitt, bevar referanseutdata, og oppretthold enhetstestdekning. Velg maskinvare basert på validerte arbeidsbelastninger, programvarestøtte, oppdateringshorisont og total systemkostnad – ikke kun én akseleratorspesifikasjon.
Arbeidseksempel: distribuere en visjonsmodell til en NPU‑laptop
Et team trener en segmenteringsmodell for bakgrunnseffekter, eksporterer den til et støttet utvekslingsformat, erstatter ikke‑støttede operatorer, og kalibrerer heltalls‑kvantisering med representative kameraer, belysning, hudtoner, klær og bakgrunner. Leverandørkompilatoren rapporterer hvilke noder som kjører på NPU‑en og hvilke som faller tilbake. Teamet behandler enhver fallback‑overgang som en systemkostnad, fordi tensor‑overføringer kan dominere en rask individuell kjerne.
Benchmarking måler kameraforbehandling, modellkjøring, sammensetting, minne, kald start, steady‑state‑latenstid, bildestabilitet, strømforbruk og termisk throttling under en ekte videosamtale. Resultatene sammenlignes med CPU‑ og GPU‑veier ved lik utdata‑kvalitet. Applikasjonen bruker kapabilitetsdeteksjon og en testet fallback i stedet for å anta at akseleratoren finnes eller støtter samme graf etter en driver‑oppdatering.
Utgivelsestesting dekker enhetsmodeller, operativsystem‑ og driver‑versjoner, samtidige arbeidsbelastninger, batterimodus og feilaktig input. Modellpakker signeres og versjoneres; telemetrien registrerer ytelse og feil uten å samle unødvendig video. Produktet forklarer når behandlingen forblir på enheten og når sky‑funksjoner benyttes. NPU‑en får sin plass ved å forbedre den komplette opplevelsen under realistiske begrensninger, ikke ved å oppnå en isolert TOPS‑ eller kjernebenchmark.
Praktisk implementeringssjekkliste
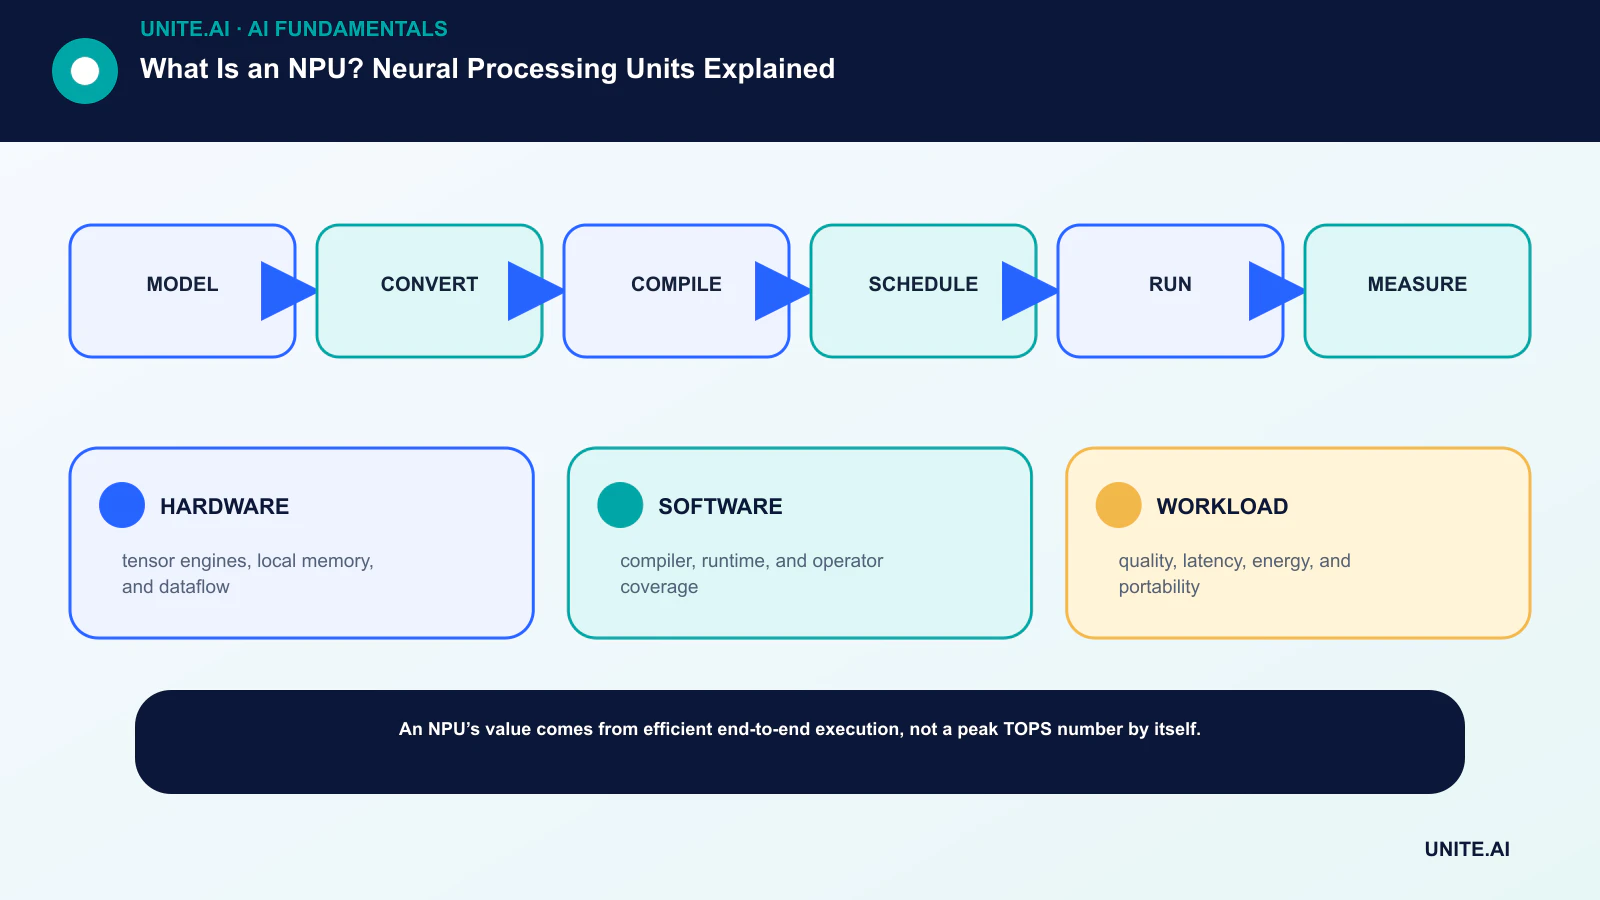
Omform konseptet til en avgrenset, testbar arbeidsflyt: modell → konverter → kompiler → planlegg → kjør → mål. Navngi en ansvarlig eier, dokumenter data og avhengigheter, etabler et enkelt grunnlag, sett aksept‑ og stoppkriterier, test representative feil, og definer overvåkning, tilbakeføring og gjennomgang før du utvider omfanget. Registrer versjoner og forutsetninger slik at et annet team kan gjenskape resultatet og forstå hva som har endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med personene som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighets‑feil og misbruk; bevar bevis og uløste risikoer. Definer hvem som kan godkjenne utgivelse, endre en terskel, overstyre et resultat eller stoppe driften. Revurder beslutningen når virkelige data kommer inn, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- MASKINVARE: tensor‑motorer, lokalt minne og dataflyt.
- PROGRAMVARE: kompilator, kjøretid og operatordekning.
- ARBEIDSBELASTNING: kvalitet, latenstid, energi og portabilitet.
Ofte stilte spørsmål
Er en NPU raskere enn en GPU?
Det avhenger av modellen, presisjon, operatorstøtte, batch‑størrelse, strømtak og programvare. En NPU kan være mer effektiv for en støttet arbeidsbelastning på enheten, mens en GPU er raskere eller mer fleksibel andre steder.
Holder en NPU all AI‑data privat?
Nei. Den muliggjør lokal behandling, men applikasjonen kan fortsatt sende data eller resultater til sky‑tjenester. Personvern avhenger av den komplette arkitekturen og policyen.
Primære referanser












