
Grunnleggende AI
Hva er mekanistisk tolkning? Hvordan forskere analyserer AI-modeller

 Legg til Unite.AI blant dine foretrukne kilder på Google
Mekanisisk tolkning studerer hvordan lærte komponenter i et nevralt nettverk kausalt produserer atferd. I stedet for kun å korrelere innganger med utganger, formulerer forskere hypoteser om funksjoner, oppmerksomhetshoder, nevroner og kretser, og intervenere for å teste disse hypotesene.
Feltet har produsert detaljerte forklaringer for utvalgte atferder i små og mellomstore modeller, men en fullstendig, trofast redegjørelse for en toppmoderne modell er fortsatt utenfor rekkevidde. Automatiserte forklaringer og attraktive visualiseringer kan være nyttige utgangspunkt, men ikke bevis.
Viktige punkter
- Funksjoner er representerte mønstre; kretser er samvirkende komponenter som foreslås for å implementere en beregning.
- Aktiveringspatching, ablasjon og kausal sporing tester om en komponent endrer en atferd.
- Superposisjon betyr at ett nevron kan delta i mange funksjoner; sparsomme autoenkodere forsøker en annen funksjonsbasis.
- Tolkingsmetoder trenger sannhetsgrunnlag, falsifiserbare tester, dekning og evaluering mot alternative forklaringer.
Fra representasjon til mekanisme
Undersøkelse spør om informasjon kan avkodes fra en aktivering. Tilskrivning estimerer hvilke innganger eller komponenter som er viktige. Mekanistisk arbeid går videre ved å foreslå en intern beregning og sjekke om intervensjoner endrer den forventede mellomliggende og endelige atferden.
Dette gjør det beslektet med, men snevrere enn forklarbar AI. En etterfølgende forklaring for én beslutning er ikke nødvendigvis en reversert algoritme inne i modellen.
Kretser og kausale intervensjoner
Forskere kan identifisere et oppmerksomhetshode eller en funksjon knyttet til en oppgave, ablatere det, patche aktiveringer fra en annen kjøring, eller spore hvordan informasjon beveger seg gjennom lag. En god hypotese forutsier atferd på nye eksempler og holder seg under kontroller.
Intervensjoner kan skape tilstander utenfor distribusjonen, så en atferdsendring avslører ikke automatisk den naturlige beregningen. Bruk flere metoder, matchede kontroller og kvantitative effekter i stedet for kun ett illustrerende prompt.
Superposisjon og sparsomme funksjoner
Nevrale nettverk kan representere flere funksjoner enn individuelle dimensjoner ved å superimponere dem. Et nevron kan derfor aktiveres for flere urelaterte mønstre, noe som gjør nevronnivå‑etiketter misvisende.
Sparsomme autoenkodere lærer et større ordtak av funksjoner fra modellens aktiveringer. De kan gjøre mønstre mer adskilte, men den valgte sparsiteten, treningsdataene, rekonstruksjonsfeilen og automatiserte etiketter påvirker hva som gjenopprettes. Funksjoner i nevrale nettverk krever fortsatt kausal validering.
Sikkerhet, feilsøking og begrensninger
Mekanistiske verktøy kan hjelpe med å finne lagrede fakta, skjevheter, villedende strategier eller sviktende kretser, og kan støtte redigering eller overvåking. De samme verktøyene kan gå glipp av distribuerte, sjeldne eller kontekstavhengige beregninger.
Behandle funn som avgrenset bevis: modellversjon, oppgave, datasett, lag, intervensjon, effekt og usikkerhet. Koble tolkning til atferdsevalueringer, red‑team‑arbeid og ansvarlig‑AI‑styring i stedet for å bruke det som et generelt sikkerhetssertifikat.
Representasjoner, kretser og kausal evidens
Mekanisisk tolkning studerer hvordan interne beregninger produserer modellens atferd. Forskere inspiserer aktiveringer, vekter, oppmerksomhet og mellomliggende funksjoner, og danner hypoteser om representasjoner og kretser. En representasjon er ikke nødvendigvis lagret i ett nevron; den kan være distribuert over retninger, lag, token og kontekstavhengige kombinasjoner.
Sparsomme autoenkodere forsøker å dekomponere tette aktiveringer til et større sett av funksjoner som aktiveres selektivt. Funksjonsetiketter er menneskelige tolkninger av observerte eksempler, ikke sannhetsgrunnlag. Rekonstruksjonsfeil, sparsitet, funksjonsdeling, absorpsjon og døde funksjoner påvirker hva dekomponeringen avdekker og hva den går glipp av.
Korrelasjon er utilstrekkelig for en mekanistisk påstand. Aktiveringspatching, ablasjon, kausal sporing, styring og målrettede vektintervensjoner tester om en komponent endrer atferd som forutsagt. Intervensjoner kan også skape tilstander utenfor distribusjonen, så resultater trenger kontroller, dose‑respons‑analyse, alternative forklaringer og replikasjon på tvers av prompt og modeller.
En grundig tolkingsarbeidsflyt
Start med en presist målt atferd og et datasett som skiller konkurrerende hypoteser. Lokalisér relevante lag, posisjoner, komponenter eller funksjoner; inspiser kandidatmekanismer; intervenér; og test om den foreslåtte kretsen forutsier nye tilfeller. Hold utforskende eksempler adskilt fra bekreftende evaluering for å redusere seleksjonsbias.
Automatiserte verktøy kan rangere nevroner, funksjoner, hoder eller stier, mens språkmodeller kan foreslå beskrivelser. Automatisering øker dekning, men kan konstruere plausible historier. Vurder forklaringer på hold‑out‑aktiverings‑eksempler og kausale prediksjoner, registrer usikkerhet, og gjør artefakter reproduserbare med modellversjon, tokeniserer, prompt og kode.
Mekanismer kan være polysemantiske, redundante, ikke‑lineære og distribuerte. Fjerning av én komponent kan kompenseres av andre, mens en funksjon kan delta i flere atferder. Negative funn er informative: en tilsynelatende krets som feiler utenfor kuraterte eksempler bør innskrenkes eller avvises i stedet for å bli reddet med en stadig vagere forklaring.
Applikasjoner, begrensninger og sikkerhetspåstander
Tolkning kan hjelpe med å feilsøke hallusinasjoner, skjevheter, memorering, jailbreak‑atferd eller uventet generalisering; sammenligne modeller; og generere vitenskapelige hypoteser. Den kan også identifisere funksjoner for overvåking eller intervensjon. Disse bruksområdene krever oppgavespesifikk validering fordi en nyttig forskningsvisualisering ikke automatisk er en pålitelig produksjonskontroll.
Fravær av en oppdaget funksjon beviser ikke fravær av en evne eller intensjon, og en lesbar funksjon beviser ikke at modellen bruker den i et gitt svar. Verktøy observerer en projeksjon av beregning med begrenset dekning. Sikkerhetspåstander må spesifisere deteksjonsfølsomhet, falske positiver, distribusjon, motstander og kjente blindsoner.
Bruk tolkning sammen med atferdsevalueringer, red‑team‑arbeid, datastyring, tilgangskontroller, overvåking og hendelsesrespons. Publiser metoder og moteksempler når mulig. Feltet utvikler seg raskt, men nåværende teknikker gir ikke en fullstendig, trofast forklaring på grensemodellens resonnering eller en generell garanti for samsvar.
Arbeidseksempel: testing av foreslått modellkrets
Anta at en modell ser ut til å bruke et sett med oppmerksomhetshoder og funksjoner for å løse et indirekte objekt i en setning. Forskere definerer et kontrollert datasett med varierte navn, posisjoner, distraktorer og moteksempler, og måler deretter atferden. Aktiveringsinspeksjon identifiserer kandidatkomponenter, men hypotesen er skrevet før intervensjon: hvilken informasjon hver komponent bærer, hvor den beveger seg, og hvordan endring av den skal endre output.
Aktiveringspatching og ablasjon tester nødvendighet og tilstrekkelighet på tvers av hold‑out‑eksempler. En målrettet redigering som endrer den predikerte tokenen i forventet retning støtter mekanismen; bred ytelsesnedgang gjør det ikke. Kontroller patche urelaterte posisjoner og komponenter, varierer intervensjonsstyrke, og sammenligner alternative kretser. Teamet publiserer negative tilfeller der forklaringen feiler og unngår å tildele et menneskelig lesbart formål kun basert på korrelasjon.
For å hevde en sikkerhetsapplikasjon må metoden oppdage den relevante atferden med kjent følsomhet under realistiske prompt og adversarial tilpasning. Funksjonsmonitorer evalueres for falske positiver, omgåelse, modelloppdateringer og kausal relevans. Tolkingsbevis kan veilede feilsøking og videre tester, men håndheving forblir i eksterne kontroller og atferdsmonitorering. Et overbevisende kretsdiagram er en vitenskapelig hypotese med bevis – ikke en fullstendig forklaring på en modell eller en garanti for usett atferd.
Praktisk implementeringssjekkliste
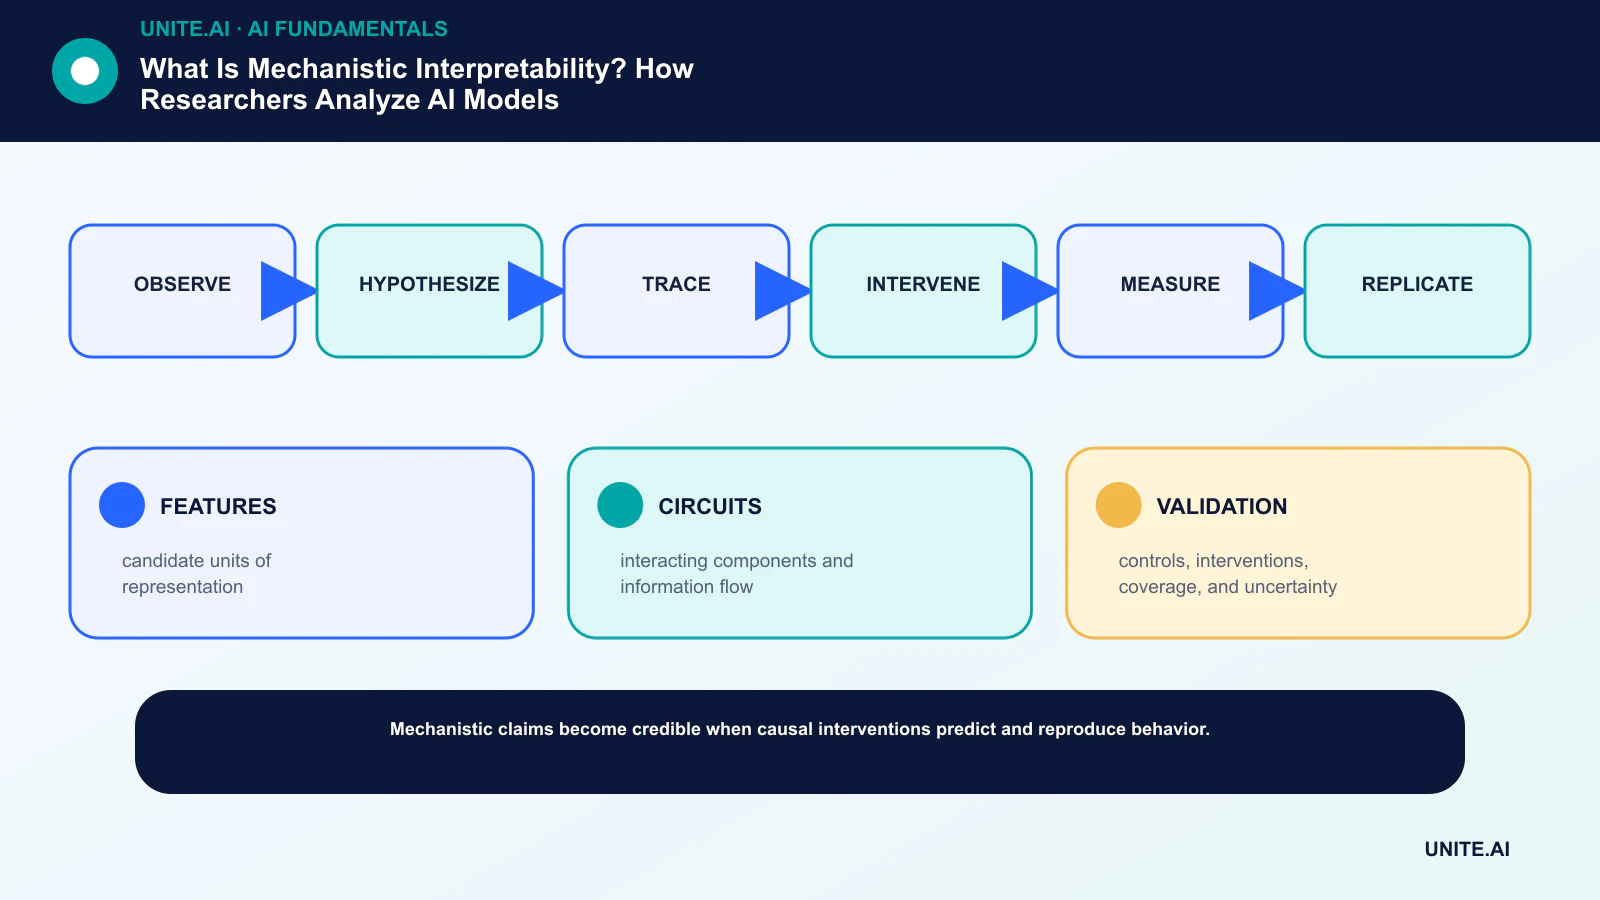
Gjør konseptet til en avgrenset, testbar arbeidsflyt: observer → hypotesiser → spor → intervenér → mål → repliker. Navngi en ansvarlig eier, dokumenter data og avhengigheter, etabler en enkel basislinje, sett aksept‑ og stoppkriterier, test representative feil, og definer overvåking, tilbakeføring og gjennomgang før du utvider omfanget. Registrer versjoner og forutsetninger slik at et annet team kan reprodusere resultatet og forstå hva som endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med personene som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighetsfeil og misbruk; bevar bevisene og uavklarte risikoer. Definer hvem som kan godkjenne utgivelse, endre en terskel, overstyre en output eller stoppe driften. Gå gjennom beslutningen på nytt etter at virkelige data kommer inn, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- FUNKSJONER: kandidat‑enheter for representasjon.
- KRETSE: samvirkende komponenter og informasjonsflyt.
- VALIDERING: kontroller, intervensjoner, dekning og usikkerhet.
Ofte stilte spørsmål
Er mekanistisk tolkning det samme som å lese modellvekter?
Nei. Råvekter er ikke selvforklarende. Forskere analyserer aktiveringer, funksjoner, komponenter og intervensjoner for å bygge og teste kausale hypoteser.
Kan sparsomme autoenkodere fullt ut forklare en LLM?
Nei. De gir en kandidatfunksjonsbasis og kan støtte kretsanalyse, men dekning, trofasthet, rekonstruksjon, merking og skalerbarhet er fortsatt åpne problemer.
Primære referanser












