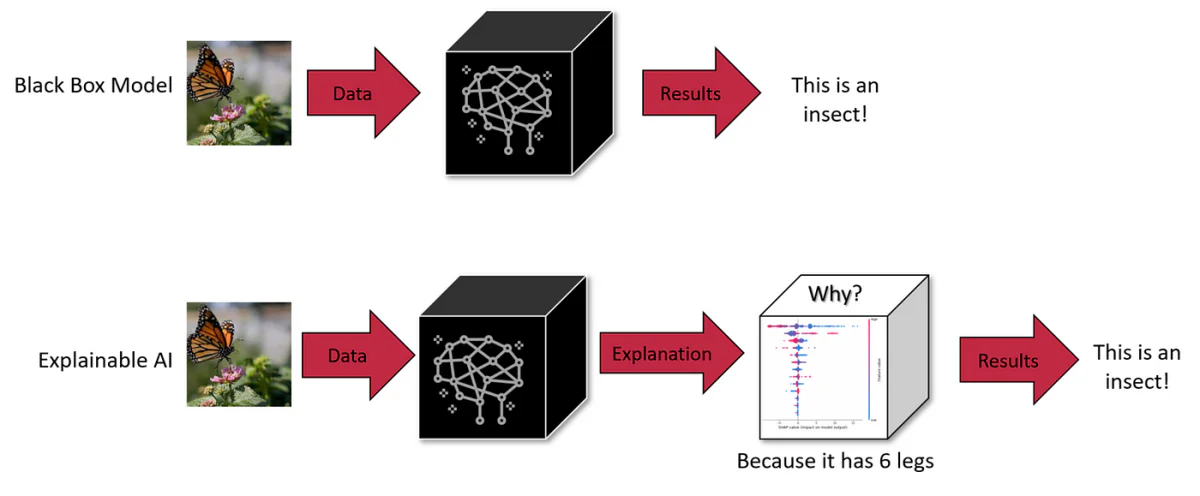
Maskinlæring, en undergruppe av AI, består av tre komponenter: algoritmer, treningsdata og den resulterende modellen. En algoritme, i virkeligheten en samling av prosedyrer, lærer å identifisere mønster fra et stort sett med eksempler (treningsdata). Kulminasjonen av denne treningsprosessen er en maskinlæringsmodell. For eksempel ville en algoritme trenet med bilder av hunder resultere i en modell i stand til å identifisere hunder på bilder.
Det svarte boks i maskinlæring
I maskinlæring kan noen av de tre komponentene – algoritme, treningsdata eller modell – være en svart boks. Mens algoritmer ofte er offentlig kjent, kan utviklere velge å holde modellen eller treningsdataene hemmelige for å beskytte immaterielle rettigheter. Denne uklarheten gjør det vanskelig å forstå AIens beslutningsprosess.
AI-svarte bokser er systemer der de indre arbeidene forblir uklare eller usynlige for brukerne. Brukere kan innføre data og motta utdata, men logikken eller koden som produserer utdataene forblir skjult. Dette er en vanlig karakteristikk i mange AI-systemer, inkludert avanserte generative modeller som ChatGPT og DALL-E 3.
LLM’er som GPT-4 presenterer en betydelig utfordring: deres indre arbeid er i stor grad uklart, noe som gjør dem til “svarte bokser”. Slik uklarhet er ikke bare et teknisk puslespill; det stiller reelle sikkerhets- og etiske bekymringer. For eksempel, hvis vi ikke kan avgjøre hvordan disse systemene når frem til konklusjoner, kan vi stole på dem i kritiske områder som medisinske diagnoser eller finansielle vurderinger?
Utforskning av teknikker for LIME og SHAP
Fortolkbarhet i maskinlæring (ML) og dyp læring (DL) hjelper oss å se inn i de uklare indre arbeidene i disse avanserte modellene. Lokale fortolkbare modell-uavhengige forklaringer (LIME) og SHapley-additive forklaringer (SHAP) er to slike mainstream-fortolkbarhetsteknikker.
Fortolkbarhet
LIME, for eksempel, bryter ned kompleksiteten ved å lage enklere, lokale surrogate-modeller som approksimerer oppførselen til den opprinnelige modellen rundt et bestemt innputt. Ved å gjøre dette, hjelper LIME med å forstå hvordan enkelte funksjoner påvirker forutsagnene til komplekse modeller, essensielt gir en ‘lokal’ forklaring for hvorfor en modell tok en bestemt beslutning. Det er spesielt nyttig for ikke-tekniske brukere, da det oversetter den intrikate beslutningsprosessen til modeller til mer forståelige termer.
Modell-uavhengig fortolkbarhet av maskinlæring (LIME) Kilde
SHAP, på den andre siden, tar inspirasjon fra spillteori, spesielt konseptet Shapley-verdier. Det tildeeler en ‘viktighet’-verdi til hver funksjon, som indikerer hvor mye hver funksjon bidrar til forskjellen mellom den faktiske forutsagnet og basisforutsagnet (gjennomsnittsforutsagnet over alle innputt). SHAPs styrke ligger i dens konsistens og evne til å gi en global perspektiv – det forklarer ikke bare enkelte forutsagn, men gir også innsikt i modellen som helhet. Dette er spesielt verdifullt i dyp læring-modeller, hvor de sammenkoblede lagene og tallrike parameterne ofte gjør forutsagnsprosessen til å se ut som en reise gjennom en labyrint. SHAP avmystifiserer dette ved å kvantifisere bidraget fra hver funksjon, og tilbyr en klarere kart over modellens beslutningsveier.
Både LIME og SHAP har oppstått som essensielle verktøy i området AI og ML, og de møter det kritiske behovet for transparens og tillit. Mens vi fortsetter å integrere AI dyptere i ulike sektorer, blir evnen til å tolke og forstå disse modellene ikke bare en teknisk nødvendighet, men en grunnleggende krav for etisk og ansvarlig AI-utvikling. Disse teknikker representerer betydelige skritt i å avdekke kompleksiteten i ML- og DL-modeller, og transformerer dem fra uforståelige ‘svarte bokser’ til forståelige systemer hvis beslutninger og atferd kan forstås, tillits og effektivt utnyttes.
Skalaen og kompleksiteten til LLM’er
Skalaen til disse modellene bidrar til deres kompleksitet. Ta GPT-3, for eksempel, med sine 175 milliarder parametre, og nyere modeller med billioner. Hver parameter samhandler på intrikate måter innenfor neuralt nettverk, og bidrar til emergente evner som ikke kan forutsies ved å undersøke enkeltkomponenter alene. Denne skalaen og kompleksiteten gjør det nesten umulig å fullstendig forstå deres indre logikk, og stiller en hindring i å diagnostisere fordommer eller uønskede atferd i disse modellene.
Kompromisset: Skala vs. fortolkbarhet
Å redusere skalaen til LLM’er kunne forbedre fortolkbarheten, men til en pris av deres avanserte evner. Skalaen er det som muliggjør atferd som mindre modeller ikke kan oppnå. Dette presenterer en innebygd kompromiss mellom skala, evne og fortolkbarhet.
Virkingen av LLM-svarteboksproblemet
1. Feilaktig beslutning
Uklarheten i beslutningsprosessen til LLM’er som GPT-3 eller BERT kan føre til uoppdagede fordommer og feil. I felt som helse eller strafferett, hvor beslutninger har langvarige konsekvenser, er evnen til å granske LLM’er for etisk og logisk gyldighet en stor bekymring. For eksempel kan en medisinsk diagnose LLM som baserer seg på foreldet eller fordomsfulle data gi skadelige anbefalinger. Liksom kan LLM’er i rekrutteringsprosesser utilsiktet videreføre kjønnsfordommer. Den svarte boks-naturen skjuler ikke bare feil, men kan potensielt forsterke dem, og krever en proaktiv tilnærming for å forbedre transparensen.
2. Begrenset tilpasning i ulike sammenhenger
Mangelen på innsikt i de indre arbeidene til LLM’er begrenser deres tilpasning. For eksempel kan en rekrutterings-LLM være ineffektiv i å vurdere kandidater for en rolle som verdsetter praktiske ferdigheter over akademiske kvalifikasjoner, på grunn av dens evne til å justere sine vurderingskriterier. Liksom kan en medisinsk LLM ha vanskeligheter med sjeldne sykdomsdiagnoser på grunn av data-ubalanser. Denne inflexibiliteten understreker behovet for transparens for å omkalibrere LLM’er for bestemte oppgaver og sammenhenger.
3. Fordommer og kunnskapsluker
LLM’ers prosessering av store treningsdata er underlagt begrensningene pålagt av deres algoritmer og modellarkitekturer. For eksempel kan en medisinsk LLM vise demografiske fordommer hvis den er trenet på ubalanserte datasamlinger. Dessuten kan en LLMs dyktighet i niche-emner være misvisende, og føre til overmodige, feilaktige utdata. Å håndtere disse fordommene og kunnskapslukene krever mer enn bare ekstra data; det krever en undersøkelse av modellens prosessmekanismer.
4. Juridisk og etisk ansvar
Den uklare naturen til LLM’er skaper en juridisk gråsone når det gjelder ansvar for skader forårsaket av deres beslutninger. Hvis en LLM i en medisinsk sammenheng gir feilaktige råd som fører til skade på pasienter, blir det vanskelig å bestemme ansvar på grunn av modellens uklarhet. Denne juridiske usikkerheten stiller risiko for enheter som setter i verk LLM’er i sensitive områder, og understreker behovet for tydelig styring og transparens.
5. Tillitsproblemer i sensitive anvendelser
For LLM’er brukt i kritiske områder som helse og finansielle tjenester, undergraver mangelen på transparens tilliten til disse modellene. Brukere og regulatorer må sikre at disse modellene ikke har fordommer eller tar beslutninger basert på urimelige kriterier. Å verifisere fraværet av fordommer i LLM’er krever en forståelse av deres beslutningsprosesser, og understreker viktigheten av forklarbarhet for etisk utvikling.
6. Risikoer med personlige data
LLM’er krever omfattende treningsdata, som kan inkludere sensitive personlige opplysninger. Den svarte boks-naturen til disse modellene stiller spørsmål om hvordan disse dataene prosesseres og brukes. For eksempel kan en medisinsk LLM trenet på pasientjournaler reise spørsmål om datavern og bruk. Å sikre at personlige data ikke misbrukes eller utnyttes krever transparente datahåndteringprosesser innenfor disse modellene.
Fremvoksende løsninger for fortolkbarhet
For å møte disse utfordringene utvikles nye teknikker. Disse inkluderer kontrafaktiske (CF) approksimasjonsmetoder. Den første metoden innebærer å be en LLM om å endre et bestemt tekstkonsept mens andre konsepter holdes konstant. Denne tilnærmingen, selv om den er effektiv, er ressurskrevende på inferenstid.
Den andre tilnærmingen innebærer å lage et dedikert innleggelsesrom styrt av en LLM under trening. Dette rommet sammenfaller med en kausal graf og hjelper med å identifisere sammenfall som approksimerer CF-er. Denne metoden krever færre ressurser på testtid og har vist seg å kunne forklare modellforutsagn effektivt, selv i LLM’er med billioner av parametre.
Disse tilnærmingene understreker viktigheten av kausale forklaringer i NLP-systemer for å sikre sikkerhet og etablere tillit. Kontrafaktiske approksimasjoner gir en måte å forestille seg hvordan en gitt tekst ville endre seg hvis et bestemt konsept i dens generative prosess var annerledes, og hjelper med å estimere kausale effekter av høyere konsepter på NLP-modeller.
Dykk ned: Forklaringsmetoder og kausalitet i LLM’er
Prøving og funksjonsviktighet-verktøy
Prøving er en teknikk brukt til å avkode hva indre representasjoner i modeller koder. Den kan være enten overvåket eller uovervåket og er rettet mot å bestemme om bestemte konsepter er kodet på bestemte steder i et nettverk. Mens effektiv til en viss grad, mangler prøvinger i å gi kausale forklaringer, som Geiger et al. (2021) har understreket.
Funksjonsviktighet-verktøy, en annen form for forklaringsmetode, fokuserer ofte på innputt-funksjoner, selv om noen gradient-baserte metoder utvider dette til skjulte tilstander. Et eksempel er den integrerte gradient-metoden, som tilbyr en kausal tolkning ved å utforske baseline (kontrafaktiske, CF) innputt. Til tross for deres nytte, sliter disse metodene med å knytte sine analyser til virkelige konsepter utenfor enkle innputtegenskaper.
Intervensjonsbaserte metoder
Intervensjonsbaserte metoder innebærer å modifisere innputt eller indre representasjoner for å studere effekter på modellatferd. Disse metodene kan skape kontrafaktiske tilstander for å estimere kausale effekter, men de kan ofte generere uvirkelige innputt eller nettverkstilstander med mindre de kontrolleres nøye. Den kausale proxy-modellen (CPM), inspirert av S-learner-konseptet, er en ny tilnærming i dette området, og etterligner atferden til den forklarte modellen under kontrafaktiske innputt. Imidlertid er behovet for en distinkt forklarer for hver modell en betydelig begrensning.
Approksimering av kontrafaktiske
Kontrafaktiske er vidt brukt i maskinlæring for data-forbedring, og innebærer perturbasjoner til ulike faktorer eller etiketter. Disse kan genereres gjennom manuell redigering, heuristisk nøkkelord-erstatning eller automatisert tekst-omskriving. Mens manuell redigering er nøyaktig, er den også ressurskrevende. Nøkkelord-baserte metoder har begrensninger, og generative tilnærminger tilbyr en balanse mellom flyt og dekning.
Troverdige forklaringer
Troværdighet i forklaringer refererer til å avbilde den underliggende begrunnelsen til modellen nøyaktig. Det finnes ingen universelt akseptert definisjon av troverdighet, noe som fører til at den karakteriseres gjennom ulike metrikker som Sensitivitet, Konsistens, Funksjonsviktighet-samsvar, Robusthet og Simulering. De fleste av disse metodene fokuserer på funksjonsnivå-forklaringer og ofte forveksler korrelasjon med kausalitet. Vårt arbeid har som mål å tilby høy-nivå-konsept-forklaringer, og å utnytte kausalitetslitteraturen for å foreslå et intuitivt kriterium: Rekkefølge-troverdighet.
Vi har dykket ned i de innebygde kompleksitetene til LLM’er, og forstått deres ‘svarte boks’-natur og de betydelige utfordringene det stiller. Fra risikoen for feilaktig beslutning i sensitive områder som helse og finansielle tjenester til de etiske dilemmaer omkring fordommer og rettferdighet, har behovet for transparens i LLM’er aldri vært mer åpenbart.
Fremtiden til LLM’er og deres integrering i våre daglige liv og kritiske beslutningsprosesser henger av vår evne til å gjøre disse modellene ikke bare mer avanserte, men også mer forståelige og ansvarlige. Jakten på forklarbarhet og fortolkbarhet er ikke bare en teknisk bedrift, men en grunnleggende del av å bygge tillit til AI-systemer. Mens LLM’er blir mer integrert i samfunnet, vil kravet om transparens øke, ikke bare fra AI-utøvere, men fra hver enkelt bruker som interagerer med disse systemene.
Jeg har brukt de siste fem årene på å dykke ned i den fasiniserende verden av Maskinlæring og Dypt Læring. Min lidenskap og ekspertise har ledet meg til å bidra til over 50 ulike programvareprosjekter, med særlig fokus på AI/ML. Min pågående nysgjørhet har også trukket meg mot Naturlig Språkbehandling, et felt jeg er ivrig etter å utforske videre.


 Legg til Unite.AI blant dine foretrukne kilder på Google