
AIの基礎
ITオペレーション(ITOps)とは何ですか?

 Unite.AI を Google の優先ソースに追加
IT operations (ITOps) は、組織が依存する技術サービスを運用する作業です。コンピュート、ネットワーク、アイデンティティ、エンドポイント、クラウドプラットフォーム、データベース、ストレージ、バックアップ、およびそれらのコンポーネントを利用可能で安全かつサポート可能に保つ運用プロセスを含みます。
現代のITOpsは、ダッシュボードを監視するネットワークオペレーションセンターに限定されません。チームはソフトウェア定義インフラストラクチャ、プラットフォームサービス、Automation、分散所有権を管理しつつ、インシデント、容量、継続性、サービスレベルに対する責任を保持します。
主なポイント
- ITOpsは、オンプレミス、クラウド、エッジ環境全体でサービスとその依存関係を管理します。
- 可観測性、構成、インベントリは、障害を解釈するために必要なコンテキストを提供します。
- インシデント管理はサービスを復旧させ、問題管理は再発やシステム的な原因に対処します。
- ITOpsはITSM、SRE、DevOps、SecOps、AIOpsと重なる部分がありますが、いずれとも同一ではありません。
サービス、資産、構成
オペレーションは、どのサービスが存在し、誰が所有し、どのユーザーが依存し、どのインフラストラクチャが支えているかを把握することから始まります。資産インベントリはコンポーネントを記録し、構成管理は関連する関係性と管理された状態を記録します。
調整されないインベントリは誤解を招きます。有用な箇所では自動検出を行い、権威ある情報源を特定し、すべての依存関係マップが完全であると見なすのではなく、信頼度や鮮度を記録してください。
可観測性とサービス目標
メトリクスは挙動を数値化し、ログはイベントを記録し、トレースはサービス間の作業を追跡します。シンセティックチェックでユーザージャーニーをテストできます。有用な可観測性は質問とサービス目標から始まり、そこに答えるためのシグナルを収集します。
アラートは、タイムリーな対応が必要な条件を特定すべきです。ユーザーへの影響がない閾値はノイズを生み、依存関係のコンテキストが欠如すると診断が遅れます。AIOps は相関を支援できますが、信頼できるテレメトリと運用フィードバックが必要です。
インシデント、問題、変更管理
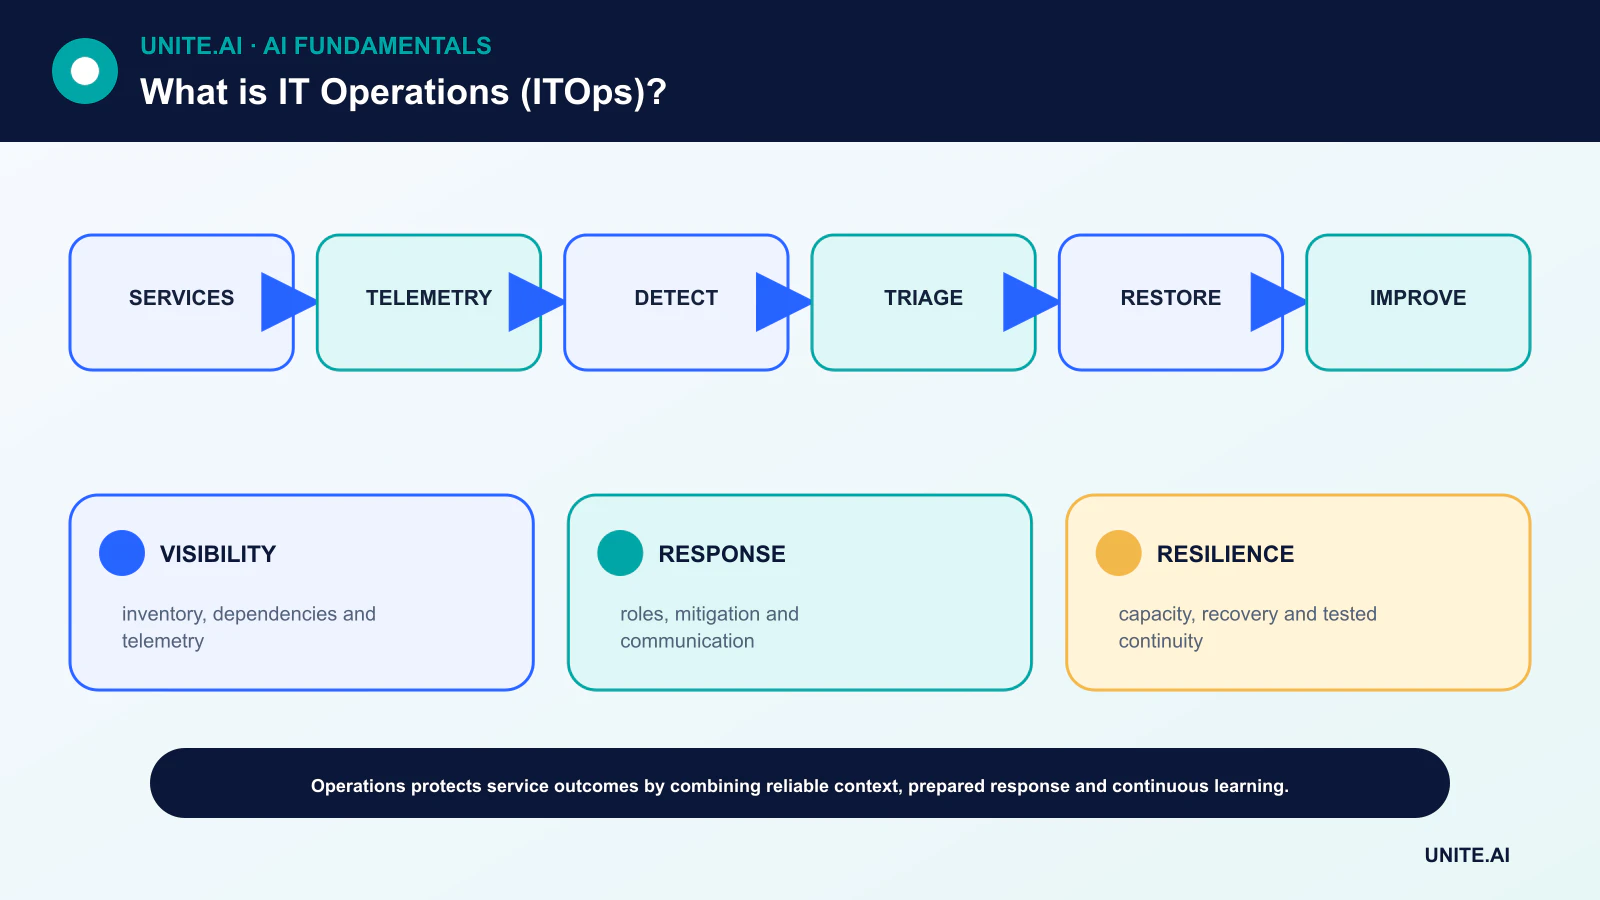
インシデント管理は、検知、トリアージ、緩和、コミュニケーション、復旧を調整します。明確な役割分担はプレッシャー下での混乱を減らします。一時的な回避策でサービスを復旧させ、後続の問題調査で根本原因に対処できます。
変更管理は、すべての変更をキュー化せずにリスクを評価・記録します。標準的で自動化された低リスクの変更は事前承認された手順に従えますが、高インパクトの変更はより強固な証拠、スケジューリング、ロールバックの準備が必要です。
容量、レジリエンス、継続性
チームはリソース需要を予測し、ボトルネックを除去し、負荷下での挙動をテストします。バックアップは復元テストが行われた場合にのみ有用です。冗長性は、障害モードが独立しており、フェイルオーバーが実際に機能する場合にのみ効果があります。
事業継続性は優先順位、復旧時間、許容できるデータ損失を定義します。アイデンティティ、DNS、クラウドコントロールプレーン、ベンダーへの依存は、利用可能と仮定せずに演習に組み込むべきです。
ITOps、ITSM、SRE、DevOps
ITサービスマネジメントは、サービスを組織のニーズに合わせるプロセスを提供します。サイト信頼性エンジニアリングはソフトウェアエンジニアリングを運用に適用し、サービスレベル目標とエラーバジェットを使用します。DevOps は開発と運用のフィードバックを結びつけます。
SecOps は脅威と対応に焦点を当て、ITOps はより広範なサービスヘルスを維持します。組織図は異なりますが、重要な要件は明示的な所有権とこれらの領域間で共有される証拠です。
ITOpsの運用モデル
ITオペレーションは、組織の技術サービスを利用可能で高性能かつ安全、かつ復旧可能な状態に保ちます。対象範囲は通常、エンドポイント、アイデンティティ、ネットワーク、サーバー、クラウド、ストレージ、コラボレーション、データベース、モニタリング、サービスデスク、バックアップ、ベンダーサービスを含みます。現代のITOpsは所有インフラとマネージドプラットフォームの両方にまたがるため、運用が外部委託されても責任は明示的である必要があります。構成またはサービスインベントリは、技術コンポーネントと所有者、ユーザー、依存関係、データ分類、事業重要度を結びつけます。
サービスマネジメントは、インシデント、リクエスト、問題、変更、資産、ナレッジ、サービスレベルを整理します。インシデント管理はサービスを復旧させ、問題管理は再発原因を調査し、変更有効化はリスクを評価・調整します。すべての変更を遅い承認プロセスにすると抜け道が生まれ、統制されない自動化は制御不能な障害を招きます。標準的な低リスク変更は事前承認と自動化が可能ですが、高リスク変更は証拠、コミュニケーション、ロールバック、インパクトに基づくスケジューリングが必要です。
信頼性、容量、継続性
モニタリングはデバイス数だけでなく、ユーザー向けサービスとその依存関係を追跡すべきです。可用性、レイテンシ、容量、鮮度、サポート目標を事業オーナーと共に定義します。実行可能な症状やエラーバジェットの消費に対してアラートを設定し、所有者情報や最近の変更でイベントを強化します。容量計画モデルは需要、飽和、ライセンス、リードタイムを考慮します。クラウドの弾力性はプロビジョニング遅延を減らしますが、クォータ、地域制限、コスト管理を排除するわけではありません。
事業継続性には、テスト済みのバックアップ、復元、アイデンティティ復旧、ネットワーク代替手段、ベンダー連絡先、手動手順が必要です。サービスごとに復旧時間目標(RTO)と復旧ポイント目標(RPO)を定義します。バックアップは復元・検証されるまで復旧の証拠とはなりません。ランサムウェア、リージョン喪失、期限切れ証明書、アイデンティティ障害、サプライヤー障害をリハーサルします。可能な限り構成とインフラをコードとして管理し、復旧が再現可能になるようにします。
セキュリティ、Automation、メトリクス
最小権限、パッチ・脆弱性管理、エンドポイント制御、ネットワーク分割、ロギング、インシデント対応を使用します。冪等性、上限、承認、監査を組み合わせて繰り返し作業を自動化します。サービスの可用性、インシデントの再発、リクエストの完了、変更失敗、復旧、パッチ適用状況、容量、コスト、ユーザー満足度を測定し、単なるチケットクローズだけに依存しません。ITOpsは、テクノロジーが作業を予測可能に支援し、障害から復旧できるときに成功とみなされ、インフラが忙しそうに見えるだけやダッシュボードに緑が多いだけでは成功とは言えません。
実例: コラボレーションサービスの復旧
ある企業は、コラボレーションプラットフォームに対して4時間の復旧時間目標(RTO)と1時間の復旧ポイント目標(RPO)を設定します。アイデンティティ、DNS、ネットワーク、データ、鍵、構成、統合、ベンダー依存関係をインベントリ化します。復旧演習では、プライマリリージョンと管理者アカウントが利用できないことを前提とします。オペレーターは独立して保護された緊急アイデンティティを有効化し、サービス構成とデータを隔離リージョンに復元し、権限、メッセージ、統合、クライアントアクセスを検証します。事業オーナーは、インフラのヘルスチェックだけに頼らず、実際のユーザージャーニーで復旧サービスを確認します。
演習では、実際のデータ損失、経過時間、手動手順、失敗した連絡先、隠れた依存関係が記録されます。ファイルは復元できても暗号鍵やアイデンティティポリシーが復元できないバックアップは不完全とみなされます。是正措置には所有者と日付が付与され、ランブックは更新・再テストされます。モニタリングとコミュニケーションのテンプレートも含まれます。組織はバックアップジョブの成功ではなく、復旧の証拠を測定し、信頼できるITOpsは実際の障害シナリオでユーザーが必要とするサービスを復元できなければならないことを認識します。
実装証拠と運用準備性
本番導入の判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力、出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、形式不正または欠損入力、分布シフト、依存障害、誤用、支援が不十分になりやすいグループや環境をテストします。タスク品質を校正や不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビュアーが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを使用し、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存ヘルス、人間の介入、確認済み結果を示すべきで、不要な機密データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューし、オフライン性能が継続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目標が変わるたびに再評価します。維持されたシステムは、文書化された復旧、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なポイントも必要です。
よくある質問
ITOps の主な目的は何ですか?
合意されたセキュリティ、パフォーマンス、継続性、コストの制約内で、信頼できる技術サービスを提供し、復旧することです。
クラウドインフラはクラウドプロバイダーが完全に運用していますか?
いいえ。プロバイダーは基盤プラットフォームの一部を運用しますが、構成、アイデンティティ、データ、ワークロード、モニタリング、そして多くのサービスレベルの決定は顧客の責任です。
主要参考文献












