
AIの基礎
インシデントオートメーションとは何か? ワークフロー、ガードレール、ユースケース

 Unite.AI を Google の優先ソースに追加
インシデントオートメーションは、ソフトウェアを使用して運用上またはセキュリティ上のインシデントを検知、情報付加、ルーティング、調整、場合によっては修復します。監視シグナルとランブック、チケットシステム、コミュニケーション、アクセス制御、復旧アクションを結び付けることで、対応者はデータのコピーに費やす時間を減らし、意思決定により多くの時間を割くことができます。
オートメーションは人間の責任を排除するものではありません。安全なプログラムは、顧客や本番環境に影響を及ぼす可能性のあるアクションと、低リスクで決定的なステップを区別し、影響度に応じて承認、スコープされた認証情報、監査ログ、タイムアウト、ロールバックを適用します。
重要ポイント
- 自律的な修復を試みる前に、繰り返し可能な証拠収集を自動化する。
- 重大度、信頼度、影響範囲、可逆性を用いて承認レベルを選択する。
- すべてのランブックをテストと所有者を持つバージョン管理された本番コードとして扱う。
- 検知、認知、復旧、再発、ユーザーへの影響を測定し、単なるアラート数だけに依存しない。
シグナルから調整された対応へ
ワークフローはアラートの重複除去、最近のデプロイやログの添付、サービスオーナーの特定、インシデントレコードの作成、オンコールチームへのページング、コミュニケーションチャネルの作成、タイムラインの開始を行うことがあります。これらのステップは、リスクのある診断を自動的に行うことなく認知負荷を軽減します。
相関付けは証拠を保持しなければなりません。プラットフォームが症状を過度にグループ化すると、同時発生するインシデントが隠れてしまう可能性があります。オートメーションをIT オペレーションの所有権にリンクし、対応者が必要とする生のシグナルを保持してください。
リスクに応じたアクションの選択
読み取り専用クエリ、スナップショット、可逆的なトラフィックシフトは、データ削除や広範な認証情報のローテーション、本番スキーマの変更よりも一般的に自動化しやすいです。各アクションについて前提条件、実行タイムアウト、事後条件、ロールバックを定義してください。
最小権限のサービスアイデンティティを使用し、認可をワークフローエンジンから分離します。高インパクトのステップは、特定された承認者が必要です。AIOps が原因や修正を提案した場合でも、対応者は裏付けとなる証拠と安全に拒否できる手段を必要とします。
信頼できるランブックの構築
ランブックは入力、依存関係、所有者、スコープ、失敗時の挙動、生成される証拠を明示すべきです。ステージング環境やゲームデイでテストしてください。冪等なステップは、再試行しても追加の害を生まないため価値があります。
オートメーションも他のソフトウェアと同様にバージョン管理とレビューを行います。認証情報の有効期限、API の変更、レートリミット、部分的な実行、サービス間の隠れた結合を監視してください。オートメーションプラットフォーム自体が利用できない場合は、手動手順が依然として必要です。
復旧後の学習
オートメーションは、シグナル、判断、アクション、承認、結果のタイムスタンプ付き記録を保持すべきです。非難のないレビューにより、寄与したシステム状態と最終トリガーを分離し、得られた教訓を検証済みの改善策に変換できます。
有用な指標として、認知までの平均時間と復旧までの平均時間、安全なステップの自動化率、失敗アクション率、再発インシデント、顧客への影響があります。結果をDevOps の計画に結び付け、クローズされたチケット数の最適化だけを目指さないでください。
インシデントオートメーションのタイプ
イベントオートメーションは、受信したシグナルを正規化し情報付加します。調整オートメーションはインシデントレコードを作成し、オーナーにページングし、コミュニケーションチャネルを開設し、ステータス更新を投稿します。診断オートメーションは読み取り専用クエリを実行またはスナップショットを取得します。修復オートメーションはシステム状態を変更し、復旧オートメーションはサービスの健全性を検証し、一時的な緩和策を閉じます。
これらのカテゴリは同一のデフォルト信頼レベルを共有すべきではありません。情報付加は多くの場合自動で実行できますが、プロダクションのフェイルオーバーは信頼性チェックと承認者が必要になることがあります。データ復元は通常、インシデント指揮官とアプリケーションオーナーが必要です。制御はステップがルールか機械学習モデルで実装されたかではなく、潜在的な影響度に従うべきです。
セキュリティインシデントでは証拠保存の要件が追加されます。オートメーションは、揮発性データが取得される前に侵害されたホストを変更したり、公開チャネルで機密指標を露出したり、影響範囲を把握せずに共有インフラを隔離したりしてはなりません。運用とフォレンジックのランブックは重なることがありますが、実行順序は異なる場合があります。
ワークフロー設計とコントロールプレーン
ランブックを前提条件と最終結果を持つ明示的な状態としてモデル化します。すべてのアクションは開始、成功、失敗、タイムアウト、スキップのいずれかを報告し、変更不可能な実行識別子を付与すべきです。中央のオーケストレータがステップを調整できますが、下流サービスは独自の認可を実施し、入力を独立して検証すべきです。
スコープされた短命の認証情報を使用し、オートメーションエンジンからのネットワーク経路を制限します。開発、テスト、本番のランナーを分離してください。シークレットはチャットの文字起こしやログに現れてはなりません。高インパクトのアクションでは、二者承認またはブレークグラスロールを要求し、その使用は即時のレビュー履歴を生成します。
部分的な失敗に備えて設計します。ページングが失敗している間にチケットが作成されたり、トラフィックシフトがあるリージョンで成功し別のリージョンでタイムアウトしたりすることがあります。補償アクション、調整ジョブ、明確な所有権が、オーケストレーションプロセスが終了しただけで成功と報告されることを防ぎます。
事例、テスト、成熟度
成熟した最初のユースケースはデータベース接続枯渇です: プールメトリクス、最近のデプロイ、スロークエリ、オーナー情報を収集し、インシデントを作成し、可逆的なスケーリングまたはトラフィックアクションを提案し、承認を求め、エラーレートとレイテンシを検証します。同様のパターンは証明書の有効期限切れ、ディスク圧迫、ジョブ失敗、疑わしいアカウント活動にも適用できます。
ランブックはユニットテスト、モックAPI、ステージングインシデント、ゲームデイ、制御された本番ドリルでテストします。古いデータ、権限拒否、遅い依存関係、重複イベント、矛盾するインシデントを注入し、リトライが安全であること、対応者がオートメーションと対立せずに手動で制御できることを確認します。
成熟度は通知 → 情報付加 → ガイド付きアクション → 範囲限定の自動修復へと進みます。進展は証拠に基づくべきです: 安定した診断、低い失敗アクション率、検証されたロールバック、明確なユーザー利益。システムが復旧を証明し、後の学習のために十分な証拠を保持できるまで、自律的なクローズは稀であるべきです。
実例:本番サービスインシデントの自動化
デプロイ後にエラーレートが上昇した決済 API を例に考えます。監視はサービス、環境、リージョン、バージョン、エラーバジェット、ランブックへのリンクを含む構造化アラートを発行します。オートメーションは変更履歴、依存性の健全性、最近のログ、所有者情報を付加し、重複アラートを1つのインシデントにまとめます。決定論的ポリシーは直ちにロールアウトを一時停止でき、ロールバックには新バージョンが原因である証拠とロールバックが安全であることが必要です。
ワークフローはインシデント指揮官を割り当て、コミュニケーションチャネルを開設し、タイムラインを記録し、診断ステップを提案します。自動修復は、健全なインスタンスへのトラフィックシフトなど低リスクで可逆的なアクションから開始します。すべてのアクションは認可、同時実行制限、タイムアウト、検証された事後条件、ロールバックが必要です。生成された要約は対応者を支援する可能性がありますが、ソースのテレメトリとコマンドは可視化されたままで、チームは誤ったシナリオに異議を唱えることができます。
検知、認知、緩和、復旧までの時間、アラート量、重複抑制、修復成功率、再発、オートメーションによる被害を測定します。期限切れの認証情報、部分的なリージョン、誤解を招くアラート、失敗したロールバックに対してゲームデイを実施します。復旧後は事実のタイムラインを保持し、寄与した技術的・組織的条件を特定し、ランブックとテストを更新し、迅速な緩和を信頼性作業の終わりとみなさず、是正作業を完了まで追跡します。
実装チェックリスト
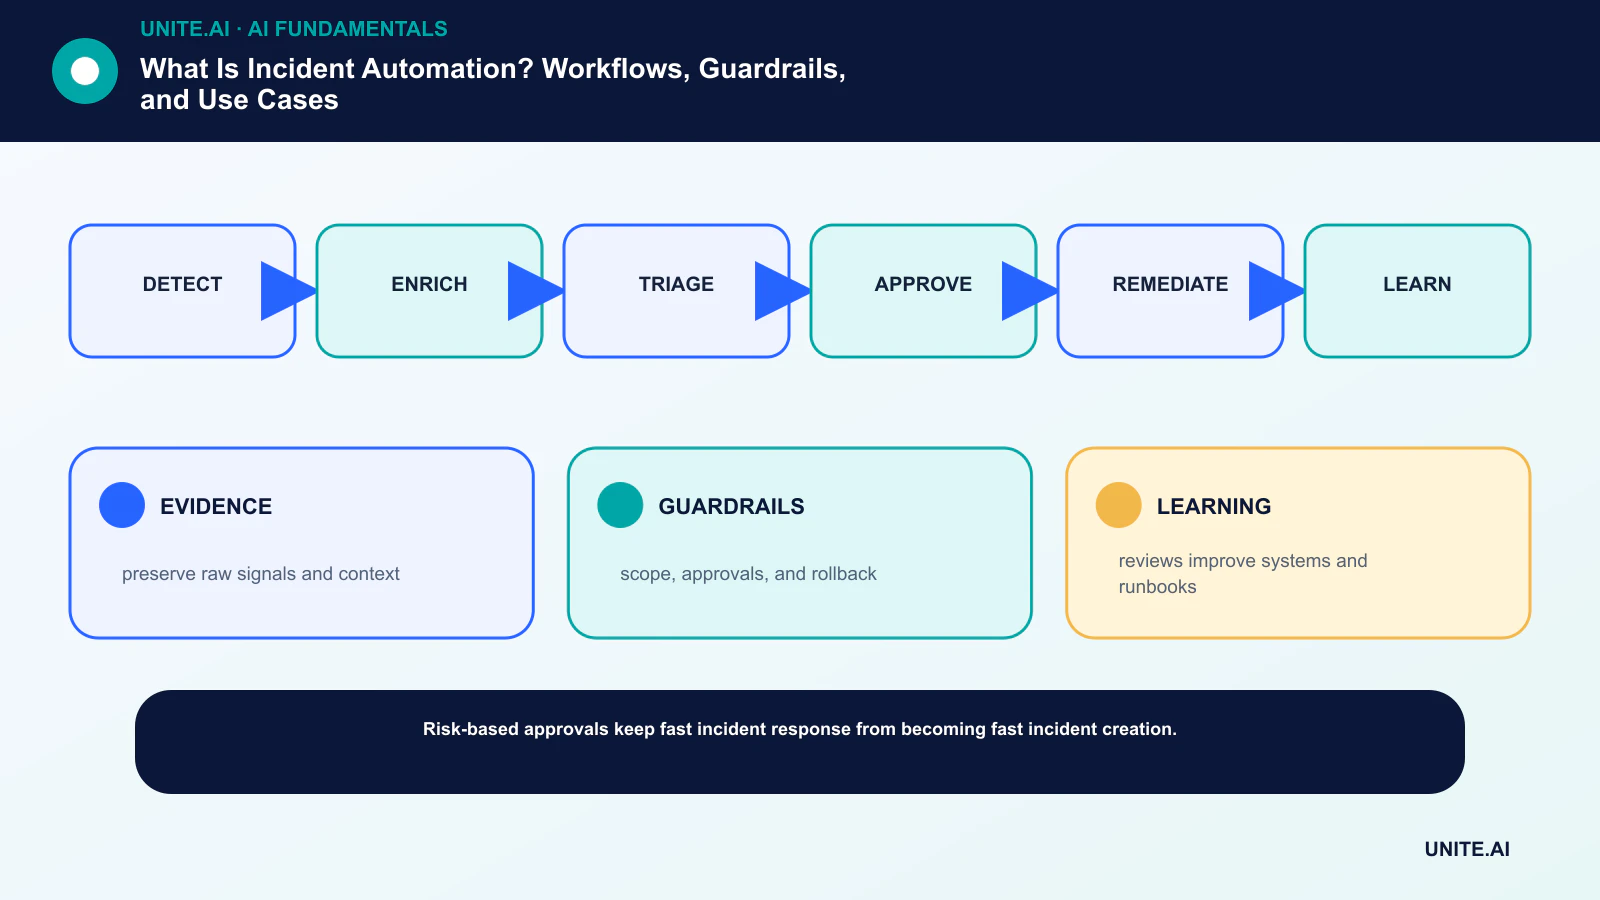
概念を範囲が限定され、テスト可能なワークフローに変換します: 検知 → 情報付加 → 分類 → 承認 → 修復 → 学習。責任者を明示し、データと依存関係を文書化し、シンプルなベースラインを設定し、受入基準と停止基準を定め、代表的な失敗をテストし、スコープ拡大前に監視、ロールバック、レビューを定義します。バージョンと前提条件を記録し、別チームが結果を再現し変更点を把握できるようにします。
リリース前に、システムを構築・運用・保護し、影響を受ける関係者と文書化されたレディネスレビューを実施します。通常ケース、境界条件、依存障害、誤用をテストし、証拠と未解決リスクを保持します。リリースを承認できる人物、閾値を変更できる人物、出力を上書きできる人物、運用を停止できる人物を定義してください。実データが到着した後に判断を再検討します。技術的に成功したパイロットだけでは、広範なスケールでの信頼性パフォーマンスは保証されません。
- EVIDENCE: 生のシグナルとコンテキストを保持する。
- GUARDRAILS: スコープ、承認、ロールバック。
- LEARNING: レビューはシステムとランブックを改善する。
よくある質問
インシデントオートメーションはAIOpsと同じですか?
いいえ。AIOps は運用データに分析や機械学習を適用します。インシデントオートメーションは、より広範な実行および調整レイヤーであり、シンプルなルール、AIOps の出力、またはその両方を利用できます。
まず何を自動化すべきですか?
まずは、情報付加、所有者検索、証拠取得、ステータス更新、可逆的な診断など、頻度が高くリスクが低く、理解されたステップから始めます。
主要参考文献











