
AIの基礎
コンピュータビジョンとは何か?

 Unite.AI を Google の優先ソースに追加
コンピュータビジョンは、画像や映像から有用な情報を抽出するシステムを構築する分野です。ビジョンモデルは、画像全体を分類したり、物体を検出したり、各ピクセルにラベル付けしたり、テキストを読み取ったり、姿勢を推定したり、動きを追跡したり、視覚コンテンツとテキストを結びつけたりすることができます。
最新のビジョンシステムは、人間の知覚における初期のエッジ検出プロセスを単に再現するだけではありません。データからタスク固有の表現を学習し、しばしばconvolutional neural networks、vision transformers、またはマルチモーダル基盤モデルを使用します。
主なポイント
- 分類、検出、セグメンテーション、OCR、追跡、生成はそれぞれ異なるビジョンタスクです。
- CNNは局所性と重み共有を組み込み、ビジョントランスフォーマーは画像パッチ間の注意機構を使用します。
- ラベルは人間、弱教師あり、合成データ、または自己教師あり目的から得られます。
- 精度だけでは不十分です。ロバスト性、レイテンシ、プライバシー、バイアス、失敗コストも重要です。
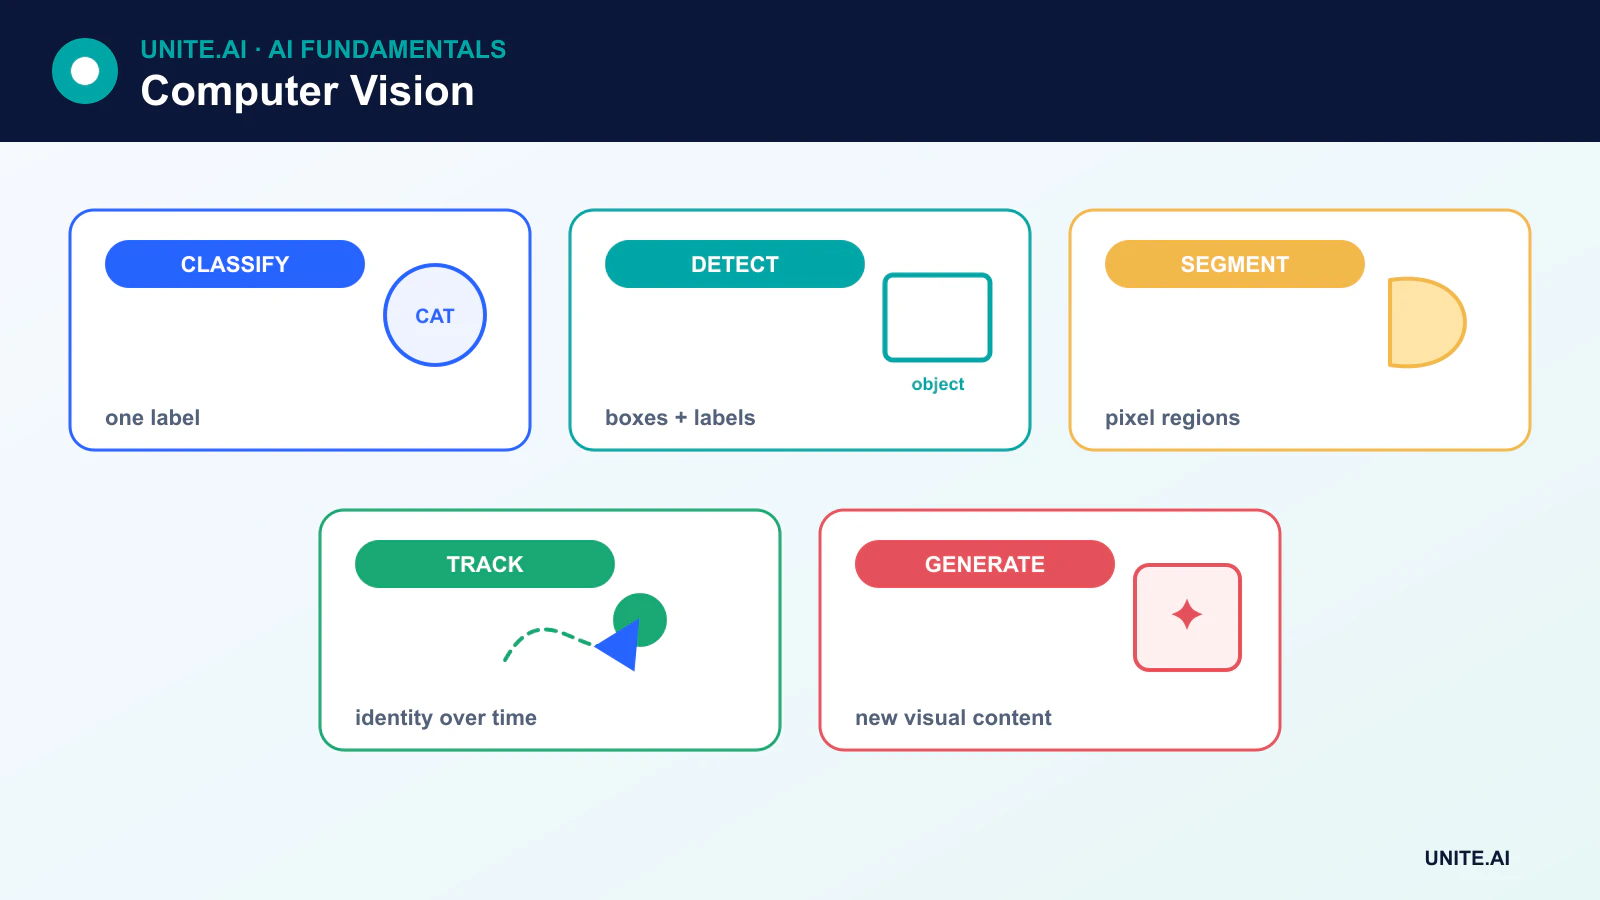
主要なコンピュータビジョンタスク
- 画像分類は画像に1つまたは複数のラベルを付与します。画像分類の仕組みについては、こちらをご覧ください。
- 物体検出は複数の物体のカテゴリとバウンディングボックスを予測します。
- セマンティックセグメンテーションは各ピクセルにクラスラベルを付け、インスタンスセグメンテーションは個々の物体を分離します。
- 光学文字認識(OCR)はテキストを検出し、文字起こしを行います。
- 姿勢推定は人体や物体のランドマークを予測します。
- 追跡はビデオフレーム間で検出結果を関連付けます。
- 画像生成・編集は視覚コンテンツを生成または変換し、しばしばdiffusion modelsを使用します。
画像がモデル入力になる仕組み
デジタル画像はすでに数値データであり、空間次元とチャンネルにわたるピクセル値を含むテンソルです。前処理では画像のリサイズ、正規化、クロップ、または拡張が行われることがあります。動画は時間次元を加え、医療や科学画像は深度、波長、その他のモダリティを加えることがあります。
従来のコンピュータビジョンは手作業で設計されたエッジ、コーナー、テクスチャ特徴を使用していました。最新のディープモデルは通常、タスクと共に特徴を学習しますが、データが限られている場合や規則が明確に理解されている場合、計算リソースを最小限に抑える必要がある場合には、従来手法が依然として有用です。
CNN と学習されたローカル特徴
CNN は学習されたカーネルをローカルな領域に適用します。初期層は局所パターンに反応し、後続のブロックはそれらをタスクに関連した表現に統合します。プーリングやストライド演算により空間解像度が低下し、残差接続により深いネットワークの最適化が容易になります。
最新の CNN 分類器は、従来の多数の全結合層の代わりにグローバルプーリングを使用することが多いです。検出器やセグメンテーションネットワークは、空間情報を保持するために専門的なヘッドやデコーダーパスを追加します。
ビジョントランスフォーマーと基盤モデル
ビジョントランスフォーマーは画像をパッチに分割し、埋め込みを行い、注意機構でそれらの関係性をモデル化します。トランスフォーマーは大規模データセットと事前学習により効果的にスケールしますが、CNN は小規模な場合に強固な組み込み前提と効率性を提供することが多いです。
マルチモーダルモデルは画像とテキストを整合させ、ユーザーが検索、キャプション生成、質問応答、言語によるセグメンテーション指示などを行えるようにします。これらのモデルは機能を拡張しますが、ステレオタイプや著作権で保護された素材、人口や環境のカバレッジが偏っているといった、ウェブ規模データ特有の弱点も引き継ぎます。
ラベル、自己教師あり、合成データ
バウンディングボックス、マスク、ランドマーク、キャプションの作成にはコストがかかります。自己教師あり学習は画像自体から目的関数を導き出し、弱教師ありはノイズの多いまたは間接的なラベルを使用します。合成データは稀なシナリオを追加できますが、シミュレーションギャップにより合成データの性能が実世界に転移しないことがあります。
アノテーションの品質は測定する必要があります。曖昧なラベル、境界の不一致、対象物の欠落は性能の上限を設定し、サブグループの失敗を隠す可能性があります。
ビジョンシステムの評価方法
分類では精度、適合率、再現率、F1、キャリブレーションなどの指標が使用されます。検出では一般的に Intersection over Union(IoU)と平均適合率(mAP)が用いられます。セグメンテーションは IoU または Dice 形式の指標を使用します。追跡では個体識別や軌道に関する指標が加わります。
指標は導入環境に合わせる必要があります。モデルは精選されたベンチマークで高得点を取っても、雨天、低照度、異常なカメラ角度、新しいデバイス、未知の集団では失敗することがあります。評価には分布シフト、敵対的条件、運用レイテンシを含めるべきです。
プライバシー、バイアス、導入
顔、ナンバープレート、住宅、医療スキャン、職場の映像は機微な情報を露呈する可能性があります。収集と保存は明確な法的・倫理的根拠に従い、アクセス制御とデータ最小化を行うべきです。顔解析や生体認証は、エラーや監視が不平等な被害をもたらす可能性があるため、特に慎重に取り扱う必要があります。
エッジ導入はレイテンシとデータ転送を削減できます。Edge AI、量子化、プルーニング、専用アクセラレータは、カメラ、車両、ロボット、モバイルデバイス上でビジョンシステムを実用化しますが、圧縮は精度とバイアスの観点から再評価が必要です。
ピクセルから視覚タスクへ
コンピュータビジョンは画像や映像を分類、検出、セグメンテーション、追跡、姿勢、深度、光学フロー、テキスト認識などのタスク出力に変換します。タスク定義がアノテーションを決定し、画像ラベルだけでは正確な位置特定は学習できず、バウンディングボックスだけではセグメンテーションマスクを完全に表現できません。カメラの幾何学、レンズ、露出、照明、動き、圧縮、視点がデータ分布を形作ります。モデルを選択する前に、運用環境とエラーの影響を定義すべきです。ベンチマーク画像コレクションが実際に配置されるセンサーやシーンを代表しないことがあります。
パイプラインはメディアをデコード・方向付けし、リサイズまたはタイル化し、値を正規化し、ラベルを保持した拡張を適用し、モデルを実行し、ロジット、バウンディングボックス、マスク、トラックを後処理します。物体検出器は信頼度閾値と抑制を使用し、トラッカーは時間軸で検出を関連付け、セグメンテーションは形態学的なクリーンアップが必要になることがあります。座標変換を保持して出力が元画像と合致するようにします。人物、カメラ、場所、撮影セッション単位でデータを分割し、ほぼ同一のフレームが訓練とテストの両方に現れないようにします。
評価、バイアス、プライバシー、運用
指標はタスクと利用目的に合わせる必要があります。分類ではクラス別の適合率と再現率が必要で、検出は IoU と閾値横断的な平均適合率、セグメンテーションは IoU または Dice、追跡は ID スイッチを加えます。動画ではレイテンシと見逃し時間も重要です。結果は照明、距離、デバイス、遮蔽、肌色、年齢などの条件別に報告します。キャリブレーションと高信頼度エラーを検査します。合成または拡張データはギャップを埋められますが、実際の導入データとの比較が必要で、テストシーンが漏れないようにしなければなりません。
ビジョンは通行人、場所、生体情報、機微な行動を収集する可能性があります。撮影と保存は最小限に抑え、ストリームを保護し、二次利用を制限し、必要に応じて通知または同意を提供します。敵対的パッチ、リプレイ、遮蔽、カメラ故障、ドメインシフトをテストします。センサーの健康状態、入力統計、出力率、確定結果を監視し、重要な判断には人間のレビューを維持します。ぼかしやトリミングは露出を減らせますが、証拠を失う可能性もあります。実験室での高スコアは、検証されたタスクを超える身元、感情、意図の主張を正当化しません。
実例:倉庫横断点での歩行者検出
カメラは制限された車両横断点を監視し、モデルは人物を検出しますが個人の識別は行いません。データは昼夜、天候、服装、遮蔽、車椅子利用者、カメラ位置、空のシーンを含み、録画セッションごとに分割されています。検出器はイベント再現率、誤報、位置精度、警告リードタイム、距離における性能で評価されます。安全工学は許容できる最大レイテンシと独立した物理的制御を定義します。
ビジョンアラートは車両を減速させることができますが、緊急停止やバリアは学習モデルに依存しません。カメラの遮蔽、フレームの凍結、ネットワーク障害、モデルのタイムアウトは明示的な障害を生じます。生映像の保存は最小限に抑え、アクセスは記録されます。モニタリングはセンサーの健康状態、アラート率、レビュー済みインシデント、条件別のニアミスを追跡します。カメラの移設やレイアウト変更は、画像の見た目が似ていても幾何学やリスクが同一である保証がないため、再検証をトリガーします。
導入実績と運用準備性
本番導入の判断は、成功したデモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な障害ごとの影響を定義します。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、異常または欠損入力、分布シフト、依存障害、誤用、サービスが行き届きにくいグループや環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを採用し、安全なフォールバックを保持し、意図的に障害を注入したモニタリングを検証します。運用テレメトリは、入力品質、出力挙動、モデルまたはルールのバージョン、依存の健康状態、人間のオーバーライド、確定結果を示し、不要な機微データは収集しません。アラート閾値と対応責任者を定義し、導入後に実世界の証拠をレビューし、オフライン性能が持続すると仮定しないでください。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目的が変わるたびに再評価します。維持されたシステムは、復旧手順、インシデント学習、削除・保存手順、無効化または置換すべき明確なタイミングも文書化する必要があります。
よくある質問
コンピュータビジョンは画像認識と同じですか?
いいえ。画像認識は通常、分類や識別を指します。コンピュータビジョンは、位置特定、セグメンテーション、測定、追跡、再構築、生成、視覚情報に対する推論も含みます。
ビジョンシステムは人間のように見えますか?
いいえ。モデルはそのアーキテクチャと学習目的に従って数値入力を処理します。狭いベンチマークでは人間を上回ることがありますが、人が容易に対処できる小さな変化に対しては失敗します。
主要参考文献












