
AIの基礎
TinyMLとは何か?マイクロコントローラ上の機械学習

 Unite.AI を Google の優先ソースに追加
TinyMLは、マイクロコントローラや小型デジタル信号プロセッサ、低消費電力センサーなど、極めて制約のあるデバイスに機械学習の推論をもたらします。これらのシステムは、キロバイトからメガバイト規模のメモリ、厳しいエネルギー予算、常時接続されたネットワークがなく、リアルタイムの期限が求められることがあります。
価値は単にモデルが小さいことだけではありません。センサー付近で処理することで、レイテンシや帯域幅、そして生データの露出を削減でき、バッテリーやエネルギーハーベストで長時間動作する製品を実現できます。
重要ポイント
- TinyMLは、モデルサイズの閾値だけでなく、ハードウェアとソフトウェアの全体予算で定義されます。
- 量子化、コンパクトなアーキテクチャ、最適化されたカーネル、そして慎重なバッファリングが導入を可能にします。
- デバイス上での推論はプライバシー向上につながりますが、セキュアなアップデートやデータガバナンスも依然として重要です。
- ベンチマークでは、精度だけでなくレイテンシ、最大メモリ使用量、エネルギー、デューティサイクル、そしてロバスト性も評価します。
TinyMLスタック
センサーは音声、動き、振動、画像、またはその他の信号を取得します。ファームウェアはそれを特徴量やテンソルに前処理し、コンパクトなモデルが組み込みランタイムで実行されます。アプリケーションロジックは、より大きなシステムを起動させるかローカルで処理するかを判断します。
これはエッジAIの制約版です。ハードウェアは MCU、メモリ、センサーインターフェース、場合によってはニューラルアクセラレータを含むことがあります。すべてのバッファ、演算子、コピーが限られたリソースを争います。
モデルを適合させる
量子化は高精度の値を小さな整数表現に置き換えます。プルーニング、蒸留、特徴量エンジニアリング、アーキテクチャ探索により計算量やストレージを削減できます。対象ランタイムでサポートされる演算子が、実用的なモデルを制限します。
学習は通常、より大きなハードウェア上で行われ、モデルはデバイス向けに変換・コンパイルされます。転移学習はデータ要件を減らせますが、数値的な変化が精度に影響を与えるため、変換後に最終成果物を評価する必要があります。
データと環境の変化
実験室での録音は、あらゆるマイクロフォン、取り付け位置、温度、振動パターン、アクセント、背景条件を網羅することはほとんどありません。代表的なデバイスや環境からデータを収集し、訓練データとテストデータのソースを独立させ、‘その他’ケースも含めます。
誤作動はエネルギーを浪費したりユーザーを不快にさせ、異常を見逃すと大きなコストが発生します。実際のエラーコストを考慮して閾値を設定し、必要に応じてプライバシー保護された要約やサンプリング診断で現場のパフォーマンスを監視します。
デバイス全体を測定する
モデルの演算回数だけで製品性能を表すことはできません。ウェイク頻度、前処理時間、推論レイテンシ、最大RAM使用量、フラッシュ使用量、平均・最大電力、熱特性、そして明示的なデューティサイクル下でのバッテリーへの影響を報告します。
署名付きファームウェアとモデルの更新、ロールバック、デバイス識別、脆弱性対応を計画します。小型デバイスは数年にわたり稼働し続ける可能性があるため、保守性はモデル品質の一部です。デバイスが小さいからといってサイバーセキュリティ対策を後回しにすべきではありません。
メモリと計算資源の予算管理
フラッシュはファームウェア、モデル重み、定数を格納し、RAMはセンサーバッファ、中間活性化、ランタイム状態を保持します。特に初期の畳み込み層では、最大活性化メモリが重みサイズを超えることがあります。メモリプランナーは寿命が重ならないバッファを再利用し、ストリーミング特徴量は信号全体のウィンドウを保存しません。
演算回数は初期見積もりに過ぎず、カーネル効率はテンソル形状、アラインメント、命令サポート、メモリアクセスに依存します。深度方向畳み込みは演算量を減らすものの、最適化されたカーネルが無いハードウェアでは性能が低下します。デスクトップのプロファイラだけでなく、対象ボード上でコンパイル済みモデルをベンチマークしてください。
多くの製品ではデューティサイクルが支配的です。センサーと MCU はスリープし、安価なトリガで起床し、小さなモデルを実行し、必要時にのみ無線や大型プロセッサを起動します。センサー、変換、前処理、ウェイクアップ、推論、通信、アイドル時のリーク電流を含む全デューティサイクルを測定します。
モデル開発と変換
導入制約を最初に定め、代表的なセンサーデータを収集します。学習時に使用した前処理は、固定小数点または組み込み実装と正確に一致させる必要があります。サンプリングレート、ウィンドウ処理、色変換、正規化、特徴抽出の違いが、変換は成功してもモデルの失敗につながります。
学習後の量子化は代表的サンプルから範囲をキャリブレートし、量子化認識学習は学習中に低精度をシミュレートします。チャンネルごとの重みスケールは、単一スケールよりも畳み込み品質を保ちやすいです。サポートされていない演算は書き換え、近似、または遅いフォールバックへ移行でき、いずれも新たな評価が必要です。
圧縮は仮説に基づいて行うべきです。構造化されていない重みのプルーニングは、密な組み込みカーネルの速度向上につながらないことがあります。構造化されたチャネル削除はハードウェアが活用しやすいです。蒸留は大きな教師モデルから振る舞いを転送しますが、バイアスや誤りも転送する可能性があります。信号処理や閾値ベースラインと比較してください。
応用例、現場テスト、保守
一般的な TinyML のタスクにはキーワードスポッティング、ウェイクワード検出、ジェスチャー認識、振動異常検出、占有検知、音響イベント、簡易ビジョンなどがあります。モデルは最終判断ではなくゲートとして機能し、帯域幅を節約しつつ不確実または重要なケースをより高性能なシステムへ送ります。
現場テストはデバイスの許容範囲、センサーの劣化、取り付け、バッテリー状態、温度、天候、ユーザー、背景干渉まで網羅すべきです。単なるバランス精度だけでなく、時間当たりの誤作動回数や稼働サイクル当たりの見逃しイベント数を追跡します。実験室で設定した閾値は製品固有の校正が必要になることがあります。
署名付き OTA 更新、ロールバック、モデルバージョンのテレメトリ、長期サポートを計画します。更新が不可能な場合は保守的なモデルを使用し、予想される環境ドリフトを文書化します。廃止時にはデバイスの認証情報を無効化し、保存データに対処する必要があり、単に製品販売を停止するだけでは不十分です。
実例:TinyML 振動モニタ
モーターに取り付けた小型加速度計が、通常負荷と既知の故障状態下で振動をサンプリングします。デバイスは信号をウィンドウ分割し、オフセットを除去し、コンパクトな時間領域または周波数領域の特徴量を算出し、異常検知器または分類器を実行します。サンプリングレートは、メモリや電力を圧迫せずにベアリングやシャフトの関連周波数を捉える必要があります。ラベルは検証済みの検査結果から取得し、単に誤った可能性のあるアラームだけに依存しないようにします。
学習はワークステーション上で行い、その後量子化、変換、対象マイクロコントローラ向けにコンパイルします。実機でモデルのフラッシュ使用量、最大RAM、実行時間、エネルギー、精度を測定します。整数演算や演算子の有無が学習時モデルの出力を変えることがあります。センサーの向き、取り付け、温度、電圧、部品のばらつき、実際の背景振動をテストし、キュレーションされた実験室データだけに頼らないようにします。
展開されたデバイスは校正、セキュアなファームウェア更新、バージョン報告、フェイルセーフ動作、ドリフト対策を必要とします。エネルギー節約と生データ保護のため、ヘルススコアや選択された特徴量のみを送信することがありますが、ローカルの誤警報は保守コストを生みます。段階的な閾値設定、永続性の要求、モデルの証拠と稼働状態の組み合わせを使用します。ローカルレイテンシ、プライバシー、接続性、エネルギー制約がエンジニアリング上の限界を正当化する場合に、TinyML は最大の価値を発揮します。
量産テストには、電源サイクル復旧、クロックドリフト、センサー切断、入力破損、メモリ枯渇、更新中断を含めるべきです。モデルが実行できない、または信頼度が低下した場合の対応を定義します。安全なデフォルト、明示的な障害指標、あるいは従来のルールが、無音の推測より好ましいことがあります。機器群のハードウェアとファームウェアのバージョンを追跡し、新たに観測されたエラーをデバイスリビジョン、環境、またはモデルリリースに特定できるようにします。
実装チェックリスト
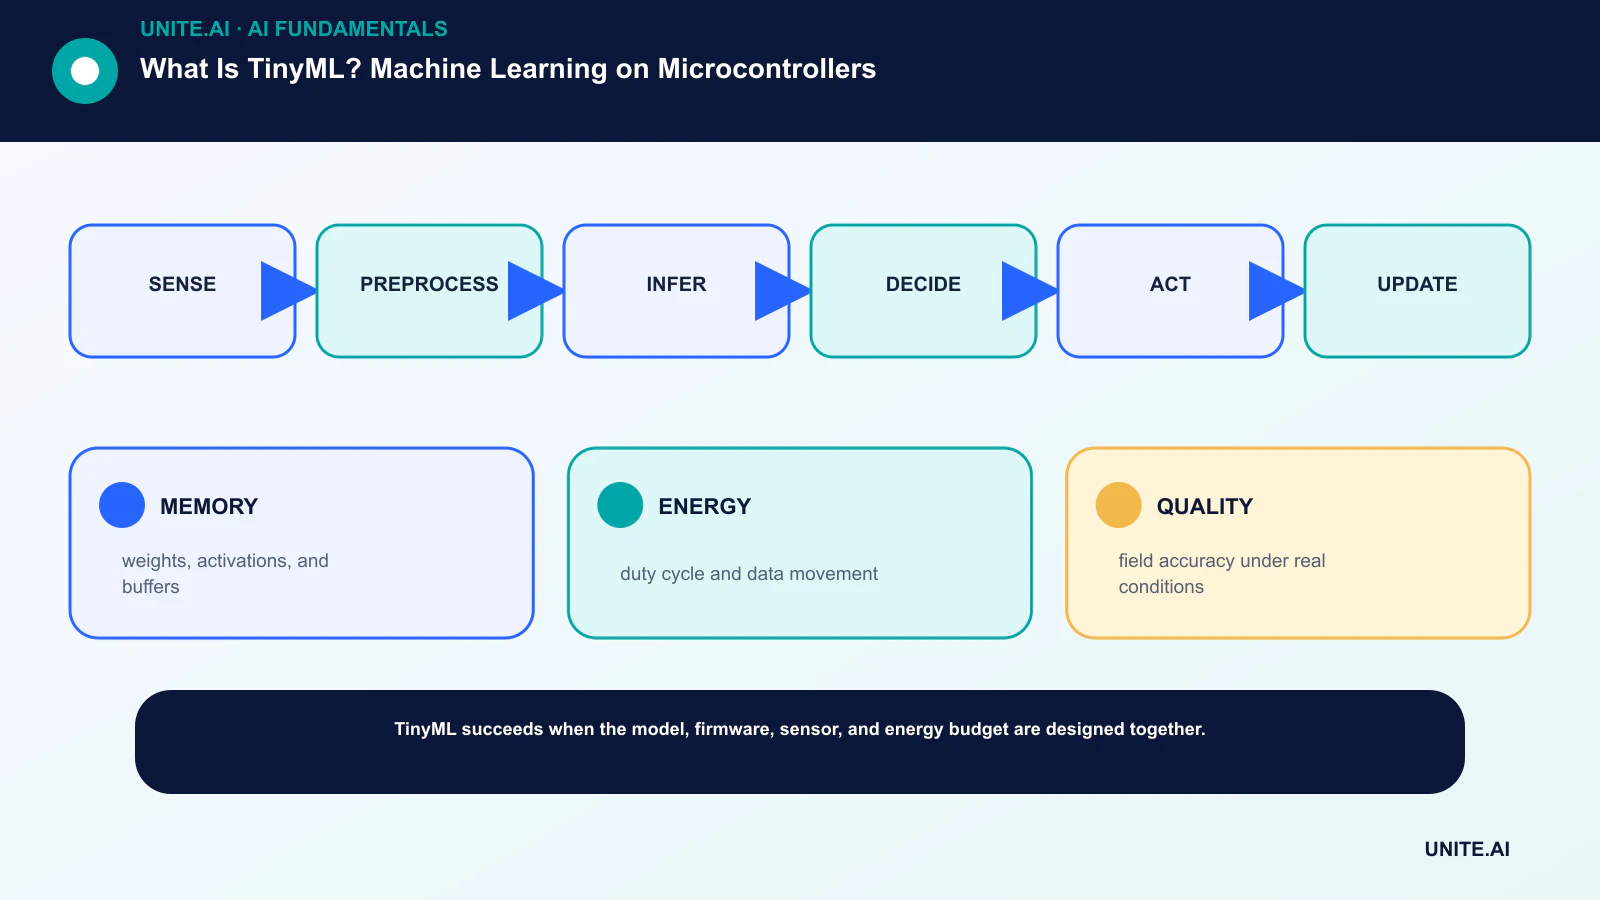
概念を限定的でテスト可能なワークフローに落とし込みます:検知 → 前処理 → 推論 → 判定 → 実行 → 更新。責任者を明示し、データと依存関係を文書化し、シンプルなベースラインを設定し、受入基準と停止基準を定め、代表的な障害をテストし、スコープ拡大前に監視、ロールバック、レビューを定義します。バージョンと前提条件を記録し、他チームが結果を再現し変更点を把握できるようにします。
リリース前に、構築・運用・セキュリティ・影響を受ける関係者と文書化された準備レビューを実施します。通常ケース、境界条件、依存失敗、誤用をテストし、証拠と未解決リスクを保存します。リリース承認、閾値変更、出力上書き、運用停止の権限者を定義します。実データが得られたら判断を再検討します。技術的に成功したパイロットでも、規模拡大時の信頼性を保証するわけではありません。
- メモリ: 重み、活性化、バッファ。
- エネルギー: デューティサイクルとデータ転送。
- 品質: 実環境下でのフィールド精度。
よくある質問
TinyMLはモバイルAIと同じですか?
正確には違います。モバイルデバイスは比較的大きなプロセッサとメモリを持つエッジシステムです。一方、TinyML ははるかに厳しい組込み・マイクロコントローラ級の制約に焦点を当てています。
TinyMLモデルはデバイス上で学習できますか?
ほとんどの導入は他の場所で学習し、デバイス上で推論します。限定的な適応は可能ですが、メモリ、エネルギー、安定性、プライバシー、ロールバックの制約により、デバイス上での学習は困難です。
主な参考文献












