AIモデルとプラットフォーム
ムーアの法則とは何か、そしてAIにどのような影響を与えるか?

 Unite.AI を Google の優先ソースに追加
ムーアの法則は、経済的に有用な集積回路が指数関数的な速度で部品数を増やすという歴史的観測です。これは物理法則ではなく、コンピュータが一定のスケジュールで自動的に2倍速くなると述べているわけでもありません。
AIにおいては、トランジスタ密度が重要です。なぜなら、より多くの演算ユニット、メモリ、相互接続が可能になるからです。しかし、実際の進歩はアーキテクチャ、数値精度、パッケージング、メモリ帯域幅、アルゴリズム、ソフトウェア、エネルギー、製造歩留まり、そして有用なデータ量にも依存します。
重要なポイント
- ムーアが1965年に発表した元の記事は、物理的な保証ではなく、経済的・工学的なトレンドを記述したものです。
- クロック速度のスケーリングは鈍化し、現在の性能向上は並列性や特殊アクセラレータから得られることが増えています。
- AIの性能は、演算だけでなく、メモリ転送やエネルギーがボトルネックになることが多いです。
- システムを比較する際は、トランジスタ数ではなく、ワークロードレベルのレイテンシ、スループット、品質、消費電力、総コストを基準にしてください。
ムーアが実際に観測したこと
ゴードン・ムーアは、主要な集積回路における部品数をプロットし、部品あたりのコストを最小限に抑えたまま急速な成長が続くと予測しました。そのペースは後に「約2年ごとに倍増する」と要約されることが多くなりましたが、表現や測定対象は様々です。
微細化により密度が上がり、スイッチングコストの一部が削減されますが、製造の複雑さや経済性がトレンドの有用性を左右します。プロセスノード名はマーケティング用のラベルであり、ファブリ間で直接的な物理比較として扱うべきではありません。
高速コアからヘテロジニアスコンピューティングへ
デナード方式の電圧スケーリングにより、かつては電力増加に比例しない高クロックレートが可能でしたが、その関係は弱まりました。設計者はマルチコアCPU、GPU、テンソルユニット、チップレット、先進的パッケージング、ドメイン固有アクセラレータへとシフトしました。
このヘテロジニアリティはディープラーニングの中心です。高密度の行列演算は並列ハードウェアで効率的に実行でき、CPUは不規則なロジックやデータ転送を調整します。パイプラインが供給できなければ、最速のコンポーネントは役に立ちません。
メモリ、精度、アルゴリズム
学習と推論では、重み、活性化、キャッシュデータがオンチップとオフチップのメモリ階層を何度も行き来します。帯域幅、容量、局所性、通信がコストを支配することがあります。品質が許容範囲内であれば、低精度や量子化によりデータ転送を削減できます。
アルゴリズムの改良により、目標結果に必要な計算量を削減できます。スパースモデル、トランスフォーマーの効率化手法、より優れた最適化手法、そして高品質データは、ユーザーが実感する進歩に影響を与えます。
AIハードウェアの比較方法
ピーク性能(秒あたりの演算数)は理論値です。代表的なモデル、バッチサイズ、シーケンス長、精度、ソフトウェアスタック、品質閾値を用いて評価してください。エンドツーエンドのレイテンシ、スループット、エネルギー、メモリ使用量、利用率、コストを報告します。
エッジシステムは最大スループットよりもプライバシーや低消費電力を重視することがあります。一方、データセンターはトークン総数やワット当たりのサンプル数を優先します。エッジAIは、単一の指標だけではすべての有用なシステムを説明できない理由を明らかにします。
半導体スケーリングが変化した理由
初期の集積回路の進歩は、デバイスの微小化、製造技術の向上、部品あたりコストの低減、設計の改良が組み合わさって実現しました。長年、トランジスタ寸法の縮小は高速スイッチングと演算あたりのエネルギー低減を支えてきましたが、やがてリーク電流、電圧制限、熱密度、配線遅延、製造コストが、新しいプロセスノードと汎用コアの高速化との単純な関係を弱めました。
現在の進歩は多面的です。FinFETやゲートオールアラウンドデバイスは静電制御を向上させ、極紫外光リソグラフィはより小さなパターンを可能にし、チップレットは異なるプロセスで作られたダイを組み合わせられます。先進的パッケージングは計算ユニットとメモリをより近接させます。歩留まりとパッケージングが、技術的に優れた設計が大量生産で経済的かどうかを決定します。
あるスケーリングメカニズムの減速は、ハードウェアの進化が止まったことを意味しません。むしろ、設計者はトランジスタをより意図的に使用しなければならなくなります。特殊化ユニットは柔軟性を犠牲にして、特定のワークロードでスループットや効率を高めます。一方、より大きなキャッシュやインターコネクトは、これらのユニットへの供給を維持しようとします。
AIワークロードがハードウェアに与える負荷
学習は、順方向計算、逆伝播、オプティマイザ更新、アクセラレータ間の通信を交互に行います。推論はバッチスコアリングからインタラクティブなトークン生成まで幅広いです。行列乗算は重要ですが、埋め込み、正規化、活性化関数、アテンション、ルーティング、キャッシュアクセス、ホストのオーケストレーションも実際の性能に寄与します。
演算強度(転送されたバイトあたりの計算量)は、ワークロードが計算寄りか帯域幅寄りかを説明する手がかりになります。小さなバッチサイズや自己回帰デコードは、重みやキャッシュデータを繰り返し取得する必要があるため、演算ユニットが十分に活用されないことが多いです。大きなバッチは利用率を上げますが、レイテンシとメモリ使用量が増加します。
数値フォーマットはトレードオフを変えます。FP32、BF16、FP16、FP8、整数フォーマットは、表現範囲、精度、ハードウェアサポート、誤差が異なります。混合精度学習は重要な演算を高精度で保持し、量子化推論はすべてのモデルが同じビット幅を許容するという保証ではなく、較正と品質テストが必要です。
システム経済性と将来の方向性
AIの総コストには、アクセラレータの購入またはレンタル、電力供給、冷却、ネットワーク、ストレージ、ソフトウェアエンジニアリング、アイドル容量、失敗した実験が含まれます。利用率が低い場合や、モデルが高価な分散トポロジーを必要とする場合、より高速なチップでも総コストは増加する可能性があります。定義された品質閾値で有用なアウトプットを測定してください。
スケーリングはデータとアルゴリズムにも制約されます。計算リソースを増やしても、ラベルが誤っているデータやショートカットを奨励する評価は修正できません。効率的なアテンション、より優れたオプティマイザ、スパース性、リトリーバル、蒸留、アルゴリズム的発見は、ハードウェアの比例的増加なしに結果を向上させますが、コストが別の領域にシフトすることがあります。
将来のシステムは、プロセス技術の進歩と三次元スタック、高帯域メモリ、光または高度な電気インターコネクト、ドメイン固有データフロー、共同設計されたソフトウェアを組み合わせます。ムーアの法則は有益な歴史的文脈として残りますが、計画時には測定されたワークロード曲線と現実的な供給、エネルギー、導入制約を考慮すべきです。
AIシステム設計におけるムーアの法則の正しい読み取り方
有用な分析では、トランジスタ密度、汎用CPU性能、アクセラレータのスループット、メモリ容量、メモリ帯域幅、インターコネクト、エネルギー、製造歩留まり、コストを分離して評価します。これらは同じ速度で向上しません。モデル重みの転送が支配的なAIワークロードは、演算ユニットが増えても大きな恩恵を受けにくく、一方でオンチップの小規模モデルは低精度の特殊ハードウェアから大きく利益を得られます。プロセスノードを性能とみなすのではなく、正確な指標、精度、ワークロード、電力範囲を明示してください。
AIモデルをスケールすると、ソフトウェアとシステムの要求も変化します。大規模な学習では、並列アルゴリズム、信頼性の高いチェックポイント、ハイスピードネットワーク、ストレージパイプライン、追加容量を活用できる十分なデータが必要です。推論時のレイテンシは、プロンプト長、生成トークン数、バッチング、キャッシュメモリ、サービスレベル目標に依存します。アルゴリズムの改良、スパース化、量子化、リトリーバル、より良いデータは、トランジスタのトレンドに左右されずに性能向上をもたらし、時にはハードウェア世代を超えることもあります。
計画時には、候補システム上で代表的なモデルをベンチマークし、導入期間全体の総コスト(取得またはクラウド料金、電力、冷却、利用率、エンジニアリング、移行、供給リスク)をモデル化してください。単一の指数予測ではなくシナリオを用いるべきです。ムーアの法則は統合経済学に関する有益な歴史的観測ですが、AIが固定されたスケジュールで比例的に速く、安く、より高性能、持続可能になることを保証するものではありません。
実装チェックリスト
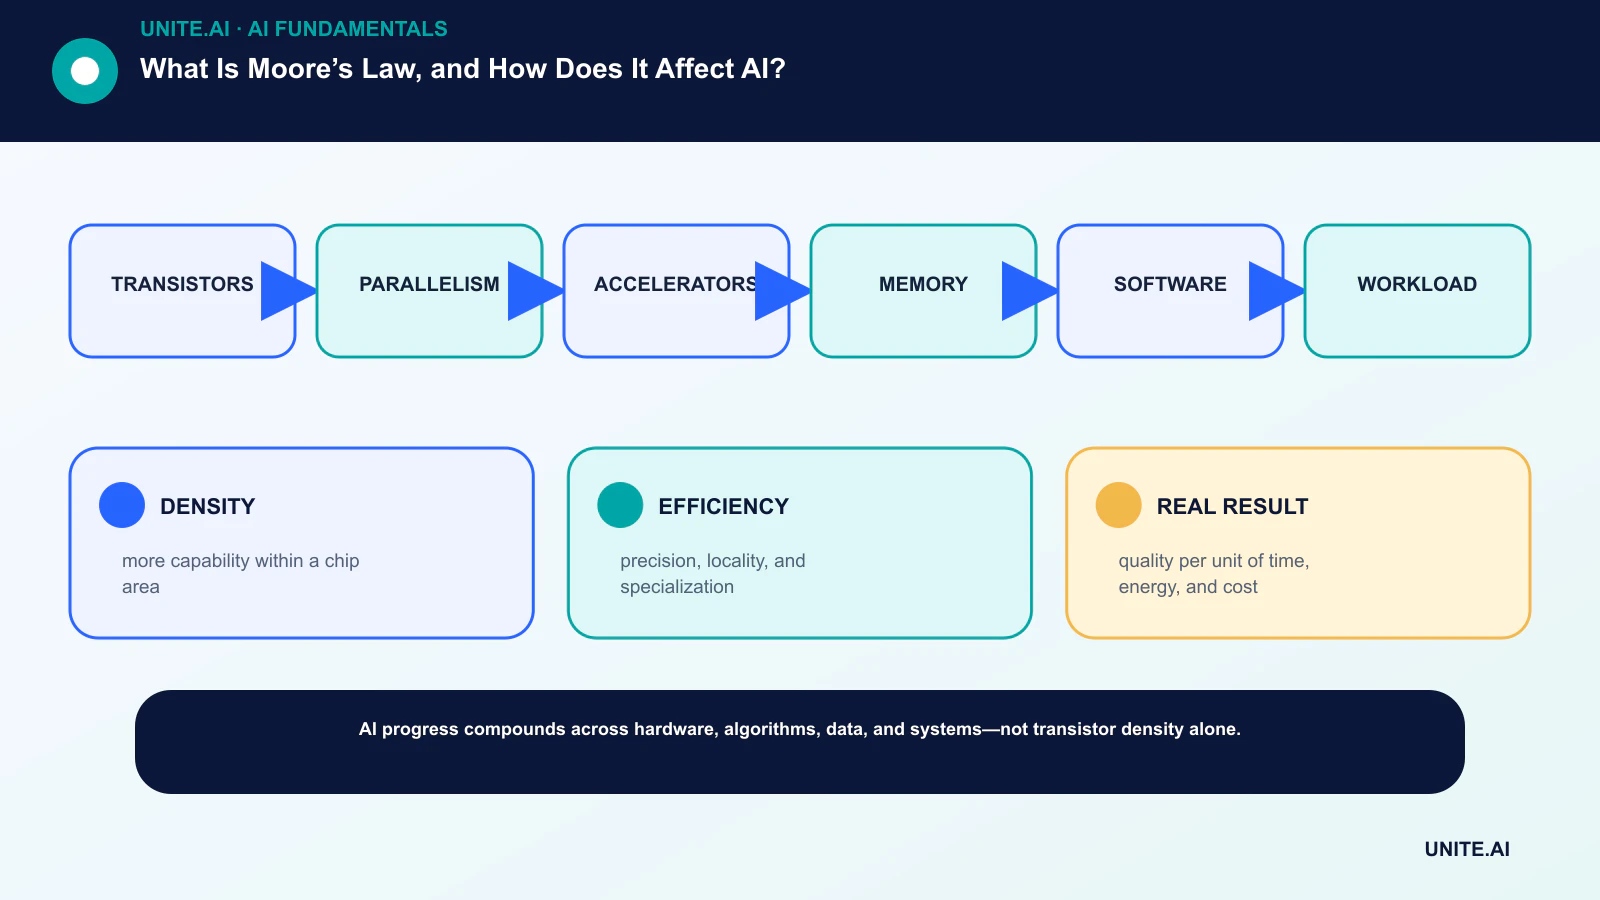
概念を限定的で検証可能なワークフローに変換します: トランジスタ → 並列性 → アクセラレータ → メモリ → ソフトウェア → ワークロード。責任者を明確にし、データと依存関係を文書化し、シンプルなベースラインを設定し、受入基準と停止基準を定め、代表的な障害をテストし、スコープ拡大前に監視、ロールバック、レビューを定義します。バージョンと前提条件を記録しておけば、別のチームが結果を再現し、変更点を把握できます。
リリース前に、システムを構築・運用・保護し、影響を受ける関係者と文書化された準備レビューを実施します。通常ケース、境界条件、依存失敗、誤用をテストし、証拠と未解決リスクを保存します。リリース承認、閾値変更、出力上書き、運用停止を行える人物を定義してください。実データが得られたら判断を再検討します。技術的に成功したパイロットが、規模拡大時の信頼性を保証するわけではありません。
- DENSITY: チップ面積あたりのより多くの能力。
- EFFICIENCY: 精度、局所性、専門化。
- REAL RESULT: 時間、エネルギー、コスト単位あたりの品質。
よくある質問
ムーアの法則は終わったのか?
単純な歴史的トレンドは鈍化し性質が変わりましたが、半導体の進歩はデバイス、アーキテクチャ、パッケージング、メモリ、ソフトウェアを通じて続いています。この表現がまだ適切かどうかは、指標次第です。
トランジスタが2倍になるとAI性能も2倍になるのか?
いいえ。性能はトランジスタの使い方や帯域幅、精度、モデル構造、ソフトウェア効率、電力、ワークロードの制約に依存します。
主要参考文献