
AIの基礎
フェデレーテッドラーニングとは何か?

 Unite.AI を Google の優先ソースに追加
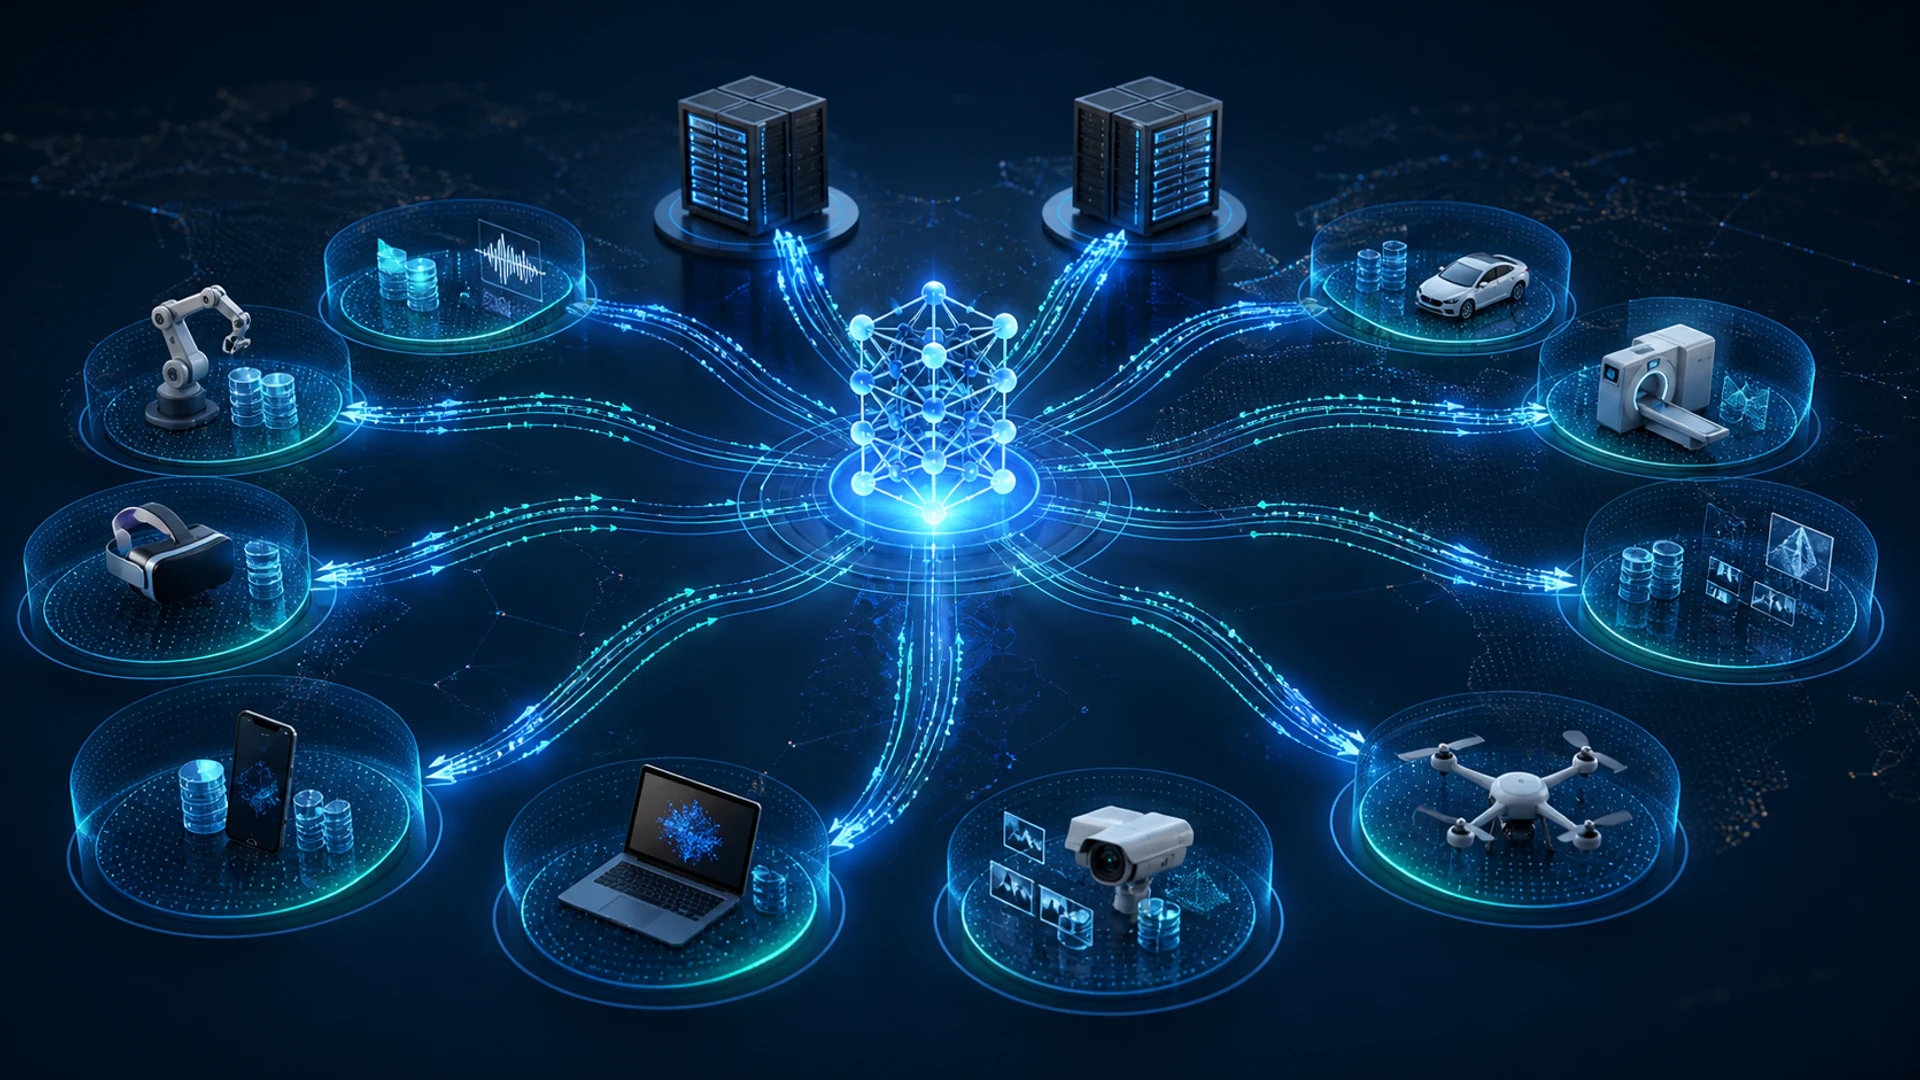
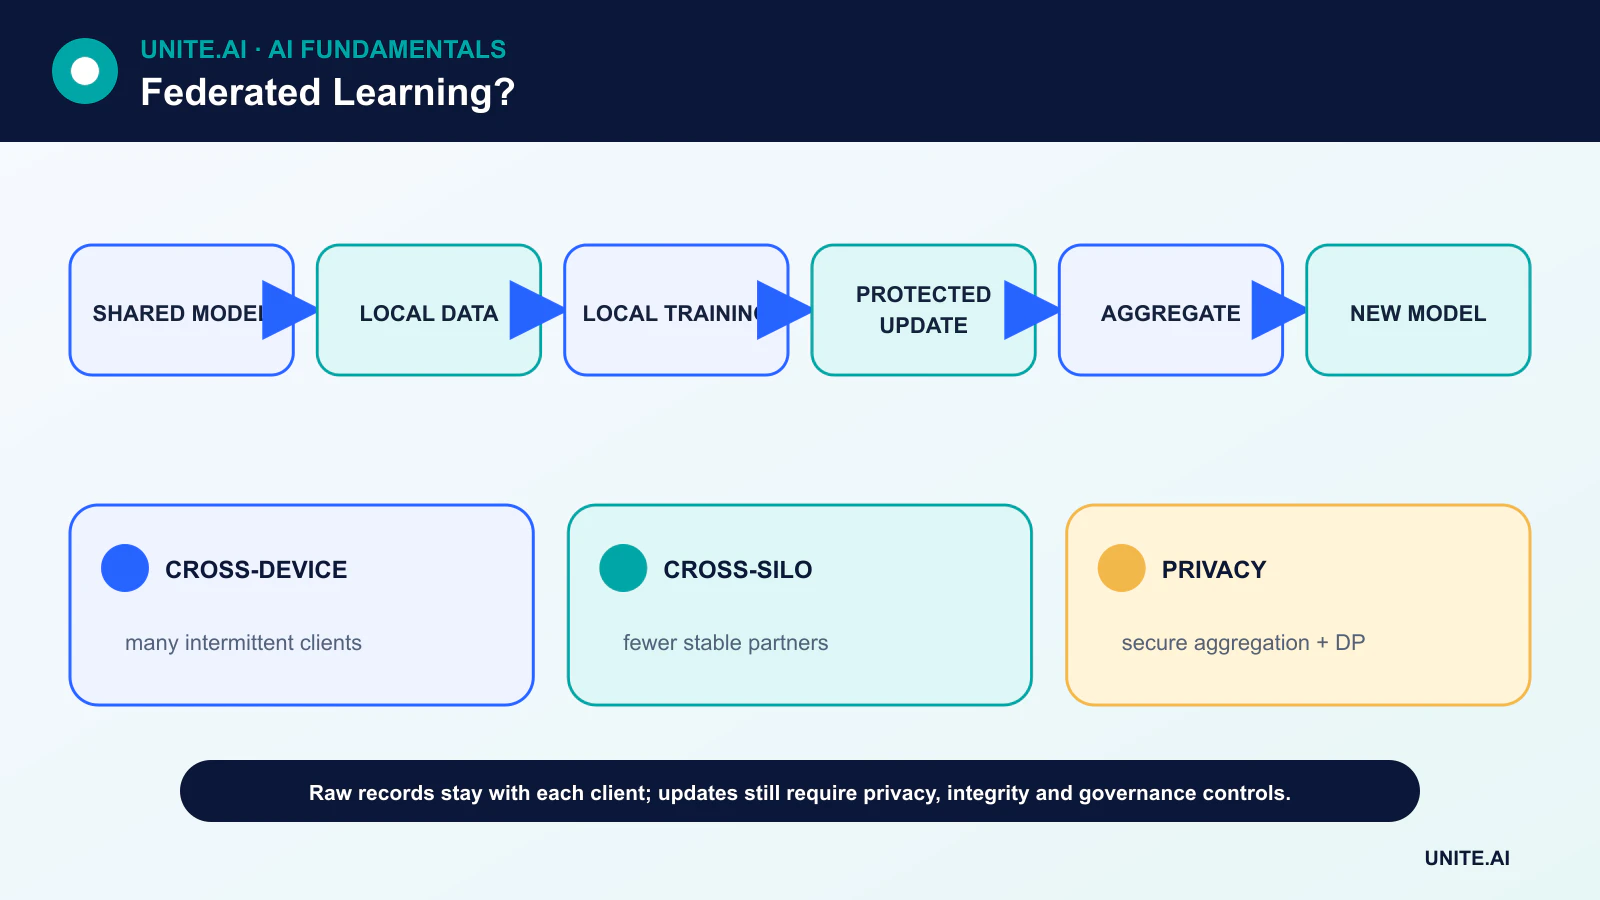
フェデレーテッドラーニングは、複数のデバイスや組織にまたがって共有モデルを学習させる手法で、各参加者の生データはローカルに残ります。コーディネーターがモデルパラメータを配布し、クライアントは自分のデータで更新を計算し、集約ステップでそれらの更新を統合します。
データをローカルに保つことは有用ですが、プライバシーやセキュリティと同義ではありません。モデルの更新から情報が漏れる可能性があり、侵害されたクライアントが学習を汚染することもあります。また、コーディネーターは認証、通信の安全性、アクセス制御、明確な信頼モデルを必要とします。
主なポイント
- フェデレーテッドラーニングは計算を分散データへ移すもので、生データセットを中央のトレーナーに移すことはありません。
- クロスデバイスシステムは多数の断続的デバイスを対象とし、クロスシロシステムは少数で安定した組織を対象とします。
- 安全な集約と差分プライバシーは異なるリスクに対応し、組み合わせて使用できます。
- 非IIDデータ、帯域幅の制限、参加の不安定さ、悪意ある更新は設計上の主要制約です。
フェデレーテッド平均化のライフサイクル
典型的なラウンドは、コーディネーターが適格クライアントを選択し、現在のモデルを送信するところから始まります。各クライアントは限定されたステップ数だけローカルで学習し、パラメータまたは勾配の更新を生成します。コーディネーターは、ローカルのサンプル数に基づく重み付けなどで適格な更新を集約し、新しい共有モデルを公開します。
ラウンドごとに参加できるクライアントは全体の一部に限られます。プロトコルは切断された接続、バージョン不一致、充電中・使用中・オフラインで学習できないデバイスを許容しなければなりません。通信コストが計算コストを上回ることが多く、更新の圧縮やラウンド回数の削減が、単なるアクセラレータ速度よりも重要になることがあります。
クロスデバイスとクロスシロの違い
クロスデバイスのフェデレーテッドラーニングは、個人が所有するスマートフォン、センサー、ブラウザなどを対象とします。クライアントは多数で、信頼度が低く、断続的に利用可能です。一方、クロスシロは病院、銀行、事業部門など、インフラが安定した少数の組織を結びつけます。
この二つの設定では、アイデンティティ、監査、障害時の前提が異なります。クロスシロプロジェクトは共有スキーマや検証プロセスを交渉できますが、クロスデバイスサービスは膨大なソフトウェアバージョンと極めて不均一なローカルデータセットを扱う必要があります。
安全な集約、差分プライバシー、暗号化
安全な集約は暗号プロトコルで、サーバーが各クライアントの更新内容を読み取らずに集計結果を復元できるようにします。差分プライバシーは、寄与をクリッピングし、校正されたノイズを加えることで、結果が特定のレコードや参加者にどれだけ依存するかを制限します。
いずれの手法もすべてのリスクを解決するわけではありません。安全な集約は集計自体を無害化しませんし、差分プライバシーは精度とプライバシーのトレードオフを伴い、明示的なプライバシーバジェットで管理する必要があります。暗号化は転送中や保存時のデータを保護しますが、モデルからの推論攻撃を単独で防ぐことはできません。
非IIDデータとモデル品質
クライアントデータはほとんどの場合、独立同分布(IID)ではありません。キーボードモデルは各ユーザーの語彙を学習し、病院は異なる患者層を、工場は異なる装置を扱います。これらの差異は収束を遅らせ、少数クライアントグループでの性能低下を隠すことがあります。
評価には全体指標だけでなく、クライアント別やコホート別の分布、キャリブレーション、失敗分析を含めるべきです。中央のテストセットは便利ですが不十分です。これはフェデレーテッドラーニングを機械学習のデータ品質や構造化・非構造化データガバナンスと結びつけます。
脅威と運用上の制御策
悪意あるクライアントは毒入り更新を送信でき、シビル(Sybil)クライアントは集約を歪め、侵害されたサーバーは標的モデルを配布できます。防御策としては、認証された登録、異常検知、ロバストな集約、更新の検証、レートリミット、実用的であれば再現可能なソフトウェア証明などがあります。
フェデレーテッドラーニングは広範なサイバーセキュリティプログラムの一部です。チームはコーディネーターの管理者、収集するメタデータ、参加者の退会方法、モデルのロールバック手順、プライバシーや品質テストが失敗した際の対応を文書化すべきです。
フェデレーテッド最適化とデータの不均質性
フェデレーテッドラーニングはモデルまたは更新タスクを参加クライアントに送信し、ローカルで学習させ、元データを集中させずに更新を集約します。フェデレーテッド平均化では、選択されたクライアントが複数のローカル最適化ステップを実行し、サーバーがサンプル数に基づく重み付け平均を計算します。通信ラウンド数、ローカルエポック数、選択方式、学習率は帯域幅と収束速度のトレードオフになります。クロスデバイス環境は多数の不安定なスマートフォンやセンサーを、クロスシロ環境は計算力・アイデンティティ・ガバナンスが強固な少数組織を対象とします。
クライアントデータは通常、非独立かつ不均一です: ユーザーは行動、ラベル分布、データ量、利用可能時間が異なります。ローカル学習が互換性のない方向にドリフトすると、単純平均が不安定になるか、アクティブで大量データを持つクライアントに偏ります。アルゴリズムは近接項、適応サーバー最適化、クラスタリング、パーソナライズ、制御変数などを利用できます。評価では全体およびクライアントレベルの性能、テールクライアント、参加頻度、収束、通信コスト、エネルギー消費を報告すべきです。優れた平均値は、少数または希少なクライアント集団が劣悪なモデルを受け取っていることを隠す可能性があります。
プライバシー、セキュリティ、システムエンジニアリング
データをローカルに保つだけではプライバシーは保証されません。勾配や更新からメンバーシップや特徴が漏れることがあり、最終モデルがサンプルを記憶することもあります。安全な集約はサーバーから個別更新を隠し、差分プライバシーはクリッピングとノイズ付加で情報寄与を制限しますが、いずれも有用性と運用複雑性に影響します。脅威モデル、プライバシーユニット、バジェット、信頼できるコンポーネントを明示してください。転送中の暗号化は必須ですが、悪意あるクライアント、毒入り更新、侵害されたコーディネーター、推論攻撃を防ぐわけではありません。
防御策としては、認証済みクライアント、ロバスト集約、異常チェック、更新上限、一部設計での安全エンクレーブ、クリーンデータとの検証があります。シビル攻撃者は多数のクライアントを生成でき、バックドアは平均化を通過でき、疑わしい更新を除外すると正当な希少行動も除外される恐れがあります。クライアントコードのバージョン管理、途中でのラウンド中断への対応、リプレイ防止、遅延クライアントやデバイス制約への設計が必要です。ローカルデータと派生更新にも同意、保持、地域規則、削除が適用されます。
導入とガバナンスの例
モバイルキーボードは次語予測をローカルで学習できますが、展開はデバイス性能と同意に基づく対象ユーザーに限定し、クリッピングされた保護更新を収集し、凍結ベースラインと比較すべきです。言語・方言の性能、バッテリ消費、データ利用、記憶リスクをリリース前に検証します。クライアントは署名された学習タスクとモデル更新を必要とし、サーバーは監査可能なラウンド設定とロールバックを保持します。フェデレーテッドラーニングは制約下での分散学習アーキテクチャであり、代表的なデータ、プライバシーエンジニアリング、説明責任の代替ではありません。
実例:病院間でのフェデレーテッドラーニング
病院はスキャン画像をプールせずに、共有画像品質モデルを学習します。共通プロトコルはデバイスメタデータ、ラベル、前処理、クライアント適格性、ローカルエポック、クリッピング、安全な集約を定義します。各拠点は患者データを保持し保護更新を送信し、コーディネーターはローカルのホールドアウトセットで各ラウンドを評価します。結果は拠点別およびテール性能を報告し、単なるボリューム加重平均に留まらないようにします。これは小規模病院やデバイスタイプが無視されるのを防ぎます。
脅威モデルは悪意ある更新、メンバーシップ漏洩、侵害されたクライアント、コーディネーターへのアクセスをカバーします。差分プライバシーは文書化されたバジェットで設定され、実用性がテストされています。モデルとタスクパッケージは署名され、拠点は撤回可能で更新は監査可能です。毒入りまたは不安定なラウンドが自動的にデプロイ済みモデルを置き換えることはありません。プロジェクトはローカルベースラインと臨床レビューを保持し、フェデレーテッドアーキテクチャを広範な同意、セキュリティ、ガバナンス義務の中の一つのプライバシー制御として扱います。
実装証拠と運用準備性
本番導入の判断は単なる成功デモだけでは不十分です。対象ユーザー、運用環境、入力・出力、依存関係、所有者、重要な失敗ごとの影響を定義してください。チューニング前に再現可能なベースラインとバージョン管理された評価セットを確立します。通常ケース、境界条件、欠損または不正な入力、分布シフト、依存サービスの停止、誤用、過小評価されがちなユーザー層や環境をテストします。タスク品質をキャリブレーションや不確実性、レイテンシ、スループット、リソースコスト、アクセシビリティ、プライバシー、セキュリティと共に測定します。すべての変換と閾値を記録し、独立したレビューアが結果を再現でき、魅力的なプロトタイプと証拠を区別できるようにします。
リリース前に、リリース、例外、変更、ロールバック、廃止の権限を割り当てます。段階的ロールアウトを用い、安全なフォールバックを保持し、意図的に注入した障害でモニタリングを検証します。運用テレメトリは入力品質、出力挙動、モデルまたはルールのバージョン、依存性の健康状態、人間によるオーバーライド、確認された結果を示すべきで、不要な機微データは収集しません。アラート閾値と対応責任者を定義し、デプロイ後に実世界の証拠をレビューします。データソース、ユーザー、モデル、ベンダー、ポリシー、ハードウェア、目標が変わるたびに再評価します。維持されたシステムは、文書化された復旧手順、インシデント学習、削除・保持手順、そして無効化または置換すべき明確なタイミングも必要です。
よくある質問
フェデレーテッドラーニングはプライベートデータが漏れないことを保証しますか?
いいえ。生データの移動は減少しますが、更新や最終モデルから情報が漏れる可能性は残ります。プライバシーを確保するには脅威モデルと追加の技術的・組織的制御が必要です。
集中トレーニングの方がシンプルなのはいつですか?
データを合法かつ安全に集中化できる場合、集中トレーニングはデバッグ、再現、モニタリングが容易になることが多いです。フェデレーテッドラーニングは、分散が実際の要件である場合にのみ正当化されます。単なるブランディング目的ではありません。
主要参考文献












