
AIモデルとプラットフォーム
グリーンスクリーン生成の改善について

 Unite.AI を Google の優先ソースに追加
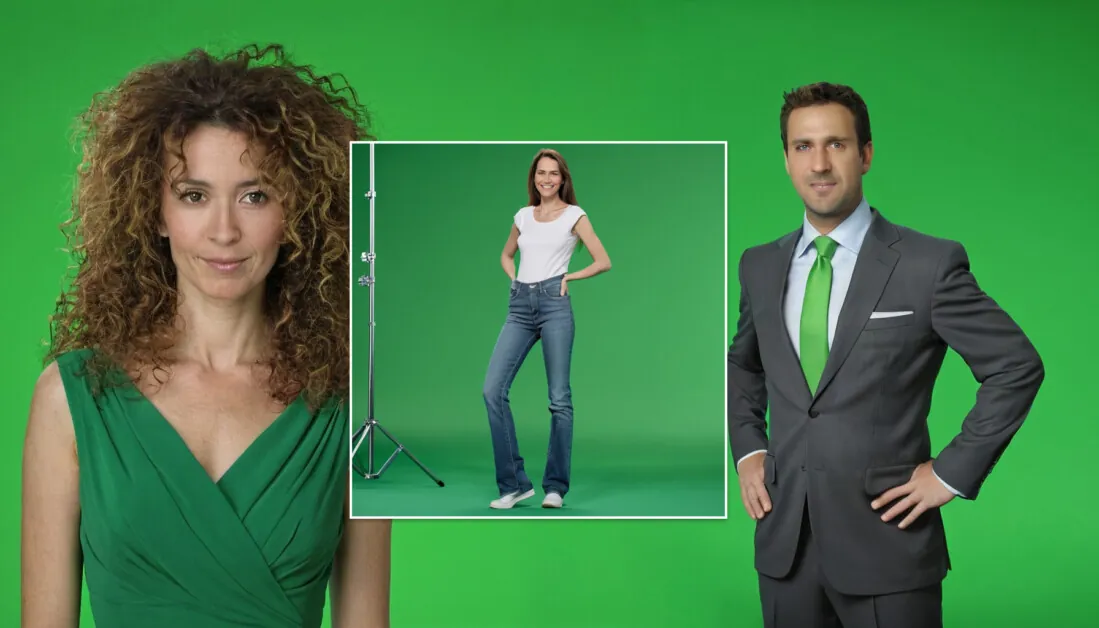
コミュニティや投資家の視覚的なジェネレーティブAIへの熱狂的な支持にもかかわらず、こうしたシステムの出力は、常に現実世界での使用に適しているわけではありません。たとえば、ジェネレーティブAIシステムは、通常、個々の分離された要素ではなく、画像(またはビデオの場合には画像のシリーズ)全体を出力します。これは、マルチメディアや視覚効果の実践者にとって、さまざまなアプリケーションで必要なものとは異なります。
単純な例として、ユーザーが選択したターゲット背景の上に「浮かぶ」ように設計されたクリップアートがあります。

ライトグレーのチェッカーボックス背景は、Photoshopユーザーにとって最も馴染み深いものであり、シンプルな消費者向けアイテムであるストック画像においてさえも、アルファチャンネルまたは透明度チャンネルを表すものとなっています。
このような透明度は、30年以上前に一般的に利用可能になりました。1990年代初頭のデジタル革命以来、ユーザーは、増々高度化したツールセットとテクニックのシリーズを通じて、ビデオと画像から要素を抽出できるようになりました。
たとえば、ビデオ映像の青背景やグリーンスクリーン背景を「落とす」ことの課題は、かつては高価な化学プロセスや光学プリンター(および手作りのマット)の専門的なものでしたが、AdobeのAfter EffectsやPhotoshopアプリケーション(およびその他多数の無料および独自のプログラムとシステム)などのシステムでは、数分で実行できるようになりました。
要素を分離した後、アルファチャンネル(基本的に、関連のないコンテンツを隠すマスク)を使用して、ビデオ内の任意の要素を新しい背景の上に簡単に重ねたり、他の分離された要素と組み合わせたりできます。

アルファチャンネルの例。下行にその効果が示されています。ソース:https://helpx.adobe.com/photoshop/using/saving-selections-alpha-channel-masks.html
ドロップアウト
コンピュータビジョンでは、アルファチャンネルの作成は、セマンティックセグメンテーションの範疇にあり、MetaのSegment Anythingのようなオープンソースプロジェクトは、セマンティクスを強化したオブジェクト認識を介して、ターゲットオブジェクトを分離/抽出するためのテキストプロンプト可能な方法を提供しています。
Segment Anythingフレームワークは、Alpha-CLIPプロジェクトのような、視覚効果の抽出と分離のワークフローで幅広く使用されています。

Segment Anythingを使用した抽出の例、Alpha-CLIPフレームワーク:ソース:https://arxiv.org/pdf/2312.03818
アルファチャンネルを割り当てるための多数の代替セマンティックセグメンテーション方法があります。
しかし、セマンティックセグメンテーションは、抽出する必要があるすべてのオブジェクトのカテゴリを含まない可能性のある、トレーニングデータに依存しています。大量のデータでトレーニングされたモデルは、より広範なオブジェクトの認識を可能にします(基本的に、世界モデルまたは基礎モデルになります)が、それでもトレーニングで最も効果的に認識されるクラスに制限されます。

セグメンテーションシステムの例、Segment Anything。特定のオブジェクトやオブジェクトの一部を識別するのに苦労することがあります。ソース:https://maucher.pages.mi.hdm-stuttgart.de/orbook/deeplearning/SAM.html
いずれにせよ、セマンティックセグメンテーションは、グリーンスクリーン手順と同様に、事後プロセスであり、単一の色の背景スワスを認識して削除する利点がないまま要素を分離する必要があります。
このため、ユーザーコミュニティは、グリーンスクリーン背景を含む画像やビデオを生成し、従来の方法で簡単に削除できるという考えにたびたび出会ってきました。
不幸にも、潜在的拡散モデルであるStable Diffusionのような人気のあるモデルは、実際にグリーンスクリーンをレンダリングするのに苦労することがあります。これは、モデルがトレーニングされたデータセットが、このような特殊なシナリオの例を多く含んでいないためです。システムが成功したとしても、「グリーン」の概念は、エンタングルメントにより、前景の主題に望ましくない方法で広がります。

上図は、Stable Diffusionが画像の忠実性を、単一のグリーンの強度を作成する必要性よりも優先していることを示しています。実際のグリーンスクリーンシナリオで発生する現実世界の問題を効果的に再現しています。下図は、「グリーン」の概念が前景画像を汚染していることを示しています。プロンプトが「グリーン」の概念に焦点を当てているほど、この問題は悪化する可能性があります。ソース:https://stablediffusionweb.com/
上記の下の画像では、女性のドレスや男性のネクタイ(上図)がグリーンの背景とともに「ドロップアウト」する傾向があります。これは、1970年代と1980年代の写真化学エマルション染料除去の時代に遡る問題です。
いつものように、モデルの欠点は、特定のデータを問題に投げ込むことで、そして多大なトレーニングリソースを費やすことで克服できます。スタンフォードの2024年のオファーであるLayerDiffuseのようなシステムは、ファインチューニングされたモデルを作成し、アルファチャンネルを備えた画像を生成できます。

スタンフォードのLayerDiffuseプロジェクトは、モデルの透明度機能を付与するために、適切な画像100万枚でトレーニングされました。ソース:https://arxiv.org/pdf/2402.17113
不幸にも、このアプローチには、カーソルとトレーニングリソースが大量に必要です。また、LayerDiffuseで使用されるデータセットは公開されていないため、このモデルをトレーニングしたモデルを使用することはできません。さらに、このアプローチは、特定のユースケースにカスタマイズまたは開発することが困難です。
2024年の少し後、Adobe (ADBE ) Researchは、Stonybrook Universityと共同で、MAGICKを発表しました。これは、カスタム作成された拡散画像でトレーニングされたAI抽出アプローチです。

2024年の論文からのMAGICKの細かいアルファチャンネル抽出の例。ソース:https://openaccess.thecvf.com/content/CVPR2024/papers/Burgert_MAGICK_A_Large-scale_Captioned_Dataset_from_Matting_Generated_Images_using_CVPR_2024_paper.pdf
150,000個の抽出されたAI生成オブジェクトを使用して、MAGICKをトレーニングし、システムが抽出についての直感的な理解を発達させるようにしました。

MAGICKトレーニングデータセットのサンプル。
このデータセットは、論文で述べられているように、生成するのが非常に難しいものでした。なぜなら、拡散方法は、実際に色付け可能な一貫した色のスワスを生成するのに苦労するからです。したがって、生成されたマットの手動選択が必要でした。
このロジスティックボトルネックは、カスタマイズや開発が容易ではないシステムにつながります。代わりに、初期トレーニングの範囲内で使用する必要があります。
TKG-DM – ‘ネイティブ’クロマキーエクストラクションのための潜在的拡散モデル
ドイツと日本の研究者の新しいコラボレーションは、上記の方法よりも優れた結果を得ることができると主張されている、トレーニングされた方法の代替案を提案しました。特に、特にカスタマイズされたデータセットでトレーニングする必要はありません。

TKG-DMは、生成画像をシードするランダムノイズを変更して、任意の色の実際に色付け可能な背景を生成する能力を高めます。ソース:https://arxiv.org/pdf/2411.15580
新しい方法は、ランダムノイズを最適化することで、問題に取り組みます。これは、潜在的拡散モデル(LDM)の生成画像のシードとなります。たとえば、Stable Diffusionの場合です。
アプローチは、以前のStable Diffusion分布の色スキーマに関する調査に基づいています。また、他の方法と比較して、背景色のエンタングルメントが少なく(またはまったくない)任意の背景色を生成することができます。

初期ノイズは、デノイジングプロセスの側面に影響を与えることができるチャネル平均シフトによって条件付けられますが、色信号を前景コンテンツにエンタングルメントしません。
論文には以下のように記載されています。
「私たちの包括的な実験は、TKG-DMがFIDとマスクFIDスコアをそれぞれ33.7%と35.9%改善することを示しています。」
「したがって、私たちのトレーニング不要モデルは、ファインチューニングされたモデルと同等の結果を提供し、さまざまな視覚コンテンツ作成タスクで正確な前景と背景コントロールが必要な場合に、効率的で柔軟なソリューションを提供します。」
新しい論文は、TKG-DM:トレーニング不要のクロマキーコンテンツ生成拡散モデルと題され、東京の Hosei University とドイツの RPTU Kaiserslautern-Landau & DFKI GmbH の7人の研究者によって書かれています。
方法
新しいアプローチは、チャネル平均シフト(CMS)を使用して、Stable Diffusionのアーキテクチャを拡張します。これにより、生成された結果で望ましい背景/前景分離を促進するように、初期のガウシアンノイズを条件付けることができます。

提案されたシステムのワークフローのスキーマ。
CMSは、デノイジングプロセスの全体的な進行を維持しながら、各色チャネルの平均を調整します。
著者は以下のように説明しています。
「クロマキーバックグラウンド上の前景オブジェクトを生成するために、初期ノイズと初期カラーノイズを2Dガウシアンノイズマスクを使用して選択的に組み合わせる初期ノイズ選択戦略を適用します。」
「このマスクは、前景領域の元のノイズを保持し、背景領域に色シフトされたノイズを適用することで、段階的な遷移を生成します。」

背景クロマカラーの色チャネルは、nullテキストプロンプトでインスタンス化され、前景コンテンツはユーザーのテキスト指示から семantically生成されます。
セルフアテンションとクロスアテンションを使用して、画像の2つの側面(クロマバックグラウンドと前景コンテンツ)を分離します。セルフアテンションは前景オブジェクトの内部的一貫性に役立ち、クロスアテンションはテキストプロンプトへの忠実性を維持します。論文では、背景画像は通常、生成で詳細で強調されていないため、その影響が比較的容易に克服され、純色のスワスに置き換えられることも指摘しています。

クロマスタイル生成プロセスにおけるセルフアテンションとクロスアテンションの影響の視覚化。
データとテスト
TKG-DMは、Stable Diffusion V1.5とStable Diffusion SDXLでテストされました。画像はそれぞれ512x512pxと1024x1024pxで生成されました。
画像は、DDIMスケジューラーを使用して、Stable Diffusionのガイダンススケール7.5で、50回のデノイジングステップで生成されました。ターゲット背景色は、現在支配的なドロップアウト方法であるグリーンでした。
新しいアプローチは、MAGICKで使用された設定でDeepFloydと比較されました。また、ファインチューニングされた低ランク拡散モデルであるGreenBack LoRAと、先ほど述べたLayerDiffuseにも比較されました。
データとして、MAGICKデータセットの3000枚の画像が使用されました。

新しいシステムのテストに使用されたMAGICKデータセットからの例。ソース:https://ryanndagreat.github.io/MAGICK/Explorer/magick_rgba_explorer.html
メトリックとして、Fréchet Inception Distance(FID)が前景の品質を評価するために使用されました。また、BiRefNetシステムを使用して、生成されたマスクの品質を評価するためのプロジェクト固有のメトリックであるm-FIDも開発されました。

BiRefNetシステムと以前の方法の視覚的な比較。ソース:https://arxiv.org/pdf/2401.03407
入力プロンプトとのセマンティック整合性をテストするために、CLIP-Sentence(CLIP-S)とCLIP-Image(CLIP-I)メソッドが使用されました。CLIP-Sはプロンプトの忠実性を評価し、CLIP-Iはグラウンドトゥルースとの視覚的な類似性を評価します。

新しい方法の最初のセットの定性的結果、Stable Diffusion V1.5の場合。ソースPDFを参照してください。
著者は、結果(上記と下記、SD1.5とSDXL)が、プロンプトエンジニアリングやモデルのトレーニング/ファインチューニングの必要性なしに、優れた結果を得るTKG-DMの能力を示していることを主張しています。

SDXLの定性的結果。ソースPDFを参照してください。
彼らは、背景にグリーンを生成するプロンプトが与えられた場合、Stable Diffusion 1.5はクリーンな背景を生成するのに苦労しているのに対し、SDXL(多少マシなパフォーマンス)では、クロマプロセスで分離するのが困難な、不安定なライトグリーン色調が生成されることを観察しています。
彼らはさらに、LayerDiffuseは分離された背景を生成するものの、時折詳細(たとえば、正確な数字や文字)を失い、これをデータセットの制限に起因するものとしています。また、マスク生成も時折失敗し、「カットされていない」画像が生成されることもあると述べています。
定量的なテストでは、LayerDiffuseはSDXLでFIDの点で優れているように見えますが、著者は、これは、基本的に「焼き付け」された製品である専用のデータセットの結果であると強調しています。データセットに含まれていない、または十分にカバーされていないオブジェクトやクラスは、同様のパフォーマンスを示さない可能性があり、さらにファインチューニングして新しいクラスを収容することは、ユーザーにカーソルとトレーニングの負担を課すことになります。

比較の定量的結果。論文では、LayerDiffuseの明らかな優位性は、柔軟性の欠如と、データのカーソルとトレーニングの負担のために来ていると示唆しています。
論文には以下のように記載されています。
「DeepFloydの高いFID、m-FID、CLIP-Iスコアは、DeepFloydの出力がグラウンドトゥルースに基づいており、イメージ品質のベンチマークとしては適していないことを反映しています。さらに、CLIP-Sスコアが低いことは、テキストとの整合性が弱いことを示しています。」
「全体として、これらの結果は、ファインチューニングなしで、高品質でテキスト整合性のある前景を生成する私たちのモデルの能力を強調しており、効率的なクロマキーコンテンツ生成ソリューションを提供しています。」
最終的に、研究者は、さまざまな方法のプロンプトへの従順性を評価するために、ユーザー研究を実施しました。100人の参加者が、各方法から30の画像ペアを評価するよう求められました。すべての例について、BiRefNetと手動の精製を使用してオブジェクトを抽出しました。著者のトレーニング不要アプローチは、この研究で優先されました。

ユーザー研究の結果。
TKG-DMは、Stable Diffusion用のサードパーティシステムであるControlNetと互換性があり、著者は、ControlNetのネイティブなこのような分離を実現する能力よりも優れた結果を生成することを主張しています。
結論
この新しい論文から最も注目すべき点は、潜在的拡散モデルのエンタングルメントの程度です。これは、モデルの側面を生成されたコンテンツで簡単に分離できるという一般的な認識とは対照的です。
この研究はさらに、研究および趣味のコミュニティが、モデルの欠点に対する事後的な解決策としてファインチューニングに頼る程度を強調しています。これは、ファインチューニングされたモデルは、特定のクラスやオブジェクトのタイプで非常にうまく機能するか、または多数のクラスやオブジェクトで「妥協」して機能するかのどちらかです。ただし、トレーニングセット内のデータの量に応じて、後者は効果が低下する可能性があります。
したがって、トレーニング不要のソリューションが存在することを確認することは、少なくとも一つの解決策が、労働集約的で、ある意味では不誠実な解決策に頼る必要がないことを示しています。
* 1978年の映画「スーパーマン」の撮影では、俳優クリストファー・リーヴは、青いスーパーマンコスチュームが消え去らないように、ブルースクリーンプロセス撮影のためにターコイズ色のスーパーマンコスチュームを着用しなければなりませんでした。コスチュームの青い色は、後にカラーグレーディングによって復元されました。


