Andersonの視点
AIがビデオ会議で緊張する話し手による聴衆の反応の把握を支援

 Unite.AI を Google の優先ソースに追加
2013年、一般的な恐怖症に関するアンケートでは、多くの回答者にとって、公共の場での話すことの恐怖は、死の恐怖よりもひどいものであった。この症状は、スピーチ恐怖症(グロソフォビア)として知られている。
COVID-19によって、対面の会議からオンラインのZoomやGoogle Spacesなどで行う会議への移行が進んだが、意外にも状況は改善されていない。参加者が多数いる会議では、低解像度の参加者アイコンや顔の表情、ボディランゲージの微妙な視覚的信号を読み取る能力が損なわれる。Skypeは、非言語的な信号を伝えるプラットフォームとしては不適切であることがわかっている。
認識された関心や反応のある聴衆の影響を受ける公共の話すパフォーマンスは、既に十分に文書化されており、多くの人にとっては直感的に明らかである。透明性のない聴衆の反応は、スピーカーが躊躇して、filler speechに戻る原因となり、自分の議論が賛成、軽蔑、または無関心に遭遇しているかどうかを知ることができない。多くの場合、スピーカーとリスナーにとって、不快な経験となる。
COVID-19の制限と予防措置によるオンラインビデオ会議への急速な移行の圧力の下、この問題はさらに悪化し、コンピュータビジョンと感情研究コミュニティでは、過去2年間でいくつかの緩和策が提案されている。
ハードウェアに焦点を当てたソリューション
しかし、これらの多くは、追加の機器や複雑なソフトウェアが必要であり、プライバシーまたはロジスティクス上の問題を引き起こす可能性がある。こうした方法はパンデミック以前からあり、比較的高コストであったり、利用できる資源に制約があったりする。2001年、MITは、Galvactivatorを提案した。これは、手に装着するデバイスで、聴衆の感情状態を推測し、1日間のシンポジウムでテストされた。

2001年のMITのGalvactivator。聴衆の感情と関心を理解するために、皮膚の導電率反応を測定した。 ソース: https://dam-prod.media.mit.edu/x/files/pub/tech-reports/TR-542.pdf
また、「クリッカーズ」の導入にも多くの学術的エネルギーが費やされてきた。クリッカーズは、聴衆の参加を増やすための手段としてだけでなく、話し手を励ます手段とも考えられている。聴衆応答システム(ARS)として視聴者自身が能動的なフィードバック提供者になるため、参加意識も高まる。
スピーカーと聴衆を「接続」する他の試みには、心拍数の測定、複雑な体に装着する機器を使用して脳波を利用すること、コンピュータビジョンによる感情認識、「チアメーター」やデスクワーカー向けの感情認識、およびスピーカーの演説中に聴衆が送信する絵文字の使用が含まれる。

2017年のミュンヘン大学とシュトゥットガルト大学の共同研究プロジェクト、EngageMeter。 ソース: http://www.mariamhassib.net/pubs/hassib2017CHI_3/hassib2017CHI_3.pdf
収益性の高い聴衆分析の一分野として、民間部門は視線推定と追跡に強い関心を持っている。聴衆の各人は、後に自分も話す立場になるかもしれないが、関心や賛同の指標として眼球追跡の対象となる。
これらの方法はすべて比較的高フリクションである。多くの場合、特定のハードウェア、研究室環境、特殊なソフトウェアフレームワーク、または高価な商用APIへのサブスクリプションが必要である。
したがって、ビデオ会議ツールに頼るだけで、専用ハードウェアやソフトウェアを必要としない、最小限のシステムの開発が過去18か月に注目されている。
聴衆の承認を微妙に報告する
この目的のために、東京大学とカーネギーメロン大学の共同研究により、標準のビデオ会議ツール(例:Zoom)と連携し、ウェブカメラが搭載されたウェブサイトで軽量の視線推定と姿勢推定ソフトウェアを実行する新しいシステムが提案された。この方法では、ローカルブラウザープラグインの必要性さえも回避される。
ユーザーの頷きと推定された視線は、スピーカーに視覚化される代表的なデータに変換され、コンテンツが聴衆をどの程度引き付けるかをその場で確かめられる。さらに、話し手がどの部分で聴衆の関心を失いかけているかを大まかに示すこともできる。
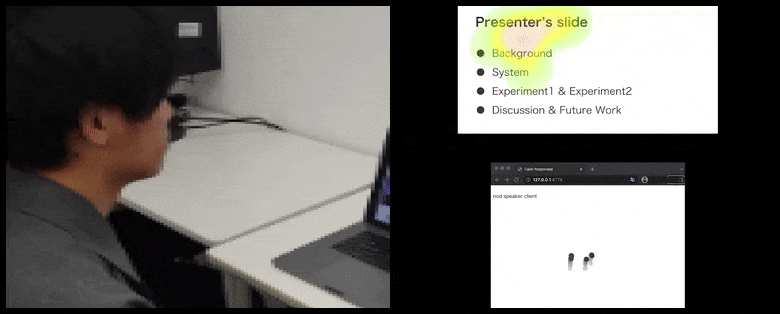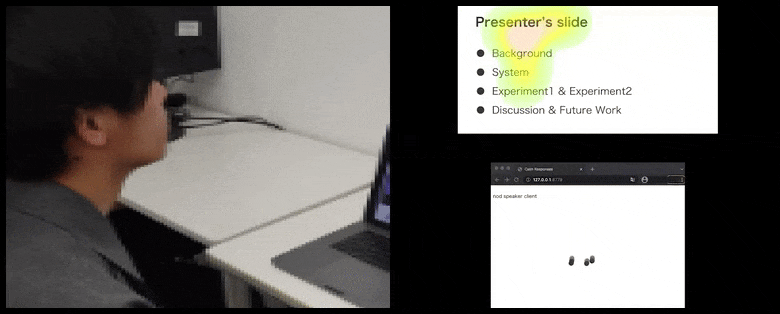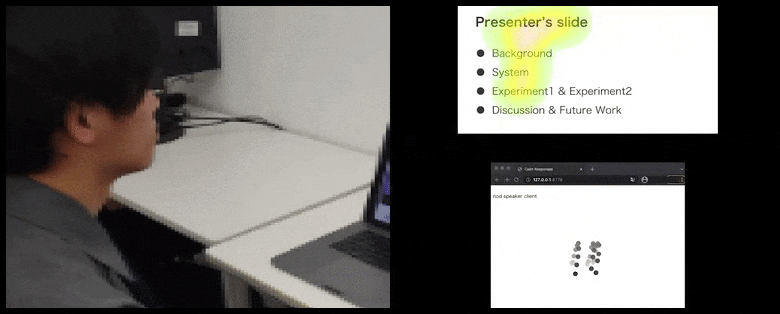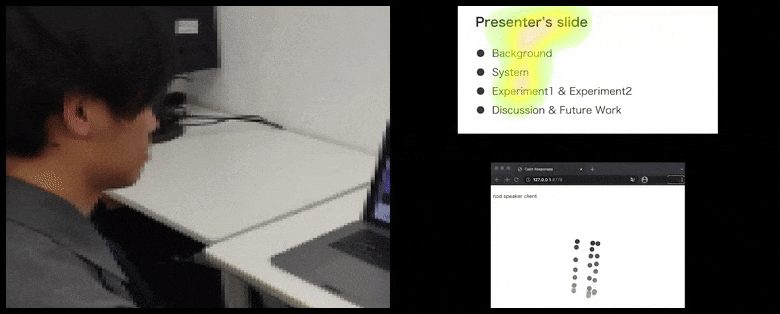
CalmResponsesでは、ユーザーの注意と頷きがプール化され、視覚的な表現に変換され、スピーカーに利益をもたらす。記事の最後に埋め込まれたビデオを参照してください。 ソース: https://www.youtube.com/watch?v=J_PhB4FCzk0
オンライン講義などでは、学生が背景やそのときの外見を映したくないため、話し手から姿が見えない場合がある。CalmResponsesは学生の映像を他の参加者へ送信せずに、視線の方向や頷きを報告できる。ただし、その動きを端末内で検出するためにウェブカメラ自体は引き続き必要である。
論文のタイトルは、CalmResponses: Displaying Collective Audience Reactions in Remote Communicationで、東京大学の2人とカーネギーメロン大学の1人の研究者による共同研究である。
研究者たちは、ウェブベースのデモを提供し、GitHubでソースコードを公開している。
CalmResponsesフレームワーク
CalmResponsesが他の頭の姿勢ではなく頷きに注目するのは、一部がダーウィンの時代に遡る研究で、聴衆の頭の動きの80%以上は頷きで構成されると示されているためである。これは反対の意思を示す場合にも当てはまる。同時に、多くの研究結果で、視線の動きは関心や参加意識の信頼できる指標と示されている。
CalmResponsesは、HTML、CSS、JavaScriptで実装されており、3つのサブシステムで構成されている。オーディエンスクライアント、スピーカークライアント、サーバーである。オーディエンスクライアントは、ユーザーのウェブカメラからの視線や頭の動きのデータを、Herokuのクラウドアプリケーションプラットフォーム経由でWebSocketsで送信する。

オーディエンスの頷きを視覚化したもの。右側のアニメーションで、スピーカーとオーディエンス全員が確認できる。 ソース: https://arxiv.org/pdf/2204.02308.pdf
プロジェクトの眼球追跡部分では、WebGazerという、低遅延でウェブサイトから直接実行できる軽量なJavaScriptベースの眼球追跡フレームワークを使用した。
視線や姿勢を高精度に推定するより、簡単に実装でき、大まかな集団反応を認識できることが重要である。そのため、入力姿勢データを平均値に基づいて平滑化した上で、全体の反応推定に用いる。
頷きの動作は、clmtrackrというJavaScriptライブラリで評価される。これは、画像やビデオ内の顔に顔モデルを当てはめる。正則化されたランドマークの平均シフトを使用して、鼻のランドマークのみを監視することで、頷きの動作を追跡できる。

ユーザーの鼻先の位置の動きが、頷きに関連するオーディエンスの反応の集合に加わり、全参加者に集計した形で示される。
ヒートマップ
頷きの動作は、動的な点で表現される(上の画像と記事末のビデオを参照)が、視線は、スピーカーとオーディエンスが、共有プレゼンテーションスクリーンまたはビデオ会議環境で一般的な注意の焦点がどこにあるかを示すヒートマップで表現される。

全参加者が、一般的なユーザーの注意がどこに集まっているかを確認できる。論文は、他の参加者のギャラリー表示でもこの機能が使えるかには触れていない。その場合、さまざまな理由から特定の参加者に見かけ上の関心が向いていることが明らかになる可能性がある。
テスト
CalmResponsesのテスト環境は2つ設定され、3つの異なる状況で、暗黙のablation studyとして実施された。条件B(ベースライン)では、研究者は、学生の大多数がカメラをオフにしている、典型的なオンライン学生講義を再現した。条件CR-Eでは、スピーカーは視線のフィードバック(ヒートマップ)を確認できた。条件CR-Nでは、スピーカーは、オーディエンスからの視線と頷きの両方の動作を確認できた。
最初の実験シナリオは、条件Bと条件CR-Eで構成され、2番目のシナリオは、条件Bと条件CR-Nで構成されていた。スピーカーとオーディエンスの両方からフィードバックが得られた。
各実験では、3つの要素が評価された。プレゼンテーションの客観的および主観的評価(スピーカーによる自己報告式質問紙を含む)。その場の不安やためらいを示す、言いよどみを埋める言葉の回数。質的コメント。これらの基準は、一般的 評価指標であり、話し方の質や話し手の不安を測る際に使われる。
テストプールは、19〜44歳の38人で構成され、29人の男性と9人の女性で、平均年齢は24.7歳で、日本人または中国人であり、日本語を流暢に話すことができた。5〜7人の参加者で構成される6つのグループにランダムに分割され、参加者同士が互いに知り合いではなかった。
テストはZoomで実施され、最初の実験では5人のスピーカーがプレゼンテーションを行い、2番目の実験では6人のスピーカーがプレゼンテーションを行った。

オレンジのボックスで示された「filler」条件。一般的に、「filler」コンテンツは、システムからのオーディエンスのフィードバックの増加に比例して減少した。
研究者は、1人のスピーカーのfillerが著しく減少したこと、また「Condition CR-N」では、スピーカーがfillerフレーズをほとんど発しなかったことを指摘している。詳細な結果は論文を参照されたい。ただし、最も顕著な結果は話し手と聴衆による主観的評価に現れた。
オーディエンスからのコメントには以下のようなものがあった。
「私はプレゼンテーションに関与しているような気がした」[AN2]、「スピーカーのスピーチが改善されたかどうかはわかりませんが、他人の頭の動きの視覚化から、団結感を感じた」[AN6]
「スピーカーのスピーチが改善されたかどうかはわかりませんが、他人の頭の動きの視覚化から、団結感を感じた」
研究者は、このシステムがスピーカーに新しい種類の人工的なパウーズをもたらすことを指摘している。スピーカーは、進む前に視覚的なシステムを参照してオーディエンスのフィードバックを評価する傾向にある。
また、実験では避けにくい一種の白衣効果も指摘している。一部の参加者は、生体データを監視されることの潜在的なセキュリティ上の影響を気にして、行動が制約されたと感じた。
結論
このようなシステムの注目すべき利点の1つは、使用が終了すると、非標準の付加的なテクノロジーが完全に消え去ることである。ブラウザープラグインをアンインストールする必要がない。参加者にインストール手順を案内する必要もない。ただし、ウェブベースの仕組みには利用者による1〜2分の初期調整が必要である。ローカルソフトウェアのインストールやブラウザーベースのアドオン/拡張機能のインストールの許可についての懸念もない。
評価された顔の動きや眼球の動きは、専用のローカルマシンラーニングフレームワーク(例:YOLOシリーズ)を使用した場合と同じくらい正確ではないかもしれないが、このほとんど摩擦のないアプローチは、典型的なビデオ会議のシナリオでの広範な感情や態度の分析に十分な精度を提供する。何よりも、非常に安価である。
詳細や例については、以下のプロジェクトビデオを参照のこと。
初版は2022年4月11日に公開。