
Fondamenti di IA
Cos’è l’Apprendimento per Rinforzo da Feedback Umano (RLHF)?

 Aggiungi Unite.AI alle tue fonti preferite su Google
L’apprendimento per rinforzo da feedback umano (RLHF) è una famiglia di metodi che utilizza i giudizi umani per aiutare a ottimizzare un modello quando il comportamento desiderato è difficile da specificare con una semplice ricompensa automatica. Per i modelli linguistici, le persone confrontano comunemente le risposte candidate e un modello di preferenza appreso trasforma questi confronti in un segnale di addestramento.
RLHF può rendere un modello preaddestrato più utile o meglio allineato a una politica scritta, ma non garantisce veridicità o allineamento con ogni utente. Il risultato dipende da chi fornisce il feedback, da come vengono campionate le richieste, da ciò che il modello di ricompensa può rappresentare e da come è vincolata l’ottimizzazione.
Punti chiave
- RLHF solitamente segue il preaddestramento e il fine‑tuning supervisionato.
- Le preferenze a coppie addestrano un modello di ricompensa o di preferenza; l’ottimizzazione della politica favorisce output con punteggi più alti.
- Hacking della ricompensa, disaccordi tra annotatori, spostamento di distribuzione e sovra‑ottimizzazione rimangono rischi importanti.
- Valuta direttamente la politica finale per qualità del compito, sicurezza, calibrazione ed effetti su sottogruppi.
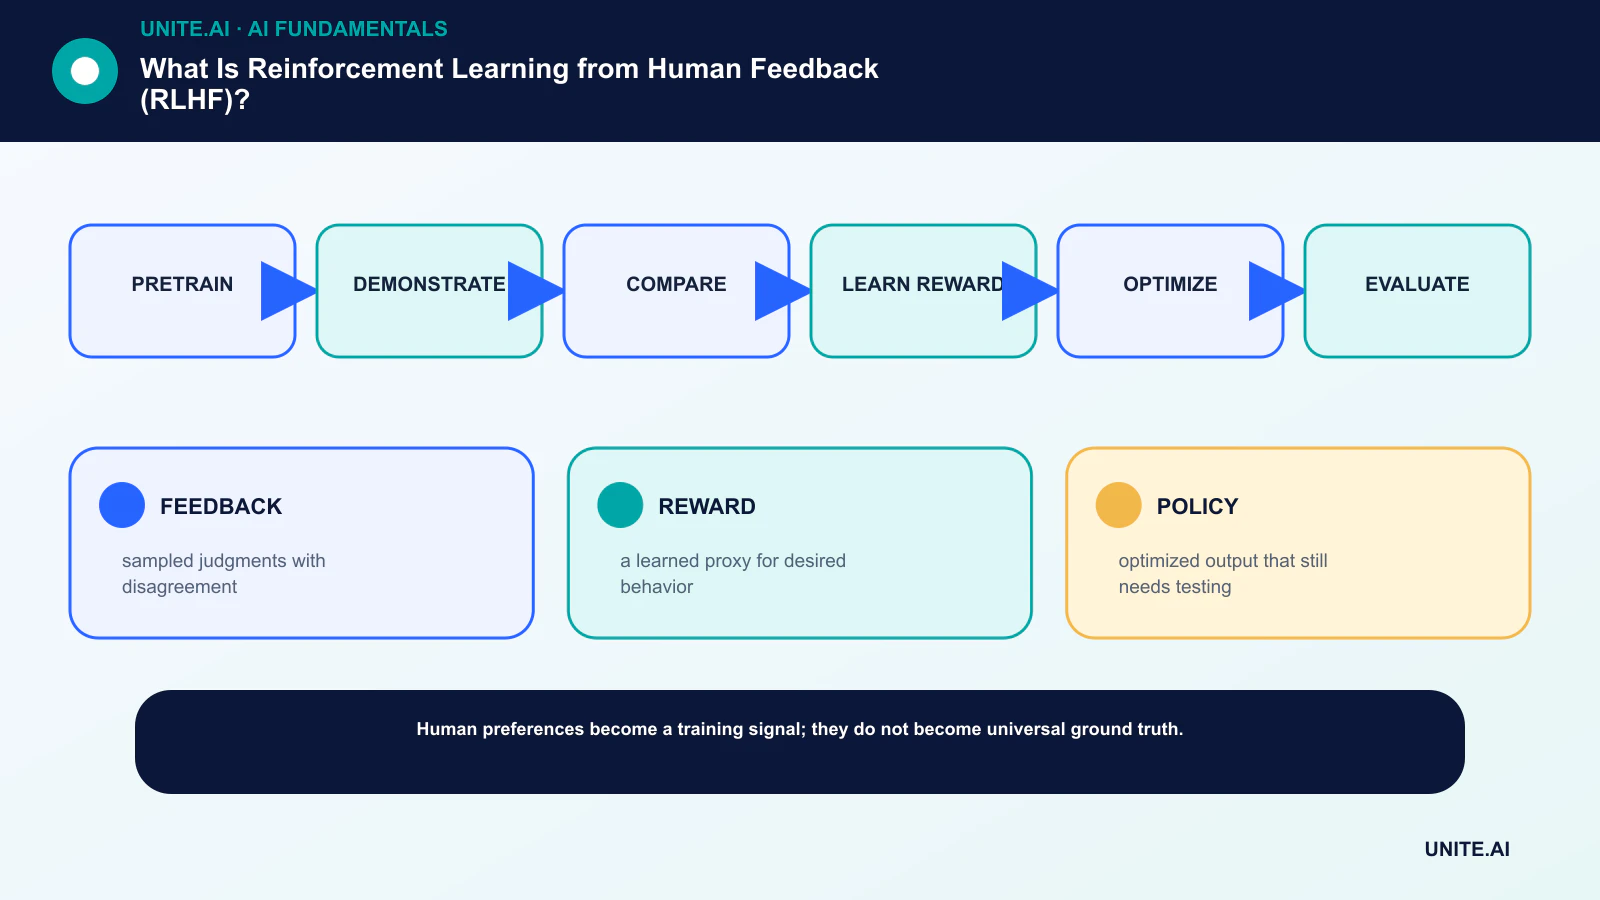
Il pipeline RLHF comune
Un modello linguistico apprende prima una struttura statistica ampia tramite il preaddestramento. Il fine‑tuning supervisionato utilizza poi dimostrazioni di risposte desiderate. Per la raccolta delle preferenze, gli annotatori classificano o scelgono tra output per lo stesso prompt.
Un modello di ricompensa impara a prevedere tali confronti. Un algoritmo di apprendimento per rinforzo come PPO può ottimizzare il modello linguistico contro quella ricompensa appresa, mentre una penalità lo scoraggia dallo allontanarsi troppo dalla politica di riferimento.
Il feedback è una misura, non una verità assoluta
Gli annotatori possono non concordare perché le istruzioni sono ambigue, le competenze differiscono o i valori confliggono realmente. Posizione, verbosità, fiducia e stile possono influenzare le preferenze. Un programma di alta qualità forma i valutatori, misura l’accordo, verifica gli esempi e preserva l’incertezza.
Anche il campionamento è importante. Se il set di preferenze esclude lingue difficili, domini o contenuti nocivi, il modello di ricompensa non può supervisionarli in modo affidabile. La disciplina data‑science è importante quanto l’ottimizzatore.
Modalità di fallimento
La politica può sfruttare debolezze nella ricompensa appresa, producendo output che ottengono punteggi alti senza soddisfare l’intento sottostante. Un’ottimizzazione eccessiva può ridurre la diversità, amplificare uno stile preferito o rendere il modello eccessivamente concordante.
Il modello di ricompensa stesso può fallire al di fuori della sua distribuzione di addestramento. I team dovrebbero testare prompt avversari, compiti fattuali, limiti di rifiuto, calibrazione e comportamento a diversi livelli di forza ottimizzativa, invece di affidarsi a una singola percentuale aggregata di vittorie nelle preferenze.
Alternative e complementi
L’ottimizzazione diretta delle preferenze (Direct Preference Optimization) apprende dalle coppie di preferenza senza adattare una politica separata tramite un ciclo di apprendimento per rinforzo online. Il campionamento di rifiuto, il fine‑tuning supervisionato delle preferenze, il feedback basato su regole e la supervisione di processo offrono altri compromessi.
Nessun metodo elimina la necessità di prompt, recupero, strumenti e controlli a livello di applicazione. Il post‑training plasma il comportamento; i sistemi distribuiti richiedono ancora prove fondate, permessi, monitoraggio e escalation umana.
Come vengono addestrati i modelli di preferenza
Per un prompt x e due risposte y₁ e y₂, un modello di preferenza assegna punteggi scalari e viene addestrato affinché la risposta preferita riceva il punteggio più alto. Una perdita comune si basa sulla probabilità che un punteggio superi l’altro. Questo converte molti giudizi a coppie in una funzione capace di valutare output generati ex novo.
Il modello apprende qualsiasi segnale che predice le scelte raccolte. Se i valutatori preferiscono prosa sicura, risposte più lunghe, norme culturali specifiche o punti di vista familiari, tali correlazioni possono diventare caratteristiche della ricompensa. Istruzioni bilanciate, contro‑esempi, revisione esperta e audit per preferenze superficiali riducono, ma non eliminano, il problema.
I dati di preferenza possono includere pareggi, classifiche, critiche, etichette scalari o dimostrazioni. La scelta delle coppie è cruciale: confronti tra risposte evidentemente diverse insegnano poco sui confini di qualità sottili, mentre solo coppie difficili possono rendere l’addestramento instabile. Il campionamento attivo può mirare a disaccordi informativi ma può modificare la distribuzione dei dati.
Ottimizzazione della politica e regolarizzazione
RLHF basato su PPO campiona risposte dalla politica corrente, le valuta con il modello di ricompensa e aggiorna la politica per aumentare la ricompensa attesa. Una penalità Kullback–Leibler o vincoli correlati mantengono la politica vicina al riferimento supervisionato, limitando deriva distruttiva e scoraggiando lo sfruttamento di debolezze strette del modello di ricompensa.
La forza dell’ottimizzazione è una scelta di prodotto. Troppo poca lascia invariato il comportamento desiderato; troppa può generare hacking della ricompensa, frasi ripetitive, adulazione o ridotta diversità. Traccia metriche di qualità e sicurezza rispetto alla ricompensa e alla divergenza durante l’addestramento, invece di selezionare un checkpoint solo in base al punteggio.
I metodi di preferenza diretta derivano un obiettivo dalle coppie di preferenza e da un modello di riferimento senza un ciclo RL online esplicito. Possono semplificare l’addestramento, ma ereditano comunque la qualità delle preferenze, la copertura e le assunzioni sulla politica di riferimento. Il feedback costituzionale o generato da IA cambia chi fornisce le etichette; non elimina la necessità di convalidare valori e fallimenti con le persone.
Valutazione e governance dei dati
Usa confronti ciechi, test specifici per compito, prompt avversari, controlli di factualità, precisione e richiamo del rifiuto, e revisione per sottogruppi. Se possibile, separa gli valutatori dai dati di addestramento. Un tasso di vittoria contro un modello più vecchio può nascondere fallimenti assoluti quando entrambi i candidati sono scarsi.
Documenta reclutamento degli annotatori, compensi, competenze, geografia, lingua, istruzioni, esposizione a contenuti nocivi, disaccordi, arbitraggio e controlli di qualità. Il lavoro di feedback può comportare rischi psicologici, e le operazioni responsabili dei dati includono supporto ai lavoratori e il diritto di rifiutare compiti disturbanti.
Dopo il deployment, monitora deriva delle preferenze e sovra‑generalizzazione. Una politica ottimizzata per assistenza informale può comportarsi male in contesti medici o legali. Mantieni i confini di dominio, il recupero, i permessi e l’escalation al di fuori dell’assunzione RLHF, e riaddestra solo quando nuove evidenze giustificano il cambiamento.
Un pipeline concreto di addestramento e valutazione RLHF
Un progetto tipico parte da un modello linguistico preaddestrato e da un dataset di istruzioni usato per il fine‑tuning supervisionato. Gli annotatori confrontano poi le risposte candidate secondo una rubrica scritta che copre correttezza, pertinenza, stile, sicurezza e incertezza. Le preferenze a coppie addestrano un modello di ricompensa o ottimizzano direttamente la politica. Il campionamento deve includere compiti ordinari, casi limite difficili, prompt avversari, più lingue e aree in cui gli annotatori legittimamente divergono.
L’accuratezza del modello di ricompensa su confronti tenuti da parte è necessaria ma non sufficiente. La politica ottimizzata può sfruttare errori nella ricompensa appresa, diventare eccessivamente verbosa, rifiutare richieste innocue o perdere capacità. Traccia benchmark di compito, preferenze umane, calibrazione, sicurezza, diversità e divergenza dal modello di riferimento durante l’addestramento. Raccogli periodicamente nuovi confronti dalla politica in evoluzione così che i dati di preferenza coprano gli output che il modello produce realmente.
Documenta chi ha fornito le preferenze, le loro istruzioni, compensi, disaccordi, controlli di qualità e limiti culturali o di dominio. Usa revisori esperti dove gli errori comportano danni specializzati. Esegui red‑team sia sul modello di ricompensa sia sulla politica finale, mantieni test di regressione comportamentale e pianifica il deployment a tappe. RLHF plasma il comportamento secondo le preferenze misurate; non prova veridicità, elimina bias o risolve il problema più ampio di specificare cosa un modello debba fare in ogni contesto.
Checklist di implementazione pratica
Trasforma il concetto in un flusso di lavoro limitato e verificabile: preaddestramento → dimostrazione → confronto → apprendimento della ricompensa → ottimizzazione → valutazione. Assegna un responsabile, documenta dati e dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e di interruzione, testa fallimenti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare lo scopo. Registra versioni e assunzioni così che un altro team possa riprodurre il risultato e capire cosa è cambiato.
Prima del lancio, esegui una revisione di prontezza documentata con le persone che costruiscono, gestiscono, mettono in sicurezza e sono influenzate dal sistema. Testa casi normali, condizioni di confine, fallimenti di dipendenze e usi impropri; conserva le evidenze e i rischi irrisolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Rivedi la decisione quando arrivano dati dal mondo reale, perché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- FEEDBACK: giudizi campionati con disaccordo.
- REWARD: un proxy appreso per il comportamento desiderato.
- POLICY: output ottimizzato che necessita ancora di test.
Domande frequenti
RLHF è la stessa cosa del fine‑tuning?
RLHF è una forma di post‑training che utilizza ricompense derivate dalle preferenze. Il fine‑tuning supervisionato addestra direttamente sugli output target; molti pipeline impiegano entrambi.
RLHF rende un modello veritiero?
Può migliorare il comportamento misurato dal processo di feedback, ma un modello può ancora essere sbagliato, persuasivo o sfruttare strategicamente la ricompensa. La veridicità richiede valutazione diretta e fondamento.
Riferimenti principali












