
Fondamenti di IA
Cos’è l’apprendimento federato?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Federated learning addestra un modello condiviso su più dispositivi o organizzazioni mantenendo i dati di addestramento grezzi di ciascun partecipante in locale. Un coordinatore distribuisce i parametri del modello, i client calcolano gli aggiornamenti sui propri record e una fase di aggregazione combina tali aggiornamenti.
Mantenere i record in locale è utile, ma non è sinonimo di privacy o sicurezza. Gli aggiornamenti del modello possono trapelare informazioni, i client compromessi possono avvelenare l’addestramento e il coordinatore necessita comunque di autenticazione, sicurezza del trasporto, controlli di accesso e di un modello di fiducia definito.
Key takeaways
- L’apprendimento federato sposta il calcolo verso i dati distribuiti; non sposta il dataset grezzo verso un unico addestratore centrale.
- I sistemi cross-device coinvolgono molti dispositivi intermittenti, mentre i sistemi cross-silo coinvolgono meno organizzazioni, più stabili.
- L’aggregazione sicura e la privacy differenziale affrontano rischi diversi e possono essere combinate.
- Dati non IID, larghezza di banda limitata, partecipazione inaffidabile e aggiornamenti malevoli sono vincoli di progettazione fondamentali.
The federated averaging lifecycle
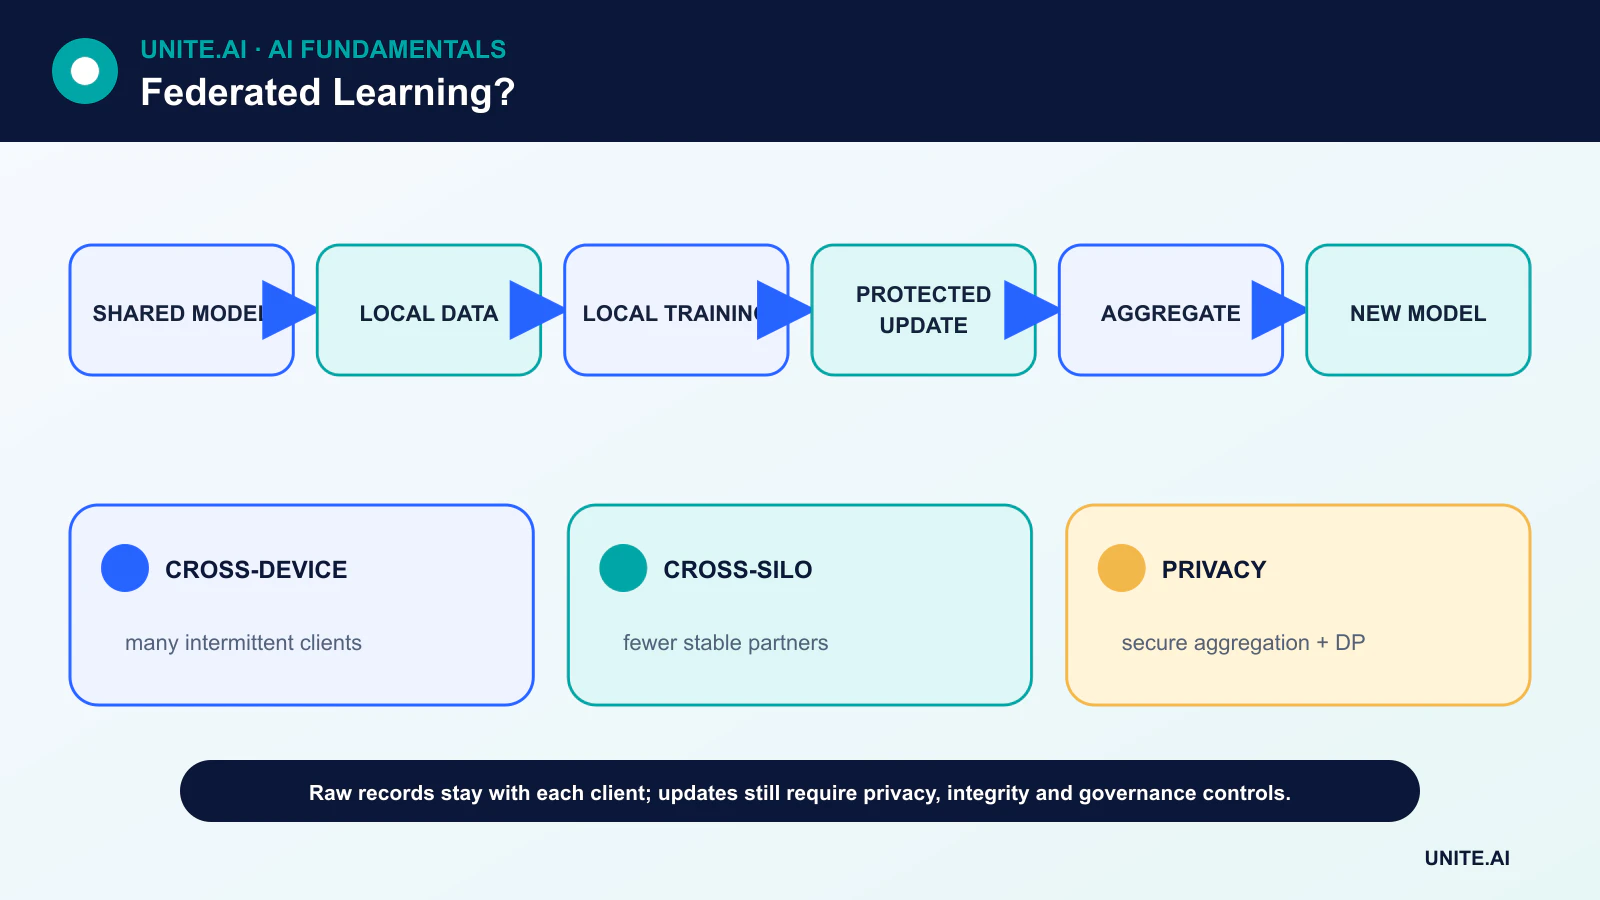
Un round tipico inizia quando un coordinatore seleziona i client idonei e invia il modello corrente. Ogni client addestra localmente per un numero limitato di passi, producendo un aggiornamento di parametri o di gradienti. Il coordinatore aggrega gli aggiornamenti idonei — spesso con pesi basati sul conteggio locale degli esempi — e pubblica il nuovo modello condiviso.
Solo una frazione dei client può partecipare a ciascun round. Il protocollo deve tollerare connessioni interrotte, incompatibilità di versione e dispositivi che non possono addestrare mentre sono in carica, occupati o offline. La comunicazione può dominare il calcolo, quindi la compressione degli aggiornamenti e un minor numero di scambi spesso contano più della velocità grezza dell’acceleratore.
Cross-device versus cross-silo
L’apprendimento federato cross-device può coinvolgere telefoni, sensori o browser di molti individui. I client sono numerosi, debolmente fidati e disponibili in modo intermittente. L’apprendimento federato cross-silo solitamente collega un insieme più ristretto di ospedali, banche o unità di business con infrastrutture stabili e governance contrattuale.
I due contesti richiedono assunzioni diverse su identità, audit e guasti. Un progetto cross-silo può negoziare uno schema condiviso e un processo di validazione; un servizio cross-device potrebbe dover gestire milioni di versioni software e set di dati locali altamente disomogenei.
Secure aggregation, differential privacy and encryption
L’aggregazione sicura è un protocollo crittografico che consente al server di ricavare un aggregato senza leggere l’aggiornamento di ciascun client. La privacy differenziale limita quanto il risultato rilasciato possa dipendere da un singolo record o partecipante, mediante il clipping dei contributi e l’aggiunta di rumore calibrato.
Nessuno dei due meccanismi risolve tutti i rischi. L’aggregazione sicura non rende l’aggregato innocuo, e la privacy differenziale impone un trade‑off precisione‑privacy che deve essere gestito con un budget di privacy esplicito. La crittografia protegge i dati in transito o a riposo; da sola non impedisce inferenze dal modello.
Non-IID data and model quality
I dati dei client raramente sono indipendenti e identicamente distribuiti. Un modello per tastiere osserva il vocabolario di ciascuna persona; gli ospedali servono popolazioni diverse; le fabbriche usano attrezzature differenti. Queste differenze possono rallentare la convergenza e nascondere scarse prestazioni per piccoli gruppi di client.
La valutazione dovrebbe includere metriche globali, distribuzioni per client o coorte, calibrazione e analisi dei guasti. Un set di test centrale può essere comodo ma insufficiente. Questo collega l’apprendimento federato alla machine-learning e alla governance dei dati strutturati e non strutturati.
Threats and operational controls
I client malevoli possono inviare aggiornamenti avvelenati, i client sybil possono distorcere l’aggregazione e un server compromesso può distribuire un modello mirato. Le difese includono iscrizione autenticata, rilevamento di anomalie, aggregazione robusta, validazione degli aggiornamenti, limiti di frequenza e attestazione software riproducibile dove praticabile.
L’apprendimento federato rientra in un più ampio programma di cybersecurity. I team dovrebbero documentare chi controlla il coordinatore, quali metadati vengono raccolti, come i partecipanti possono uscire, come i modelli vengono ripristinati e cosa accade quando i test di privacy o qualità falliscono.
Federated optimization and data heterogeneity
L’apprendimento federato invia un modello o un compito di aggiornamento ai client partecipanti, addestra localmente e aggrega gli aggiornamenti senza centralizzare gli esempi grezzi. Nell’averaging federato, i client selezionati eseguono diversi passi di ottimizzazione locale e il server calcola una media ponderata, solitamente per conteggio degli esempi. I round di comunicazione, le epoche locali, la selezione e i tassi di apprendimento bilanciano larghezza di banda e convergenza. I contesti cross-device coinvolgono molti telefoni o sensori inaffidabili; i contesti cross-silo coinvolgono meno organizzazioni con capacità di calcolo, identità e governance più solide.
I dati dei client sono solitamente non indipendenti e disomogenei: gli utenti differiscono per comportamento, distribuzione delle etichette, volume e disponibilità. L’addestramento locale può deviare in direzioni incompatibili, rendendo una semplice media instabile o sbilanciata verso client attivi ad alto volume. Gli algoritmi possono usare termini prossimali, ottimizzazione server adattiva, clustering, personalizzazione o variabili di controllo. La valutazione dovrebbe riportare prestazioni globali e per client, client di coda, frequenza di partecipazione, convergenza, comunicazione ed energia. Una buona media può nascondere che piccole o rare popolazioni di client ricevano un modello peggiore.
Privacy, security, and systems engineering
Mantenere i dati in locale non garantisce di per sé la privacy. Gradienti e aggiornamenti possono rivelare appartenenza o caratteristiche, mentre il modello finale può memorizzare esempi. L’aggregazione sicura nasconde gli aggiornamenti individuali al server, e la privacy differenziale limita il contributo informativo mediante clipping e rumore, ma entrambi alterano l’utilità e la complessità operativa. Definire il modello di minaccia, l’unità di privacy, il budget e i componenti fidati. La crittografia in transito è necessaria ma non impedisce un client malevolo, un aggiornamento avvelenato, un coordinatore compromesso o un attacco di inferenza.
Le difese includono client autenticati, aggregazione robusta, controlli di anomalie, limiti di aggiornamento, enclave sicure in alcuni design e validazione contro dati puliti. Gli attaccanti sybil possono creare molti client; le backdoor possono sopravvivere all’averaging; scartare aggiornamenti sospetti può anche escludere comportamenti rari legittimi. Versionare il codice client, supportare round interrotti, prevenire replay e progettare per ritardatari e vincoli dei dispositivi. Consenso, conservazione, normative regionali e cancellazione si applicano comunque ai dati locali e agli aggiornamenti derivati.
Deployment and governance example
Una tastiera mobile può addestrare miglioramenti di predizione della parola successiva localmente, ma il rollout dovrebbe utilizzare una popolazione ammissibile in base alle capacità del dispositivo e al consenso, raccogliere aggiornamenti protetti con clipping e confrontarli con una baseline congelata. Validare le prestazioni linguistiche e dialettali, la batteria, l’uso dei dati e il rischio di memorizzazione prima del rilascio. I client necessitano di compiti di addestramento firmati e aggiornamenti di modello; il server necessita di configurazioni di round auditabili e di rollback. L’apprendimento federato è un’architettura per l’apprendimento distribuito sotto vincoli, non un sostituto di dati rappresentativi, ingegneria della privacy o responsabilità.
Worked example: federated learning across hospitals
Gli ospedali addestrano un modello condiviso di qualità delle immagini senza aggregare le scansioni. Un protocollo comune definisce i metadati dei dispositivi, le etichette, il preprocessing, l’idoneità dei client, le epoche locali, il clipping e l’aggregazione sicura. I siti conservano i dati dei pazienti e inviano aggiornamenti protetti, mentre un coordinatore valuta ogni round su set di validazione locali. I risultati riportano prestazioni a livello di sito e di coda, non solo una media ponderata per volume, perché altrimenti gli ospedali piccoli e i tipi di dispositivo potrebbero essere ignorati.
Il modello di minaccia copre aggiornamenti malevoli, perdite di appartenenza, client compromessi e accesso del coordinatore. La privacy differenziale è configurata con un budget documentato e testata per utilità. I pacchetti di modello e compito sono firmati; i siti possono ritirarsi e gli aggiornamenti sono auditabili. Un round avvelenato o instabile non sostituisce automaticamente il modello distribuito. Il progetto mantiene baseline locali e revisione clinica, e tratta l’architettura federata come un controllo di privacy all’interno di più ampie obbligazioni di consenso, sicurezza e governance.
Implementation evidence and operational readiness
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o gli ambienti più probabilmente trascurati.
Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout a tappe, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allerta e un responsabile di risposta, quindi rivedere le evidenze reali dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogniqualvolta le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Frequently asked questions
Does federated learning guarantee that private data cannot leak?
No. It reduces raw-data movement, but updates and final models can still reveal information. Privacy requires a threat model and additional technical and organizational controls.
When is centralized training simpler?
When data can be lawfully and safely centralized, centralized training is often easier to debug, reproduce and monitor. Federated learning is justified when distribution is a real requirement, not merely a branding goal.
Primary references












