
Fondamenti di IA
Ingegneria dell’Influenza: Personalizzazione, Persuasione ed Etica dell’IA

 Aggiungi Unite.AI alle tue fonti preferite su Google
L’ingegneria dell’influenza è un utile termine ombrello per la progettazione di sistemi digitali che modellano intenzionalmente l’attenzione, le scelte o il comportamento. Raccomandazione, personalizzazione, sperimentazione, design persuasivo dell’interfaccia e segnali legati alle emozioni possono tutti far parte, ma il termine non è una disciplina tecnica consolidata con una definizione standard.
La domanda centrale è se un sistema supporta gli obiettivi personali di una persona o li indirizza attraverso meccanismi nascosti, ingannevoli o sfruttatori. Maggiore capacità predittiva aumenta la necessità di consenso, trasparenza, limiti all’inferenza sensibile, revisione indipendente e benessere misurabile dell’utente.
Punti chiave
- Distinguere la guida benefica dalla manipolazione esaminando l’intento, il metodo, la divulgazione e il controllo dell’utente.
- Un’emozione inferita è un output probabilistico del modello, non un accesso diretto allo stato interno di una persona.
- Ottimizzare per i risultati dell’utente e il benessere a lungo termine, non solo per il coinvolgimento.
- Fornire scelte significative, minimizzazione dei dati, possibilità di contestazione e monitoraggio per impatti disparati.
Come funziona l’influenza digitale
Un sistema osserva il comportamento, costruisce un modello dell’utente o del contesto, seleziona un intervento, misura una risposta e aggiorna la politica. Gli interventi possono includere ranking, tempistiche, impostazioni predefinite, segnali sociali, formulazioni, notifiche, prezzi o risposte conversazionali.
Questo ciclo di feedback assomiglia al reinforcement learning, ma la ricompensa codifica un giudizio di valore. I click e la durata della sessione sono facili da misurare; la scelta informata, la fiducia e il beneficio a lungo termine sono più difficili ma spesso più importanti.
Dove entra l’AI emotiva
Emotion AI può stimare schemi da movimenti facciali, voce, linguaggio, fisiologia o interazione. Questi segnali dipendono dal contesto e variano culturalmente. Un modello può prevedere una categoria etichettata senza stabilire ciò che qualcuno sente realmente.
Utilizzare tali previsioni per modificare un messaggio, un prezzo o un’opportunità può creare un ciclo di feedback sensibile. Le prestazioni dovrebbero essere valutate per sottogruppo e contesto, e il sistema non dovrebbe inferire più di quanto il servizio necessiti realmente.
Persuasione, assistenza e manipolazione
Un prompt di navigazione che aiuta l’utente a seguire un piano scelto differisce da una pubblicità mascherata o da un ostacolo che rende difficile la cancellazione. Valutare se lo scopo è divulgato, se le alternative rimangono disponibili e se una persona ragionevole può comprendere e invertire la scelta.
I dark pattern sfruttano l’asimmetria nelle informazioni o nello sforzo. Le interfacce generative possono scalare tali tattiche personalizzando il linguaggio in modo continuo, quindi le salvaguardie devono coprire l’obiettivo e il sistema di sperimentazione, non solo lo schermo visibile.
Governance e valutazione
Documentare il beneficio previsto, i gruppi interessati, le tattiche proibite, le fonti dei dati, la conservazione, l’obiettivo di ottimizzazione e il responsabile della revisione. I test pre‑distribuzione dovrebbero includere utenti vulnerabili, scenari avversari e risultati oltre la conversione immediata.
Monitorare reclami, inversioni, rimpianti, frequenza di esposizione, risultati per sottogruppo e comportamenti inattesi. Applicare controlli di AI responsabile e revisione legale laddove possano applicarsi norme biometriche, di protezione dei consumatori, occupazionali, educative o sanitarie.
Il sistema di ottimizzazione alla base dell’influenza
I sistemi di influenza sono spesso pipeline piuttosto che un unico modello. Un generatore di candidati seleziona messaggi o elementi possibili, un modello di ranking li valuta, un framework di sperimentazione assegna i trattamenti e un servizio di feedback registra il comportamento. La risoluzione dell’identità e i profili utente collegano le osservazioni tra le sessioni, rendendo privacy e limitazione dello scopo scelte architetturali centrali.
L’obiettivo di ottimizzazione può essere immediato, come un click, o ritardato, come un corso completato o un comportamento sanitario sostenuto. Le metriche proxy invitano al gioco: una politica di notifiche può aumentare le aperture creando ansia, e un sistema di raccomandazione può incrementare il tempo di visualizzazione riducendo la soddisfazione. I team dovrebbero definire metriche di salvaguardia e risultati a lungo termine prima di ottimizzare.
I metodi bandit e di reinforcement learning aggiungono esplorazione, ma l’esplorazione espone persone reali a interventi incerti. Limitare il set di azioni, escludere contesti sensibili, porre un tetto alla frequenza e utilizzare politiche conservative. La simulazione offline non può prevedere completamente la risposta sociale, quindi esperimenti a fasi e criteri di interruzione rimangono necessari.
Misurazione, causalità e utenti vulnerabili
I test A/B stimano un effetto causale medio sotto le loro ipotesi di assegnazione e misurazione. Possono non rilevare danni concentrati in piccoli gruppi, interazioni tra esperimenti concorrenti, effetti ritardati e persone che abbandonano il prodotto. Segnalare risultati distribuzionali, non solo l’incremento di conversione principale.
La personalizzazione complica la spiegazione perché utenti diversi vedono interventi diversi. Conservare la versione della politica, l’idoneità, il contesto e il motivo della selezione. Verificare se caratteristiche protette o sensibili sono usate direttamente, inferite indirettamente o correlate a caratteristiche come posizione, dispositivo, lingua o modello di navigazione.
Bambini, persone in difficoltà, utenti con risorse finanziarie limitate e coloro che affrontano decisioni sanitarie o occupazionali possono essere particolarmente vulnerabili a pressioni personalizzate. Evitare urgenza, prova sociale, ricompense variabili o targeting emotivo che sfrutta tali condizioni. La revisione indipendente dovrebbe avere l’autorità di vietare un’ottimizzazione anche quando migliora i ricavi.
Requisiti di progettazione per un’influenza legittima
Un sistema legittimo dichiara il proprio scopo, rende visibile la sponsorizzazione, separa la raccomandazione dal fatto e consente a una persona di modificare o disattivare la personalizzazione. Le impostazioni predefinite dovrebbero riflettere aspettative ragionevoli. Il consenso deve essere sufficientemente specifico da descrivere i dati e il meccanismo di influenza, anziché nasconderli in termini generici.
Fornire controlli di esposizione, periodi di silenzio, reset, ispezione del profilo e una spiegazione dei principali fattori alla base di una raccomandazione. Non utilizzare attriti in modo asimmetrico—un click per iscriversi ma diverse schermate confuse per uscire. Un utente dovrebbe poter invertire una decisione senza punizioni non correlate al servizio.
La governance dovrebbe rivedere gli obiettivi, le fonti delle funzionalità, i progetti di sperimentazione, i temi dei reclami e i risultati a valle. Mantenere un registro dei sistemi di influenza e delle sperimentazioni ad alto rischio. Quando appare un modello dannoso, disattivare la politica, conservare le prove, notificare gli utenti interessati dove opportuno e modificare l’incentivo che lo ha prodotto.
Una valutazione pratica del rischio di influenza
Valutare un sistema di influenza mappando attore, obiettivo, pubblico, dati, modello, messaggio, canale, ciclo di feedback e conseguenza. Distinguere assistenza da persuasione e persuasione da manipolazione. Un promemoria scelto dall’utente differisce da un’ottimizzazione occulta per un coinvolgimento compulsivo. Il rischio aumenta quando il sistema mira a vulnerabilità, nasconde la sponsorizzazione, sfrutta lo stato emotivo, crea falsa urgenza o rende l’accesso a servizi essenziali dipendente da una risposta comportamentale.
Prima della distribuzione, testare se la personalizzazione modifica la comprensione, l’autonomia e i risultati tra i gruppi. Utilizzare esperimenti controllati con revisione informata, ma non ottimizzare solo click o conversioni. Misurare rimpianti, reclami, opt‑out, danni a valle e se gli utenti possono identificare il motivo per cui hanno ricevuto un messaggio. Proibire inferenze sensibili non necessarie, limitare gli obiettivi consentiti e separare le decisioni di idoneità o prezzo dall’ottimizzazione della risposta emotiva.
Le interfacce dovrebbero etichettare gli agenti sintetici e le comunicazioni sponsorizzate, spiegare la personalizzazione materiale e offrire controlli significativi. Conservare un registro verificabile di campagne, regole di targeting, versioni del modello, varianti creative e approvazioni senza trattenere dati emotivi non necessari. Una revisione indipendente è appropriata per usi politici, finanziari, sanitari, occupazionali, educativi e rivolti ai bambini. La domanda centrale non è se l’influenza si verifica, ma se il suo scopo, le prove, i metodi e la relazione di potere rispettano l’autonomia informata dell’uomo.
Checklist di implementazione pratica
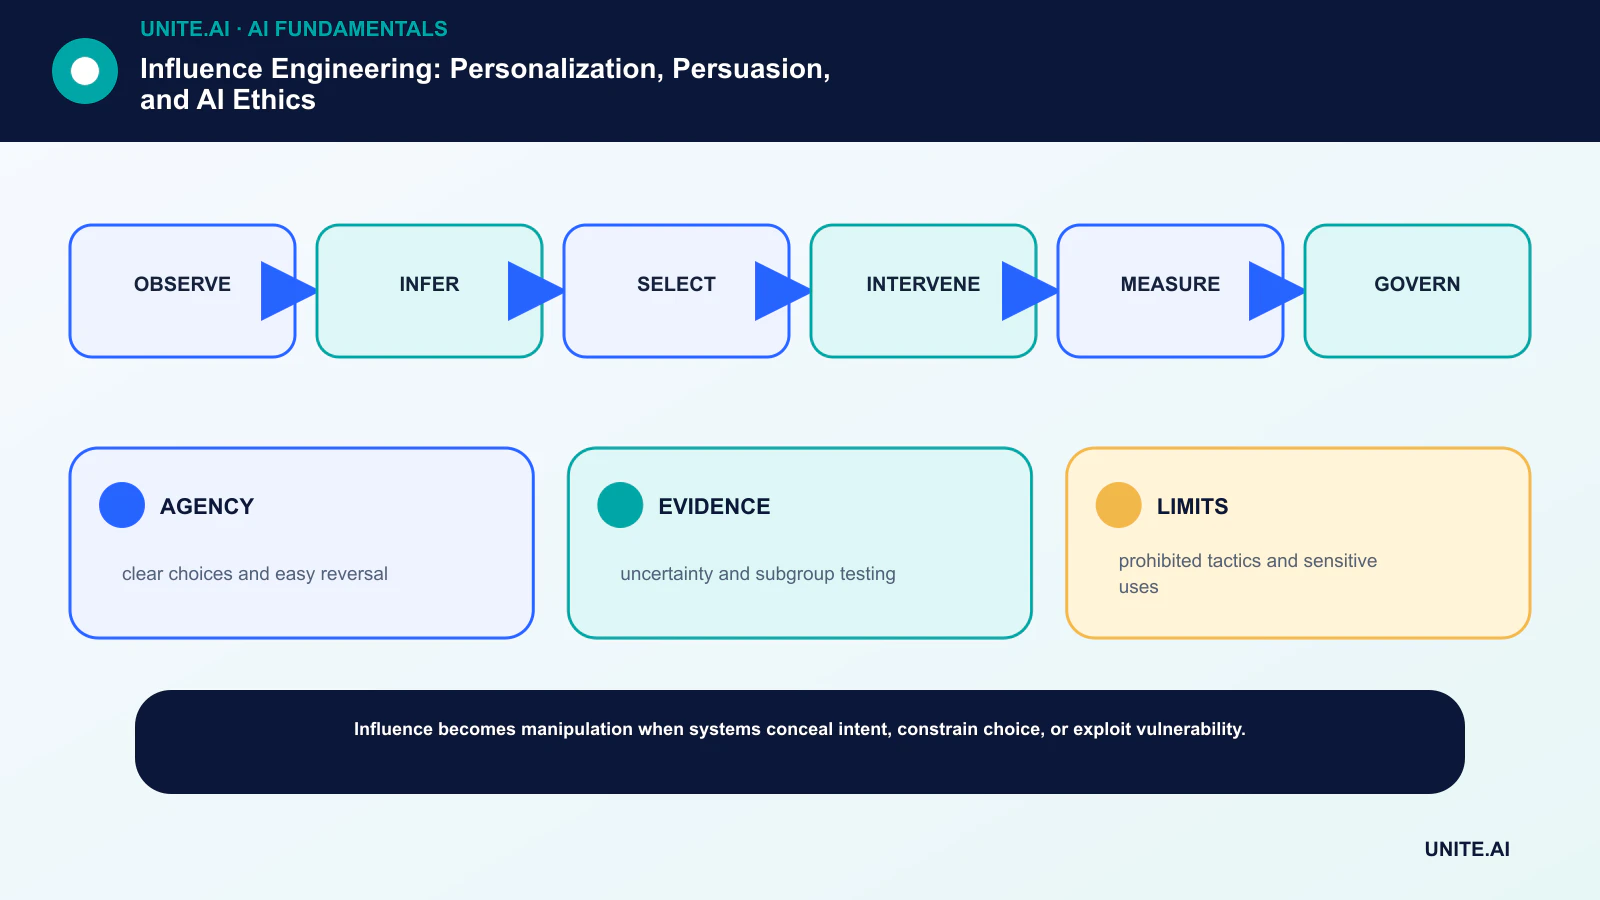
Trasformare il concetto in un flusso di lavoro delimitato e testabile: osservare → inferire → selezionare → intervenire → misurare → governare. Assegnare un responsabile, documentare i dati e le dipendenze, stabilire una baseline semplice, definire criteri di accettazione e interruzione, testare guasti rappresentativi e definire monitoraggio, rollback e revisione prima di ampliare il campo d’azione. Registrare versioni e ipotesi affinché un altro team possa riprodurre il risultato e capire cosa è cambiato.
Prima del lancio, eseguire una revisione di prontezza documentata con le persone che costruiscono, gestiscono, assicurano e sono interessate dal sistema. Testare casi normali, condizioni limite, guasti di dipendenza e usi impropri; conservare le prove e i rischi irrisolti. Definire chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesaminare la decisione dopo l’arrivo dei dati reali, poiché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- AGENZIA: scelte chiare e facile inversione.
- EVIDENZA: incertezza e test su sottogruppi.
- LIMITI: tattiche proibite e usi sensibili.
Domande frequenti
Tutta la personalizzazione è manipolazione?
No. La personalizzazione può ridurre lo sforzo e migliorare la pertinenza. Il rischio aumenta quando gli obiettivi sono nascosti, le scelte sono limitate, le caratteristiche sensibili sono inferite o il sistema sfrutta la vulnerabilità.
Un sistema di IA può sapere come si sente una persona?
Può stimare etichette da segnali osservabili mediante un modello e un dataset. Tale stima è incerta, dipendente dal contesto, e non dovrebbe essere presentata come conoscenza diretta di uno stato interno.
Riferimenti primari












