
Dasar-dasar AI
Apa Itu NPU? Unit Pemrosesan Neural Dijelaskan

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Unit pemrosesan neural (NPU) adalah akselerator khusus yang dirancang untuk mengeksekusi operasi jaringan saraf umum secara efisien. Pada ponsel, PC, kendaraan, kamera, dan sistem tertanam, NPU dapat menjalankan beban kerja AI yang didukung dengan konsumsi energi lebih rendah atau membebaskan CPU dan GPU untuk tugas lain.
NPU adalah istilah industri yang luas, bukan satu arsitektur universal. Kinerja bergantung pada operator yang didukung, format numerik, memori, kompiler dan runtime, batas termal, serta seberapa banyak aplikasi yang dapat tetap berada di akselerator.
Poin-poin utama
- NPU menekankan operasi matriks, vektor, dan tensor dengan penggunaan data yang tinggi dan daya rendah.
- TOPS puncak bukanlah tolok ukur aplikasi end-to-end dan mungkin mengasumsikan presisi atau kelangkaan tertentu.
- Model mungkin memerlukan konversi, kuantisasi, pemisahan graf, dan fallback untuk operasi yang tidak didukung.
- Bandingkan latensi, throughput, energi, memori, kualitas, privasi, dan portabilitas pada beban kerja nyata.
Peran CPU, GPU, dan NPU
CPU unggul dalam alur kontrol umum dan kompatibilitas luas. GPU menyediakan throughput paralel yang dapat diprogram serta ekosistem perangkat lunak yang besar. NPU mengkhususkan operasi tensor berulang dan dapat mencakup memori lokal, array perkalian-akumulasi, serta aliran data yang dioptimalkan untuk inferensi.
Sistem heterogen menjadwalkan bagian-bagian berbeda di tempat yang paling cocok. Hal ini penting untuk edge AI, di mana daya berkelanjutan dan responsivitas dapat lebih penting daripada throughput puncak pusat data.
Kompilasi dan Eksekusi Model
Graf kerangka kerja diubah menjadi representasi menengah, dioptimalkan, dikuantisasi bila sesuai, dan dikompilasi untuk operator yang didukung. Runtime dapat mempartisi graf sehingga lapisan yang tidak didukung dijalankan pada CPU atau GPU.
Transfer antar prosesor dapat menghilangkan keuntungan akselerator. Bentuk statis, tata letak, presisi, batching, dan penggunaan ulang memori memengaruhi kinerja. Uji artefak yang telah dikompilasi karena kualitas model deep-learning dapat berubah setelah konversi.
Memahami Klaim TOPS dan Efisiensi
TOPS melaporkan triliunan operasi per detik berdasarkan asumsi yang ditetapkan. Vendor dapat menghitung perkalian dan penjumlahan secara terpisah, menggunakan presisi integer berbit rendah, atau mengasumsikan kelangkaan. Angka yang lebih tinggi tidak menjamin latensi lebih rendah untuk model tertentu.
Ukur cold start dan warm start, latensi per kueri, throughput, energi, memori puncak, throttling termal, konteks atau ukuran gambar yang didukung, serta proporsi graf yang dipercepat. Gunakan akurasi dan versi perangkat lunak yang setara.
Pertukaran AI pada Perangkat
Eksekusi lokal dapat mengurangi ketergantungan jaringan dan menjaga masukan mentah tetap di perangkat, namun model yang diunduh, log, cadangan, dan fallback ke cloud tetap menghasilkan aliran data. Pengiriman model yang aman dan pembaruan platform tetap diperlukan.
NPU dapat mendukung aplikasi visi, audio, bahasa, dan sensor, termasuk beban kerja yang berdekatan dengan TinyML. Pengembang harus merancang fallback yang mulus dan mengkomunikasikan ketika pemrosesan keluar dari perangkat.
Arsitektur NPU dan Operasi yang Didukung
NPU mempercepat operasi tensor dengan menggunakan array unit perkalian-akumulasi, memori lokal, penjadwalan aliran data, dan format numerik khusus. Menjaga bobot dan aktivasi dekat dengan komputasi mengurangi pergerakan data yang mahal. Perangkat nyata berbeda dalam dukungan operator, hierarki memori, presisi, kelangkaan, kemampuan pemrograman, serta cara kerja dibagi dengan CPU dan GPU.
Kinerja puncak sering dipromosikan dalam TOPS, namun TOPS tidak menentukan presisi, pemanfaatan, batas memori, cakupan operator, atau latensi end-to-end. Dua prosesor dengan angka utama yang sama dapat berperforma berbeda pada model yang sama. Lakukan benchmark pada model yang telah dikompilasi, ukuran batch dan urutan yang realistis, pra‑pemrosesan, transfer, dan mode daya.
NPU efektif untuk beban kerja neural yang didukung seperti visi, ucapan, denoising, efek latar belakang, dan model bahasa kompak. Operator yang tidak didukung dapat fallback ke CPU atau GPU, menghasilkan transfer dan latensi yang tidak dapat diprediksi. Periksa laporan kompiler dan jejak runtime untuk memastikan penempatan, bukan mengasumsikan seluruh graf menggunakan akselerator.
Konversi Model, Kuantisasi, dan Penyebaran
Penyebaran biasanya bergerak dari kerangka kerja pelatihan melalui ekspor, optimasi graf, kuantisasi, kompilasi vendor, dan integrasi runtime. Bentuk statis dan operator umum paling mudah dipercepat. Alur kontrol dinamis, kernel khusus, tensor menengah besar, serta pola normalisasi atau perhatian yang tidak didukung dapat memerlukan perubahan graf atau eksekusi hibrida.
Format integer dan presisi lebih rendah mengurangi ukuran model, lebar pita, energi, dan latensi, namun data kalibrasi harus mewakili masukan nyata. Bandingkan kuantisasi pasca‑pelatihan dengan pelatihan sadar kuantisasi ketika kualitas sensitif. Evaluasi perilaku per‑kelas dan kasus terburuk karena akurasi rata‑rata dapat menyembunyikan degradasi pada kasus langka atau yang relevan dengan keselamatan.
Inferensi pada perangkat meningkatkan latensi, operasi offline, dan privasi dengan membatasi transfer data, namun perangkat tetap memerlukan model yang aman, akses data yang memperhatikan izin, dan mekanisme pembaruan. Lindungi file model bila perlu, tandatangani pembaruan, ungkapkan fallback ke cloud, dan pastikan telemetri tidak memperkenalkan kembali paparan privasi yang ingin dikurangi oleh arsitektur lokal.
Evaluasi Kinerja dan Pertukaran Tingkat Sistem
Ukur latensi cold‑start dan steady‑state, throughput, energi per inferensi, memori, perilaku termal, akurasi, dan dampak pada baterai. Tes panjang mengungkap throttling yang terlewat pada benchmark singkat. Sertakan pra‑pemrosesan dan pasca‑pemrosesan karena perubahan ukuran, tokenisasi, decoding, atau penyalinan data dapat mendominasi akselerator yang sebaliknya cepat.
Penjadwalan adalah masalah sistem. CPU mengelola logika aplikasi, GPU dapat merender atau mengeksekusi lapisan yang tidak didukung, dan NPU menjalankan graf yang kompatibel. Beban kerja kamera, audio, tampilan, dan AI yang bersamaan bersaing untuk lebar pita memori dan daya. Uji skenario pengguna lengkap, bukan model terisolasi dalam alat vendor.
Portabilitas tetap terbatas antar kompiler dan runtime. Pilih representasi model standar bila memungkinkan, isolasi kode khusus vendor di balik antarmuka, pertahankan output referensi, dan jaga cakupan pengujian perangkat. Pilih perangkat keras berdasarkan beban kerja yang tervalidasi, dukungan perangkat lunak, horizon pembaruan, dan total biaya sistem—bukan hanya spesifikasi satu akselerator.
Contoh Praktis: Menyebarkan Model Visi ke Laptop dengan NPU
Sebuah tim melatih model segmentasi untuk efek latar belakang, mengekspornya ke format pertukaran yang didukung, mengganti operator yang tidak didukung, dan mengkalibrasi kuantisasi integer dengan kamera, pencahayaan, warna kulit, pakaian, dan latar belakang yang representatif. Kompiler vendor melaporkan node mana yang berjalan di NPU dan mana yang fallback. Tim memperlakukan setiap fallback sebagai biaya sistem, karena transfer tensor dapat mendominasi kernel individual yang cepat.
Benchmark mengukur pra‑pemrosesan kamera, eksekusi model, komposit, memori, cold start, latensi steady‑state, stabilitas frame, daya, dan throttling termal selama panggilan video nyata. Hasil dibandingkan dengan jalur CPU dan GPU dengan kualitas output yang setara. Aplikasi menggunakan deteksi kemampuan dan fallback yang telah diuji, bukan mengasumsikan akselerator ada atau mendukung graf yang sama setelah pembaruan driver.
Pengujian rilis mencakup model perangkat, versi sistem operasi dan driver, beban kerja bersamaan, mode baterai, dan input yang rusak. Paket model ditandatangani dan diberi versi; telemetri mencatat kinerja dan kegagalan tanpa mengumpulkan video yang tidak diperlukan. Produk menjelaskan kapan pemrosesan tetap di perangkat dan kapan fitur cloud digunakan. NPU memperoleh tempatnya dengan meningkatkan pengalaman lengkap di bawah kendala realistis, bukan hanya dengan mencapai TOPS atau benchmark kernel terisolasi.
Daftar Periksa Implementasi Praktis
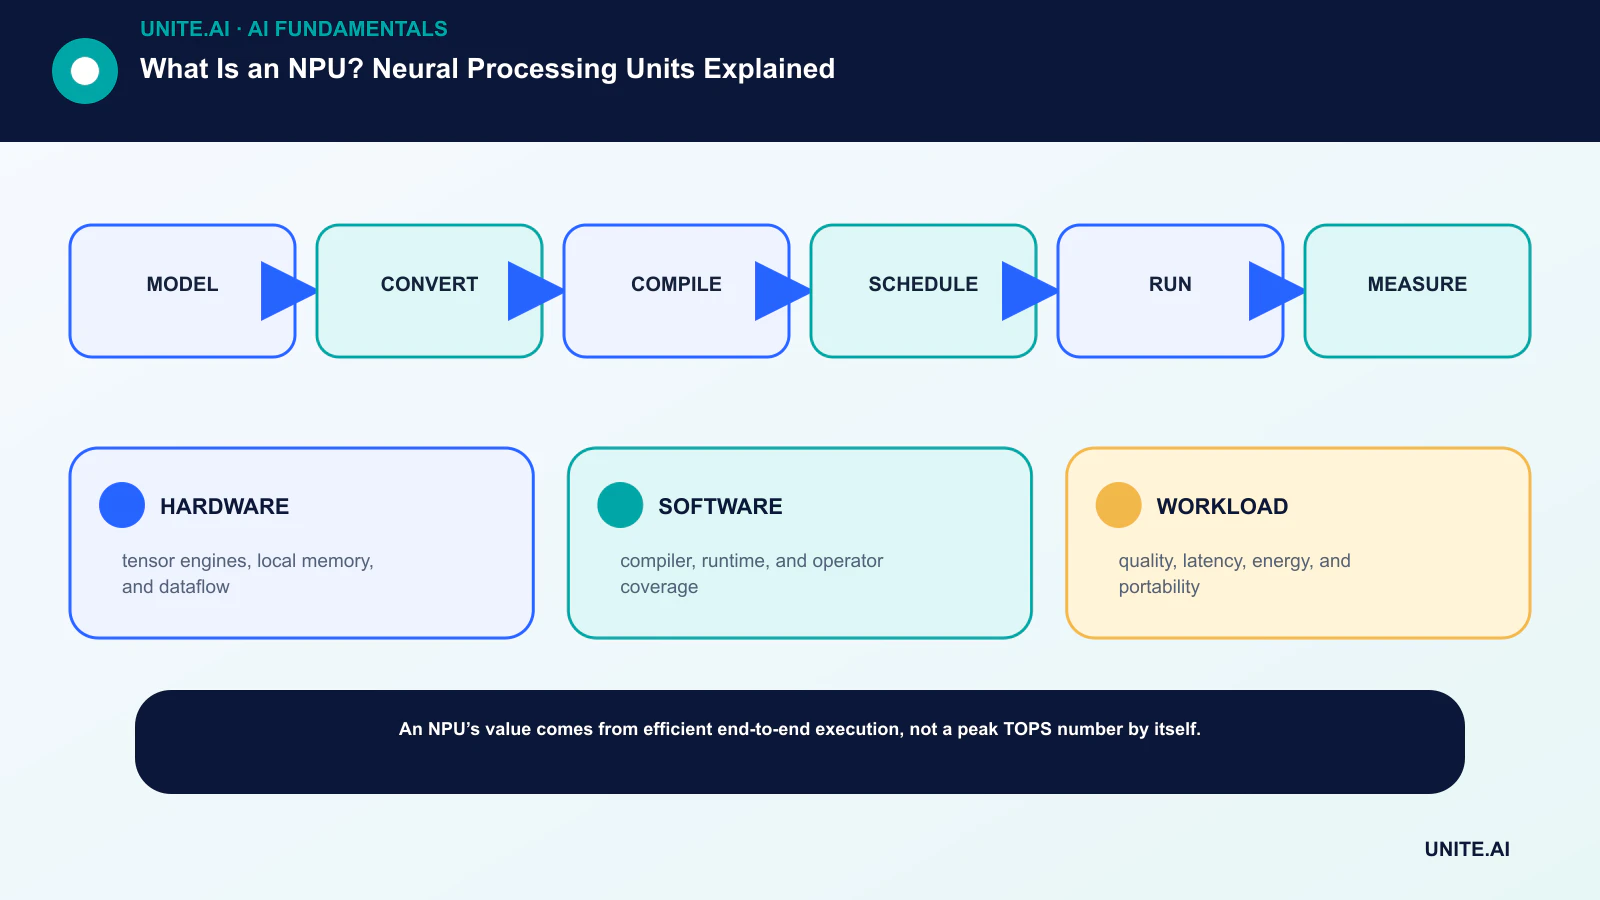
Ubah konsep menjadi alur kerja yang terbatas dan dapat diuji: model → konversi → kompilasi → penjadwalan → jalankan → ukur. Tetapkan pemilik yang bertanggung jawab, dokumentasikan data dan ketergantungan, buat baseline sederhana, tetapkan kriteria penerimaan dan penghentian, uji kegagalan representatif, serta definisikan pemantauan, rollback, dan tinjauan sebelum memperluas lingkup. Catat versi dan asumsi agar tim lain dapat mereproduksi hasil dan memahami apa yang berubah.
Sebelum peluncuran, lakukan tinjauan kesiapan yang terdokumentasi bersama orang‑orang yang membangun, mengoperasikan, mengamankan, dan terpengaruh oleh sistem. Uji kasus normal, kondisi batas, kegagalan ketergantungan, dan penyalahgunaan; simpan bukti dan risiko yang belum terselesaikan. Tentukan siapa yang dapat menyetujui rilis, mengubah ambang batas, mengganti output, atau menghentikan operasi. Tinjau kembali keputusan setelah data dunia nyata muncul, karena pilot yang berhasil secara teknis tidak menjamin kinerja andal pada skala yang lebih luas.
- HARDWARE: mesin tensor, memori lokal, dan aliran data.
- SOFTWARE: kompiler, runtime, dan cakupan operator.
- WORKLOAD: kualitas, latensi, energi, dan portabilitas.
Pertanyaan yang Sering Diajukan
Apakah NPU lebih cepat daripada GPU?
Tergantung pada model, presisi, dukungan operator, ukuran batch, batas daya, dan perangkat lunak. NPU mungkin lebih efisien untuk beban kerja pada perangkat yang didukung, sementara GPU lebih cepat atau lebih fleksibel di tempat lain.
Apakah NPU menjaga semua data AI tetap pribadi?
Tidak. NPU memungkinkan pemrosesan lokal, namun aplikasi masih dapat mengirim data atau output ke layanan cloud. Privasi tergantung pada arsitektur lengkap dan kebijakan.
Referensi Utama












