
Dasar-dasar AI
Apa Itu Interpretabilitas Mekanik? Bagaimana Peneliti Menganalisis Model AI

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
Interpretabilitas mekanistik mempelajari bagaimana komponen yang dipelajari di dalam jaringan saraf secara kausal menghasilkan perilaku. Alih-alih hanya mengaitkan masukan dengan keluaran, peneliti membentuk hipotesis tentang fitur, kepala perhatian, neuron, dan sirkuit, kemudian melakukan intervensi untuk menguji hipotesis tersebut.
Bidang ini telah menghasilkan penjelasan terperinci untuk perilaku tertentu pada model kecil dan menengah, namun gambaran lengkap dan setia tentang model frontier masih belum tercapai. Penjelasan otomatis dan visualisasi menarik dapat menjadi titik awal yang berguna, bukan bukti.
Poin-poin utama
- Fitur adalah pola yang direpresentasikan; sirkuit adalah komponen yang berinteraksi yang diusulkan untuk melaksanakan suatu komputasi.
- Patch aktivasi, ablasi, dan pelacakan kausal menguji apakah sebuah komponen mengubah perilaku.
- Superposisi berarti satu neuron dapat berpartisipasi dalam banyak fitur; autoencoder jarang mencoba basis fitur yang berbeda.
- Metode interpretabilitas membutuhkan kebenaran dasar, pengujian yang dapat dipalsukan, cakupan, dan evaluasi terhadap penjelasan alternatif.
Dari representasi ke mekanisme
Probing menanyakan apakah informasi dapat didekode dari suatu aktivasi. Atribusi memperkirakan masukan atau komponen mana yang penting. Pekerjaan mekanistik melangkah lebih jauh dengan mengusulkan komputasi internal dan memeriksa apakah intervensi mengubah perilaku antara dan akhir yang diharapkan.
Ini membuatnya terkait namun lebih sempit dibandingkan AI yang dapat dijelaskan. Penjelasan post-hoc untuk satu keputusan tidak serta-merta merupakan algoritma yang direkayasa balik di dalam model.
Sirkuit dan intervensi kausal
Peneliti dapat mengidentifikasi kepala perhatian atau fitur yang terkait dengan suatu tugas, mengablasi-nya, mempatch aktivasi dari jalur lain, atau melacak bagaimana informasi bergerak melintasi lapisan. Hipotesis yang baik memprediksi perilaku pada contoh baru dan bertahan terhadap kontrol.
Intervensi dapat menciptakan keadaan di luar distribusi, sehingga perubahan perilaku tidak otomatis mengungkap komputasi alami. Gunakan beberapa metode, kontrol yang cocok, dan efek kuantitatif daripada satu prompt ilustratif.
Superposisi dan fitur jarang
Jaringan saraf dapat merepresentasikan lebih banyak fitur daripada dimensi individu dengan cara menumpukkannya. Oleh karena itu, sebuah neuron dapat aktif untuk beberapa pola yang tidak terkait, membuat label pada tingkat neuron menjadi menyesatkan.
Autoencoder jarang mempelajari kamus fitur yang lebih besar dari aktivasi model. Mereka dapat membuat pola lebih terpisah, namun sparsitas yang dipilih, data pelatihan, kesalahan rekonstruksi, dan label otomatis memengaruhi apa yang dipulihkan. Fitur jaringan saraf masih memerlukan validasi kausal.
Keamanan, debugging, dan keterbatasan
Alat mekanistik dapat membantu menemukan fakta yang dihafal, bias, strategi menipu, atau sirkuit kegagalan serta dapat mendukung penyuntingan atau pemantauan. Alat yang sama dapat melewatkan komputasi yang terdistribusi, jarang, atau bergantung pada konteks.
Anggap temuan sebagai bukti yang terbatas: versi model, tugas, dataset, lapisan, intervensi, efek, dan ketidakpastian. Hubungkan interpretasi dengan evaluasi perilaku, red‑team, dan tata kelola AI yang bertanggung jawab alih-alih menggunakannya sebagai sertifikat keamanan menyeluruh.
Representasi, sirkuit, dan bukti kausal
Interpretabilitas mekanistik mempelajari bagaimana komputasi internal menghasilkan perilaku model. Peneliti memeriksa aktivasi, bobot, perhatian, dan fitur antara, kemudian membentuk hipotesis tentang representasi dan sirkuit. Sebuah representasi tidak selalu disimpan dalam satu neuron; ia dapat tersebar di seluruh arah, lapisan, token, dan kombinasi yang bergantung pada konteks.
Autoencoder jarang berusaha mendekomposisi aktivasi padat menjadi kumpulan fitur yang lebih besar yang aktif secara selektif. Label fitur merupakan interpretasi manusia atas contoh yang diamati, bukan kebenaran dasar. Kesalahan rekonstruksi, sparsitas, pemisahan fitur, absorpsi, dan fitur mati memengaruhi apa yang terungkap oleh dekomposisi dan apa yang terlewat.
Korelasi tidak cukup untuk klaim mekanistik. Patch aktivasi, ablasi, pelacakan kausal, steering, dan intervensi bobot yang ditargetkan menguji apakah sebuah komponen mengubah perilaku sesuai prediksi. Intervensi juga dapat menciptakan keadaan di luar distribusi, sehingga hasil memerlukan kontrol, analisis dosis‑respons, penjelasan alternatif, dan replikasi lintas prompt serta model.
Alur kerja interpretabilitas yang ketat
Mulailah dengan perilaku yang diukur secara tepat dan dataset yang memisahkan hipotesis yang bersaing. Lokalisasikan lapisan, posisi, komponen, atau fitur yang relevan; inspeksi mekanisme kandidat; lakukan intervensi; dan uji apakah sirkuit yang diusulkan memprediksi kasus baru. Simpan contoh eksploratif terpisah dari evaluasi konfirmatori untuk mengurangi bias seleksi.
Alat otomatis dapat memberi peringkat pada neuron, fitur, kepala, atau jalur, sementara model bahasa dapat mengusulkan deskripsi. Otomatisasi meningkatkan cakupan tetapi dapat menghasilkan cerita yang tampak masuk akal. Nilai penjelasan pada contoh aktivasi yang ditahan dan prediksi kausal, catat ketidakpastian, dan buat artefak dapat direproduksi dengan versi model, tokenizer, prompt, dan kode.
Mechanisme dapat bersifat poli‑semantik, berlebih, nonlinier, dan terdistribusi. Menghapus satu komponen dapat digantikan oleh yang lain, sementara sebuah fitur dapat berpartisipasi dalam beberapa perilaku. Temuan negatif bersifat informatif: sirkuit yang tampak gagal di luar contoh yang dikurasi harus dipersempit atau ditolak alih-alih diselamatkan dengan penjelasan yang semakin samar.
Aplikasi, keterbatasan, dan klaim keamanan
Interpretabilitas dapat membantu debugging halusinasi, bias, memorisasi, perilaku jailbreak, atau generalisasi tak terduga; membandingkan model; dan menghasilkan hipotesis ilmiah. Ia juga dapat mengidentifikasi fitur untuk pemantauan atau intervensi. Penggunaan ini memerlukan validasi khusus tugas karena visualisasi riset yang berguna tidak otomatis menjadi kontrol produksi yang dapat diandalkan.
Ketiadaan fitur yang terdeteksi tidak membuktikan tidak adanya kemampuan atau niat, dan fitur yang dapat dibaca tidak membuktikan model menggunakannya dalam jawaban tertentu. Alat mengamati proyeksi komputasi dengan cakupan terbatas. Klaim keamanan harus menyebutkan sensitivitas deteksi, false positive, distribusi, lawan, dan titik buta yang diketahui.
Gunakan interpretabilitas bersama evaluasi perilaku, red‑team, tata kelola data, kontrol akses, pemantauan, dan respons insiden. Publikasikan metode dan contoh kontra bila memungkinkan. Bidang ini berkembang cepat, tetapi teknik saat ini belum memberikan penjelasan lengkap dan setia tentang penalaran model frontier atau jaminan umum tentang keselarasan.
Contoh terapan: menguji sirkuit model yang diusulkan
Misalkan sebuah model tampak menggunakan sekumpulan kepala perhatian dan fitur untuk menyelesaikan objek tidak langsung dalam sebuah kalimat. Peneliti mendefinisikan dataset terkontrol dengan variasi nama, posisi, gangguan, dan contoh kontra, lalu mengukur perilaku. Inspeksi aktivasi mengidentifikasi komponen kandidat, tetapi hipotesis ditulis sebelum intervensi: informasi apa yang dibawa tiap komponen, ke mana ia bergerak, dan bagaimana mengubahnya harus mengubah output.
Patch aktivasi dan ablasi menguji kebutuhan dan kecukupan pada contoh yang ditahan. Penyuntingan terarah yang mengubah token yang diprediksi ke arah yang diharapkan mendukung mekanisme; kerusakan kinerja yang luas tidak. Kontrol mempatch posisi dan komponen yang tidak terkait, mengubah besaran intervensi, dan membandingkan sirkuit alternatif. Tim mempublikasikan kasus negatif di mana penjelasan gagal dan menghindari memberi tujuan yang dapat dibaca manusia hanya dari korelasi.
Untuk mengklaim aplikasi keamanan, metode harus mendeteksi perilaku relevan dengan sensitivitas yang diketahui pada prompt realistis dan adaptasi adversarial. Monitor fitur dievaluasi untuk false positive, evasion, pembaruan model, dan relevansi kausal. Bukti interpretabilitas dapat memandu debugging dan pengujian lebih lanjut, tetapi penegakan tetap berada pada kontrol eksternal dan pemantauan perilaku. Diagram sirkuit yang menarik merupakan hipotesis ilmiah dengan bukti—bukan penjelasan lengkap tentang model atau jaminan atas perilaku yang belum terlihat.
Daftar periksa implementasi praktis
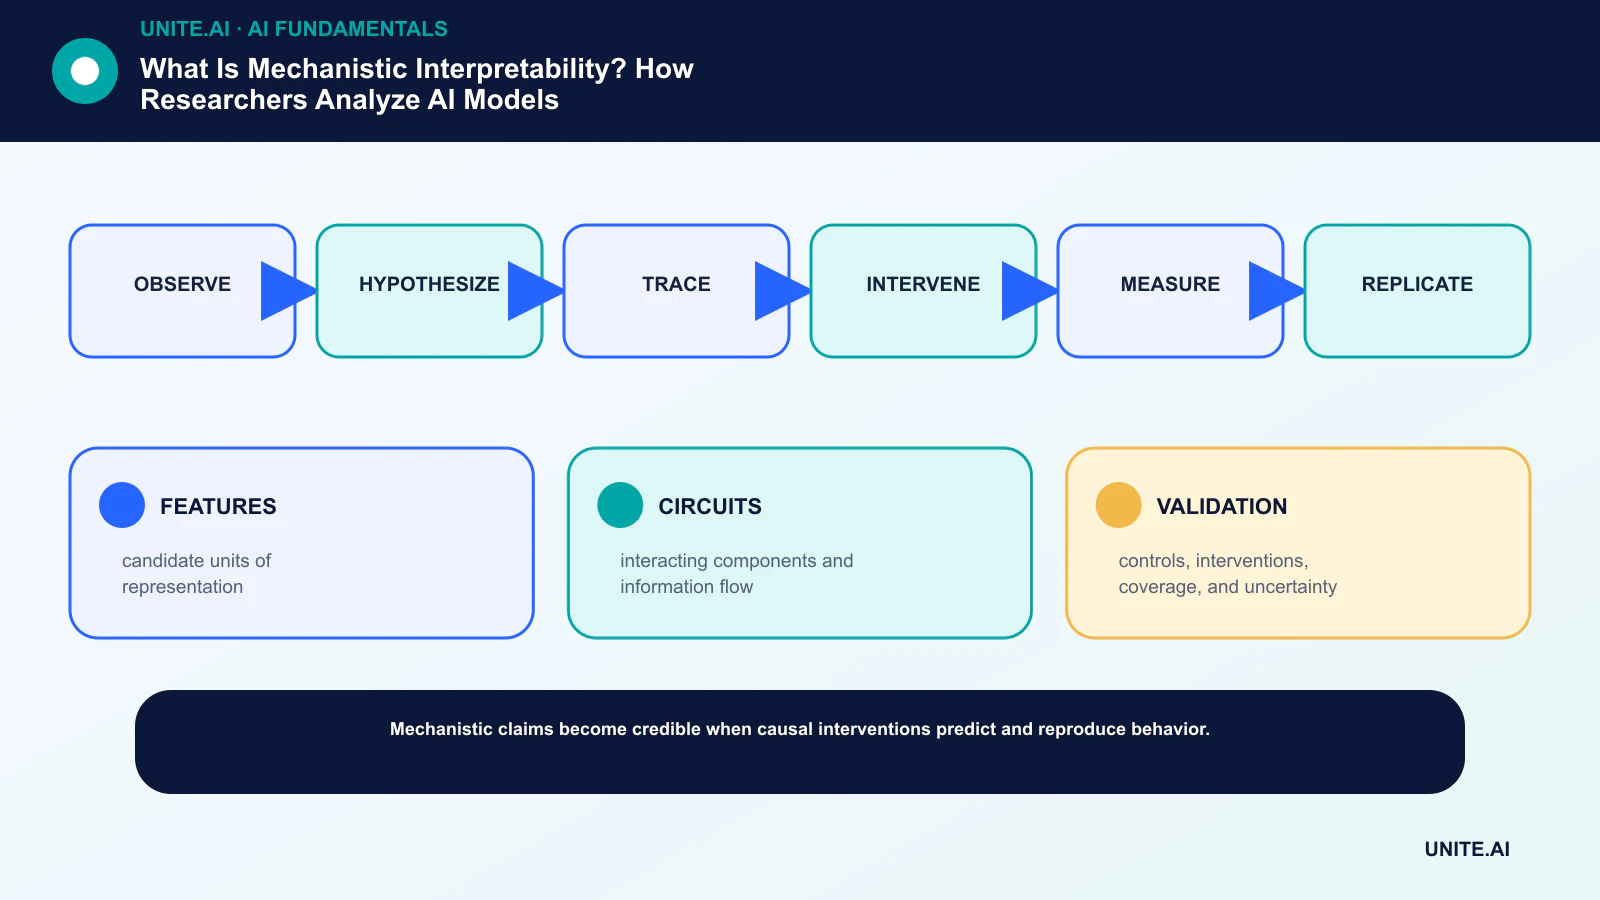
Ubah konsep menjadi alur kerja yang terbatas dan dapat diuji: amati → hipotesiskan → lacak → intervensi → ukur → replikasi. Tentukan pemilik yang bertanggung jawab, dokumentasikan data dan ketergantungan, buat baseline sederhana, tetapkan kriteria penerimaan dan penghentian, uji kegagalan representatif, dan definisikan pemantauan, rollback, serta tinjauan sebelum memperluas ruang lingkup. Catat versi dan asumsi sehingga tim lain dapat mereproduksi hasil dan memahami apa yang berubah.
Sebelum peluncuran, jalankan tinjauan kesiapan terdokumentasi dengan orang-orang yang membangun, mengoperasikan, mengamankan, dan terkena dampak sistem. Uji kasus normal, kondisi batas, kegagalan ketergantungan, dan penyalahgunaan; simpan bukti serta risiko yang belum terselesaikan. Tentukan siapa yang dapat menyetujui rilis, mengubah ambang, menimpa output, atau menghentikan operasi. Tinjau kembali keputusan setelah data dunia nyata tiba, karena pilot yang secara teknis berhasil tidak menjamin kinerja andal pada skala yang lebih luas.
- FITUR: unit kandidat representasi.
- SIRKUIT: komponen yang berinteraksi dan aliran informasi.
- VALIDASI: kontrol, intervensi, cakupan, dan ketidakpastian.
Pertanyaan yang sering diajukan
Apakah interpretabilitas mekanistik sama dengan membaca bobot model?
Tidak. Bobot mentah tidak dapat menjelaskan dirinya sendiri. Peneliti menganalisis aktivasi, fitur, komponen, dan intervensi untuk membangun serta menguji hipotesis kausal.
Dapatkah autoencoder jarang sepenuhnya menjelaskan LLM?
Tidak. Mereka menawarkan basis fitur kandidat dan dapat mendukung analisis sirkuit, tetapi cakupan, kesetiaan, rekonstruksi, pelabelan, dan skalabilitas tetap menjadi masalah terbuka.
Referensi utama












