Dasar-dasar AI
Apa Itu Model Campuran Pakar? AI Sparse Dijelaskan

 Tambahkan Unite.AI ke sumber pilihan Anda di Google
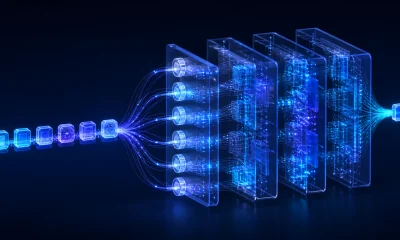
Model campuran pakar (MoE) berisi beberapa jaringan pakar yang diparameterisasi dan sebuah router yang memilih subset kecil untuk setiap masukan atau token. Karena hanya pakar yang dipilih yang dieksekusi, model dapat meningkatkan kapasitas total parameter tanpa mengaktifkan setiap parameter pada setiap lintasan maju.
Aktivasi spars tidak membuat komputasi atau memori menjadi gratis. Sistem MoE harus menyimpan dan memindahkan banyak parameter, menyeimbangkan token di antara pakar, mengoordinasikan perangkat, dan mencegah ketidakstabilan routing. Jumlah total parameter dan jumlah parameter aktif menggambarkan biaya yang berbeda.
Poin-poin penting
- Router menghitung skor pakar dan mengirim token ke top‑k pakar.
- Batas kapasitas dan tujuan penyeimbangan beban mencegah beberapa pakar menerima semua token.
- Komputasi spars dapat meningkatkan kapasitas per operasi tetapi meningkatkan kompleksitas komunikasi dan memori.
- Evaluasi kualitas, komputasi aktif, latensi, memori, perilaku routing, dan topologi layanan secara bersamaan.
Lapisan router dan pakar
Pada model transformer MoE, lapisan feed‑forward yang dipilih sering digantikan oleh jaringan feed‑forward pakar. Router memberi skor pada setiap token dan mengirimkannya ke satu atau lebih pakar; output mereka diberi bobot dan dikembalikan ke aliran residual utama.
Attention dapat tetap padat. Oleh karena itu, transformer di sekitarnya menggunakan campuran komputasi bersama dan komputasi pakar bersyarat.
Kapasitas dan penyeimbangan beban
Setiap pakar dapat memproses sejumlah token terbatas dalam satu batch. Jika terlalu banyak token memilih pakar yang sama, beberapa implementasi akan men-drop atau mengarahkan ulang kelebihan. Kerugian tambahan mendorong penggunaan yang seimbang, sementara noise routing dapat meningkatkan eksplorasi selama pelatihan.
Lalu lintas yang sama tidak berarti spesialisasi yang bermakna. Periksa penggunaan pakar berdasarkan domain, posisi, dan tugas, namun hindari memberi peran yang dapat dibaca manusia tanpa bukti kausal.
Mengapa penyajian sulit
Meskipun hanya sebagian kecil yang aktif, semua bobot pakar mungkin harus berada di memori akselerator. Paralelisme pakar mengirim token antar perangkat, menjadikan bandwidth jaringan dan komunikasi all‑to‑all sangat penting. Batch kecil dapat menyebabkan pakar tidak terpakai secara optimal.
Kuantisasi, caching, batching, dan routing yang sadar topologi dapat membantu. Bandingkan MoE dengan alternatif dense pada kualitas output, konteks, perangkat keras, dan tujuan level layanan yang sama—bukan hanya FLOP aktif.
Apa yang MoE lakukan dan tidak implikasikan
MoE menyediakan komputasi bersyarat dan kapasitas. Namun, MoE tidak menjamin kebenaran fakta, penalaran modular, interpretabilitas, atau panel agen independen. Jaringan pakar dipelajari secara bersama dan dapat berbagi fitur yang tersebar.
MoE melengkapi generative-AI pasca‑pelatihan dan kompresi. Pantau drift routing, latensi ekor, kegagalan pakar, memori, dan kualitas domain setelah penerapan.
Routing, kapasitas pakar, dan komputasi spars
Lapisan campuran pakar berisi beberapa jaringan pakar dan sebuah router yang menugaskan setiap token ke subset kecil, biasanya satu atau dua pakar teratas. Model dapat menyimpan banyak parameter sekaligus mengaktifkan hanya sebagian kecil per token. Aktivasi spars mengurangi komputasi dibandingkan model dense dengan jumlah total parameter serupa, bukan dibandingkan setiap model yang lebih kecil.
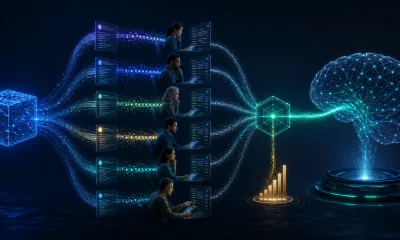
Router menghasilkan skor pakar, menerapkan aturan seleksi, dan mengirim representasi token. Setiap pakar memiliki kapasitas terbatas. Jika terlalu banyak token memilih satu pakar, sistem harus men-drop, mengarahkan ulang, atau menambah padding token. Faktor kapasitas, kerugian penyeimbangan tambahan, noise router, dan paralelisme pakar menukar kualitas dengan pemanfaatan dan komunikasi.
Pakar tidak dijamin memetakan secara bersih ke konsep atau domain manusia. Spesialisasi muncul dari optimasi dan dapat tersebar, tidak stabil, atau bergantung pada token. Klaim interpretabilitas harus memeriksa routing lintas lapisan dan konteks serta menggunakan intervensi, bukan hanya label yang disimpulkan dari beberapa token dengan skor tinggi.
Pelatihan dan penyajian model MoE terdistribusi
Pelatihan menggabungkan paralelisme data, tensor, pipeline, dan pakar. Token sering harus berpindah antar akselerator untuk mencapai pakar yang dipilih, sehingga komunikasi all‑to-all dapat menghilangkan penghematan aritmetika. Penempatan, komposisi batch, bandwidth jaringan, pengemasan token, dan tumpang tindih komunikasi dengan komputasi merupakan pilihan desain sistem utama.
Ketidakseimbangan beban menghasilkan pakar menganggur dan perangkat yang kelebihan beban. Tujuan tambahan mendorong routing yang seimbang tetapi dapat mengganggu tujuan pembelajaran utama; metode terbaru mungkin menyesuaikan bias atau dinamika routing. Pantau jumlah token per pakar, token yang di-drop, entropi, gradien, dan waktu perangkat alih-alih hanya mengandalkan kerugian agregat.
Penyajian sulit karena semua bobot pakar mungkin harus tetap tersedia meskipun setiap token hanya menggunakan beberapa. Kapasitas memori, interkoneksi, batching, perilaku cache, dan variabilitas routing memengaruhi latensi. Kuantisasi dan offloading pakar membantu pada beberapa pengaturan tetapi dapat menambah transfer. Lakukan benchmark pada model dan topologi perangkat keras yang tepat.
Kualitas, evaluasi, dan pertukaran penerapan
Evaluasi model MoE dibandingkan baseline dense dengan kualitas, komputasi pelatihan, komputasi inferensi, memori, latensi, dan biaya yang sebanding. Perbandingan hanya berdasarkan jumlah parameter dapat menyesatkan. Uji konteks panjang, bahasa, domain, token langka, dan prompt adversarial karena perilaku router dapat berubah dengan distribusi dan menghasilkan kemampuan yang tidak merata.
Routing memperkenalkan mode kegagalan tambahan: keruntuhan pakar, spesialisasi tidak stabil, token yang di-drop, gangguan yang berkorelasi, dan sensitivitas terhadap komposisi batch. Evaluasi deterministik harus mengontrol runtime dan pengaturan routing. Pemantauan operasional harus mencakup pemanfaatan pakar dan kesehatan komunikasi sehingga masalah sistem tidak disalahartikan sebagai variasi model biasa.
MoE menarik ketika skala total kapasitas penting dan infrastruktur dapat mendukung eksekusi terdistribusi spars. Model dense mungkin tetap lebih sederhana dan lebih cepat untuk batch kecil, perangkat edge, atau interkoneksi terbatas. Arsitektur ini merupakan pertukaran sistem, bukan pengganti universal untuk transformer dense.
Contoh kerja: mengevaluasi model bahasa MoE
Sebuah tim riset membandingkan transformer MoE dengan baseline dense menggunakan token pelatihan yang sebanding dan beberapa tampilan sumber daya: parameter aktif per token, total parameter, memori akselerator, lalu lintas jaringan, waktu pelatihan, throughput inferensi, dan latensi. Mereka mencatat probabilitas router, token per pakar, overflow, token yang di-drop, dan kerugian tambahan per lapisan, bahasa, dan domain. Hitungan aritmetika yang lebih rendah tidak dianggap efisien jika komunikasi atau underutilisasi meningkatkan total biaya.
Evaluasi kualitas mencakup pengetahuan, penalaran, konteks panjang, domain langka, tugas multibahasa, keamanan, dan kalibrasi. Tim tersebut mengubah komposisi batch dan distribusi prompt untuk melihat apakah routing dan output berubah secara tak terduga. Ablasi pakar kausal menguji klaim spesialisasi, sementara kegagalan pakar dan degradasi jaringan mengungkap ketahanan. Hasil dibandingkan pada target level layanan yang sama karena model yang hanya tampil baik pada batch besar mungkin tidak cocok untuk penggunaan interaktif.
Untuk penerapan, pakar ditempatkan untuk meminimalkan lalu lintas all‑to‑all, bobot dikuantisasi hanya setelah pemeriksaan sensitivitas per pakar, dan pemantauan runtime mendeteksi ketidakseimbangan atau perangkat yang tidak tersedia. Pengaturan kapasitas dan routing di‑versi bersama model. Tim memilih MoE hanya jika penambahan kapasitas parameter meningkatkan tugas yang diperlukan cukup untuk membenarkan memori dan kompleksitas sistem terdistribusi; jika tidak, model dense mungkin lebih murah, lebih mudah dioperasikan, dan lebih dapat diprediksi.
Daftar periksa implementasi praktis
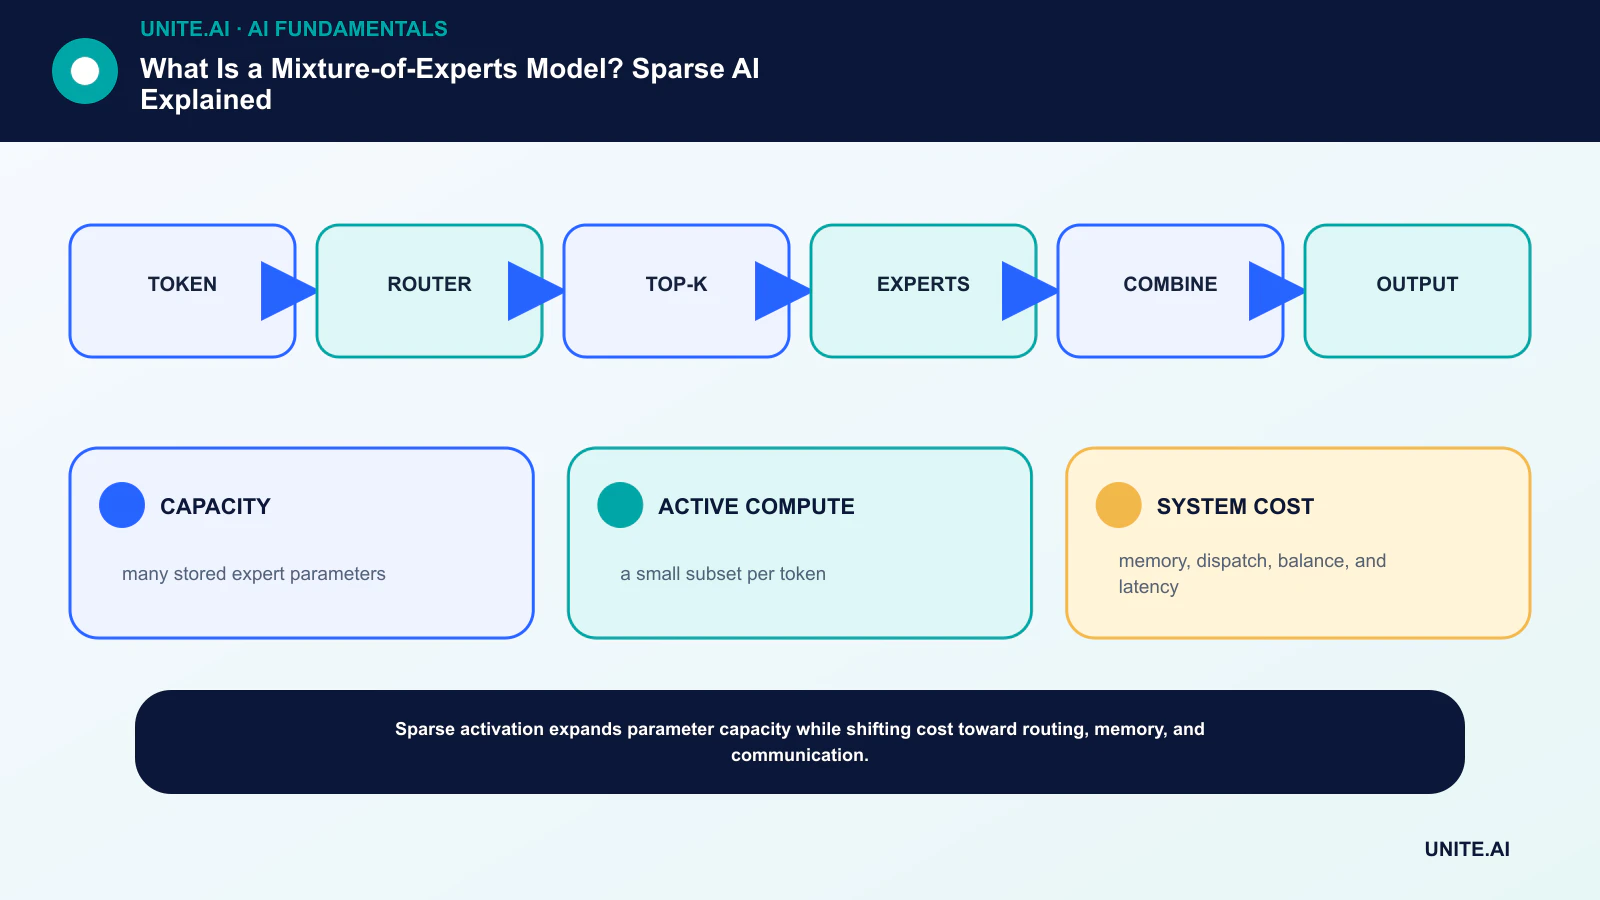
Ubah konsep menjadi alur kerja yang terbatas dan dapat diuji: token → router → top‑k → pakar → gabungkan → output. Tetapkan pemilik yang bertanggung jawab, dokumentasikan data dan ketergantungan, buat baseline sederhana, tetapkan kriteria penerimaan dan penghentian, uji kegagalan representatif, dan definisikan pemantauan, rollback, serta tinjauan sebelum memperluas cakupan. Catat versi dan asumsi sehingga tim lain dapat mereproduksi hasil dan memahami apa yang berubah.
Sebelum peluncuran, lakukan tinjauan kesiapan yang terdokumentasi bersama orang yang membangun, mengoperasikan, mengamankan, dan terpengaruh oleh sistem. Uji kasus normal, kondisi batas, kegagalan ketergantungan, dan penyalahgunaan; simpan bukti dan risiko yang belum terselesaikan. Tentukan siapa yang dapat menyetujui rilis, mengubah ambang, menimpa output, atau menghentikan operasi. Tinjau kembali keputusan setelah data dunia nyata muncul, karena pilot yang secara teknis berhasil tidak menjamin kinerja yang dapat diandalkan pada skala yang lebih luas.
- CAPACITY: banyak parameter pakar yang disimpan.
- ACTIVE COMPUTE: subset kecil per token.
- SYSTEM COST: memori, pengiriman, penyeimbangan, dan latensi.
Pertanyaan yang sering diajukan
Apakah pakar MoE merupakan model terpisah?
Biasanya tidak. Mereka adalah subnet jaringan di dalam satu model yang dilatih, terhubung oleh router dan lapisan bersama. Spesialisasi yang dipelajari mungkin tidak selaras dengan domain yang intuitif.
Mengapa MoE dapat memiliki banyak parameter tetapi komputasi sedang?
Hanya sekumpulan kecil top‑k pakar yang diaktifkan untuk setiap token. Parameter pakar yang tidak aktif tetap mengonsumsi penyimpanan dan memori serta dapat menimbulkan biaya komunikasi.
Referensi utama