Fondamentaux de l’IA
Qu’est‑ce que l’apprentissage automatique ?

 Ajouter Unite.AI à vos sources préférées sur Google
Machine learning (ML) est une branche de l’intelligence artificielle dans laquelle un système apprend des motifs à partir de données afin de pouvoir faire des prédictions, des classifications, des recommandations ou des décisions sans qu’un développeur n’écrive une règle distincte pour chaque cas possible. Le résultat n’est pas une machine qui « pense » comme une personne. Il s’agit d’un modèle statistique qui associe des entrées à des sorties utiles et qui peut être évalué sur des données qu’il n’a pas vues lors de l’entraînement.
L’apprentissage automatique fait partie du champ plus large de l’IA, tandis que le deep learning est une famille de méthodes d’apprentissage automatique basées sur des réseaux de neurones à plusieurs couches. Cette distinction est importante: tous les systèmes d’IA n’utilisent pas le ML, et tous les problèmes de ML ne nécessitent pas un réseau de neurones.
Points clés
- Le ML apprend une relation à partir d’exemples plutôt que de se fier uniquement à des règles écrites à la main.
- Un modèle utile doit se généraliser à de nouvelles données, et non se contenter de mémoriser son ensemble d’entraînement.
- L’apprentissage supervisé, non supervisé, semi‑supervisé, auto‑supervisé et par renforcement résolvent différents types de problèmes.
- La qualité des données, la conception de l’évaluation et la surveillance sont aussi importantes que l’algorithme.
Comment fonctionne l’apprentissage automatique
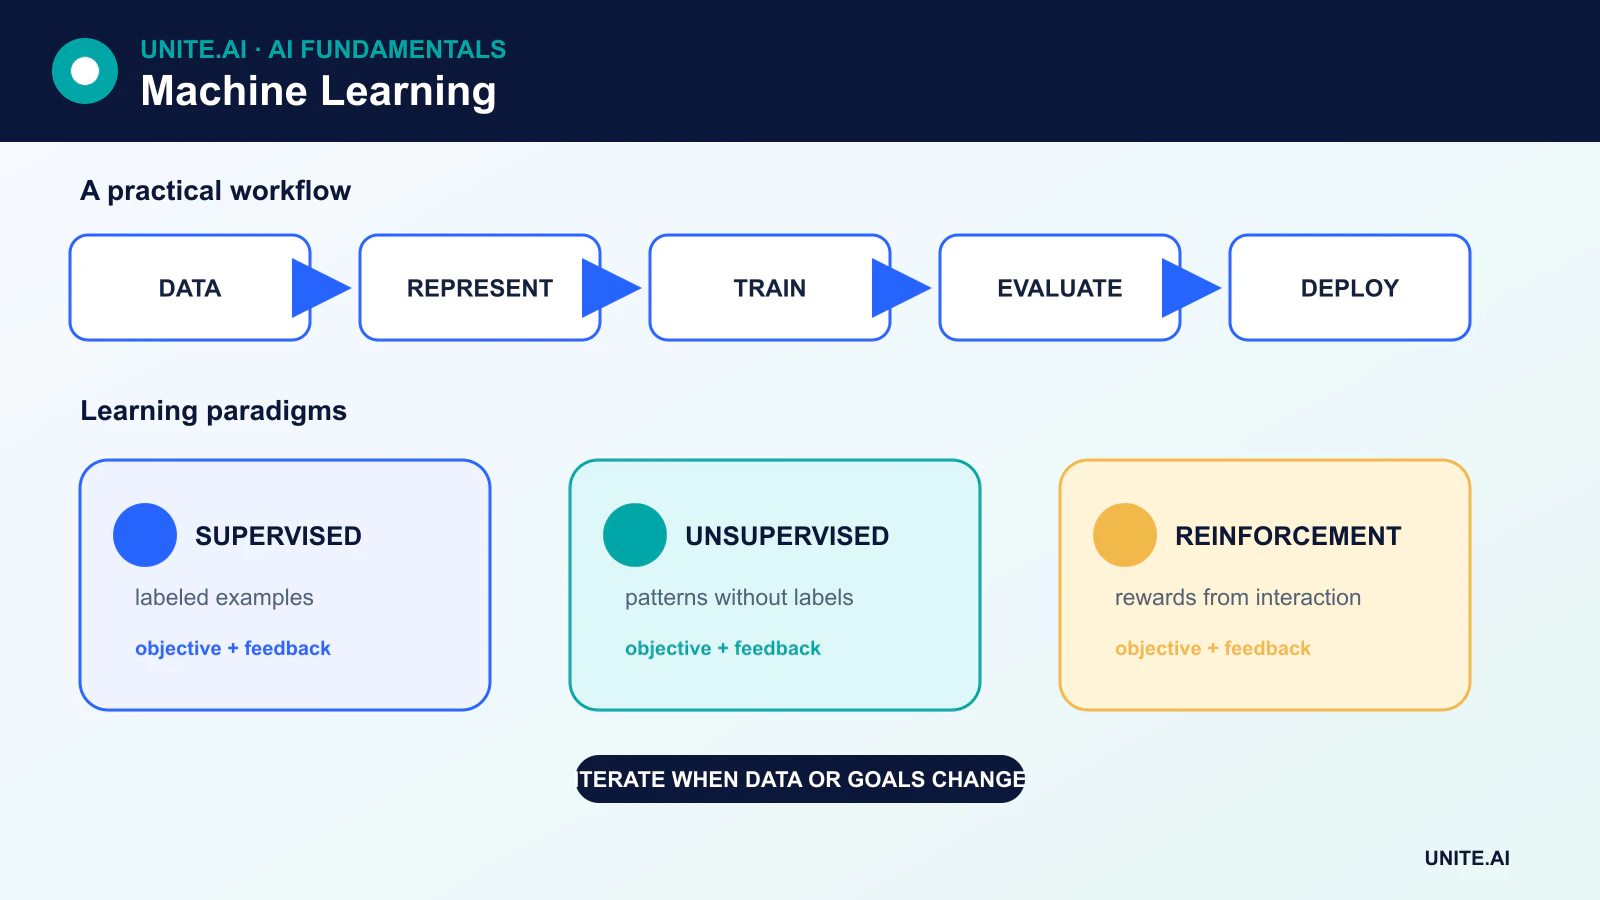
La plupart des projets de ML peuvent être compris comme une séquence de six étapes:
- Définir la tâche. Décider ce que le système doit prédire ou découvrir et ce que signifie le succès dans l’application réelle.
- Collecter et préparer les données. Nettoyer les enregistrements, gérer les valeurs manquantes, créer des caractéristiques utiles et documenter la provenance des données.
- Diviser les données. Un ensemble d’entraînement sert à ajuster le modèle, un ensemble de validation aide à choisir les paramètres, et un ensemble de test fournit une estimation finale sur des données non exploitées.
- Entraîner le modèle. Un algorithme ajuste les paramètres du modèle pour réduire une fonction de perte ou satisfaire un autre objectif d’apprentissage.
- Évaluer la généralisation. Les métriques doivent refléter la tâche, l’équilibre des classes, les coûts d’erreur et la population sur laquelle le modèle fonctionnera.
- Déployer et surveiller. Les données du monde réel peuvent évoluer, de sorte que les équipes surveillent le dérive, la dégradation des performances, les biais et les pannes opérationnelles.
Les variables fournies à un modèle sont communément appelées caractéristiques. En apprentissage supervisé, la réponse souhaitée s’appelle l’étiquette ou la cible. Les paramètres appris par le modèle codent une relation entre les caractéristiques et la sortie ; ils ne constituent pas une base de données de règles explicites.
Les principaux paradigmes d’apprentissage
Apprentissage supervisé
Dans l’apprentissage supervisé, les exemples comprennent à la fois les entrées et les cibles connues. Un modèle de classification prédit des catégories, par exemple si une transaction est frauduleuse. Un modèle de régression prédit une valeur continue, comme la demande énergétique prévue.
Les algorithmes supervisés courants comprennent les arbres de décision, les machines à vecteurs de support, les K‑plus proches voisins, la régression linéaire et logistique, les arbres à gradient boosté, et les réseaux de neurones. Un seuil de classification tel que 0,5 est une décision choisie après que le modèle ait produit un score ou une probabilité ; ce n’est pas une propriété immuable de la régression logistique.
Apprentissage non supervisé
L’apprentissage non supervisé travaille avec des données qui ne contiennent pas d’étiquettes cibles. L’objectif peut être de trouver des regroupements, de détecter des observations inhabituelles, d’estimer une distribution ou de créer une représentation de dimension inférieure. Un cluster est un groupe suggéré par une règle de similarité ; il n’est pas automatiquement une classe réelle significative.
Parmi les exemples figurent le clustering K‑means, l’analyse en composantes principales, l’estimation de densité, et certaines formes d’auto‑encodeurs. Un auto‑encodeur apprend à reconstruire son entrée via une représentation compressée. Il ne crée pas automatiquement des étiquettes de vérité terrain.
Apprentissage semi‑supervisé et auto‑supervisé
L’apprentissage semi‑supervisé combine un petit jeu de données étiquetées avec un plus grand jeu de données non étiquetées. L’apprentissage auto‑supervisé crée un signal d’entraînement à partir des données elles‑mêmes—par exemple, prédire des mots masqués ou faire correspondre deux vues transformées de la même image. L’auto‑supervision est centrale dans de nombreux pipelines modernes de transformers et de modèles de fondation car elle peut exploiter de vastes collections de texte, d’images, d’audio ou de vidéo sans qu’une personne n’étiquette chaque exemple.
Apprentissage par renforcement
Dans l’apprentissage par renforcement, un agent effectue des actions dans un environnement et reçoit des récompenses ou des coûts. L’objectif est d’apprendre une politique qui maximise la récompense cumulative attendue. Cela diffère de l’apprentissage supervisé car l’action correcte n’est pas fournie pour chaque état, et une action peut influencer les données que l’agent rencontrera ensuite.
Entraînement, validation et généralisation
Un modèle qui fonctionne bien sur ses exemples d’entraînement peut néanmoins échouer sur de nouvelles données. Cet échec est appelé surapprentissage. Les équipes le réduisent grâce à une capacité de modèle adaptée, la régularisation, la validation croisée, l’augmentation de données, la prévention des fuites et un véritable ensemble de test indépendant.
Il n’existe pas de métrique unique pour chaque tâche de ML. La classification peut nécessiter la précision, le rappel, le F1, la calibration ou une mesure pondérée par le coût plutôt que la simple exactitude. La régression peut utiliser l’erreur absolue moyenne, la racine de l’erreur quadratique moyenne ou une perte spécifique au domaine. Le clustering nécessite différentes formes d’évaluation interne ou validée extérieurement. La métrique doit refléter ce que représente une erreur pour l’utilisateur ou l’organisation.
Les algorithmes d’apprentissage automatique sont des outils, pas des garanties
Un algorithme comporte des hypothèses. Les modèles linéaires supposent une forme particulière de relation. Les K‑plus proches voisins supposent que la distance sélectionnée représente une similarité significative. Le Naïve Bayes suppose que les caractéristiques sont conditionnellement indépendantes étant donné la classe. Les arbres de décision partitionnent l’espace des caractéristiques à l’aide de règles de division apprises ; leurs feuilles contiennent des prédictions basées sur des groupes d’observations d’entraînement plutôt que nécessairement sur une seule observation chacune.
Le choix du modèle dépend donc de la taille des données, du type de caractéristiques, des exigences de latence, des besoins d’interprétabilité et du coût des erreurs. Un modèle plus simple peut surpasser un modèle plus volumineux lorsque les données sont limitées ou que les contraintes opérationnelles privilégient la rapidité et la transparence.
Où l’apprentissage automatique est utilisé
Le ML prend en charge le classement de recherche, les recommandations, les prévisions, la détection d’anomalies, la traduction, la reconnaissance vocale, la vision par ordinateur, la maintenance prédictive, la détection de fraude et l’analyse scientifique. Les mêmes techniques peuvent également amplifier les biais historiques, exposer des informations sensibles ou se comporter de manière imprévisible lors d’un décalage de distribution. Un déploiement responsable nécessite une documentation, une supervision humaine lorsque cela est approprié, des tests de sécurité et une surveillance continue.
De la définition du problème à une expérience d’apprentissage automatique valide
Un projet d’apprentissage automatique doit commencer par une décision et un résultat mesurable, pas par un algorithme. Définissez l’unité de prédiction, la cible, le moment d’observation, le moment de décision, les caractéristiques disponibles et le coût de chaque erreur. Pour un modèle de churn, par exemple, utiliser des événements enregistrés après l’annulation divulguerait la réponse. Établissez une règle simple ou une référence statistique, puis divisez les données par temps, client, localisation ou toute autre frontière reflétant le déploiement. Des découpages aléatoires de lignes peuvent placer des observations presque identiques dans les ensembles d’entraînement et de test et produire un score trompeur.
L’ingénierie des caractéristiques convertit les enregistrements bruts en représentations utilisables par le modèle, mais chaque caractéristique nécessite une traçabilité et une garantie de disponibilité. Ajustez la normalisation, le vocabulaire, l’imputation et la réduction de dimensionnalité uniquement sur les données d’entraînement, puis appliquez la transformation apprise aux données de validation et de test. La validation croisée estime la variation entre les échantillons ; un ensemble de test final non exploité soutient la décision de mise en production. Sélectionnez les métriques en fonction des conséquences: précision et rappel pour des erreurs de classification inégales, calibration lorsque les probabilités guident l’action, et mesures pondérées par le coût ou l’utilité lorsque les erreurs ont des effets opérationnels différents.
Déploiement, surveillance et exploitation responsable
L’inférence en production répète la transformation complète réalisée lors de l’entraînement et renvoie une prédiction sous les contraintes de latence, de débit et de disponibilité. Emballez le pré‑traitement avec le modèle, validez les schémas d’entrée, versionnez les artefacts et comparez les résultats entre les implémentations hors ligne et de service. Choisissez un seuil en fonction de la capacité opérationnelle et du compromis d’erreur plutôt qu’en se limitant à 0,5 par défaut. Déployez via une évaluation en mode ombre, un groupe limité ou une expérience avec des métriques de garde. Conservez un repli déterministe et un chemin de retour en cas de défaillance de dépendance ou de comportement inacceptable.
Surveillez la qualité des entrées, le dérive des caractéristiques, la distribution des prédictions, la calibration, les résultats par sous‑groupe, la latence, le coût et les étiquettes confirmées lorsqu’elles arrivent. Le dérive est un signal à investiguer, pas une preuve automatique que le ré‑entraînement aidera. Le ré‑entraînement nécessite des données révisées, des tests reproductibles, une approbation et une comparaison avec le modèle actuel. Documentez les usages prévus et non valides, les droits sur les données, la confidentialité, la sécurité, l’intervention humaine et le recours lorsque des personnes sont concernées. L’apprentissage automatique est un système de décision maintenu ; le fichier du modèle n’est qu’un composant remplaçable.
Exemple pratique : prédiction de pannes d’équipement
Un fabricant définit une prédiction par machine‑jour: si une panne vérifiée surviendra dans les sept jours en utilisant uniquement la télémétrie disponible au début de ce jour. Il divise les données par machine et par temps, les compare à des règles basées sur l’âge et des seuils, ajuste le pré‑traitement sur les données d’entraînement et évalue le rappel d’événements, les fausses alertes, le délai d’avertissement, la calibration et la capacité de maintenance. Le remplacement de capteurs et les arrêts planifiés sont modélisés comme contexte opérationnel plutôt que comme des observations ordinaires.
Le modèle fonctionne d’abord en mode ombre. Les alertes affichent la télémétrie contributive et l’incertitude, mais les mainteneurs décident d’inspecter ou non. Les constats et les causes confirmées deviennent des étiquettes gouvernées ; l’absence d’ordre de travail n’est pas supposée signifier l’absence de panne. Un déploiement progressif utilise des limites d’alerte et un repli manuel, tandis que la surveillance suit la santé des capteurs, le dérive des entrées, la précision révisée, les temps d’arrêt et la maintenance inutile. Le ré‑entraînement n’a lieu qu’après que l’examen des données et des seuils démontre une amélioration probable par rapport au système actuellement déployé.
Preuves d’implémentation et disponibilité opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement opérationnel, les entrées, les sorties, les dépendances, le propriétaire et la conséquence de chaque défaillance importante. Établissez une base de référence reproductible et un ensemble d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le décalage de distribution, les pannes de dépendance, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et chaque seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Références principales