Fondamentaux de l’IA
Qu’est‑ce que l’apprentissage profond ?

 Ajouter Unite.AI à vos sources préférées sur Google
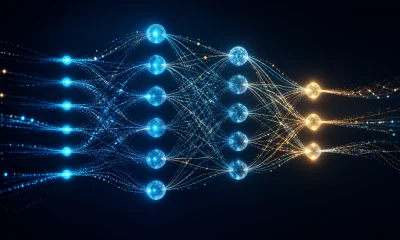
Apprentissage profond est une famille de méthodes d’apprentissage automatique qui utilise des réseaux neuronaux à plusieurs couches de traitement pour apprendre des représentations utiles des données. Ces modèles alimentent de nombreux systèmes modernes pour le langage, les images, l’audio, les recommandations, la prévision scientifique et l’IA générative.
Le mot deep fait référence au nombre de transformations entre l’entrée et la sortie, et non à une machine possédant une compréhension plus profonde. Un modèle profond apprend des relations numériques utiles à son objectif d’entraînement, et ses performances doivent encore être testées sur de nouvelles données.
Points clés
- L’apprentissage profond est un sous‑ensemble de l’apprentissage automatique.
- Les couches transforment les tenseurs à l’aide de paramètres appris, d’activations non linéaires, de normalisation et d’autres opérations.
- La rétropropagation calcule les gradients ; un optimiseur utilise ces gradients pour mettre à jour les paramètres entraînables, y compris les poids et les biais.
- Les CNN, les réseaux récurrents, les transformeurs, les auto‑encodeurs et les modèles de diffusion ont des structures et des forces différentes.
Comment un réseau neuronal profond apprend
Un réseau neuronal reçoit les données sous forme de tenseurs, c’est‑à‑dire des tableaux multidimensionnels de nombres. Un tenseur d’image peut coder les canaux de pixels, tandis qu’un modèle de langage utilise des vecteurs représentant des tokens. Chaque couche effectue une transformation différentiable et transmet le résultat à la couche suivante.
Dans une couche dense de base, le modèle calcule une somme pondérée de ses entrées, ajoute un biais entraînable, puis applique une fonction d’activation :
output = activation(Wx + b)
La fonction d’activation introduit la non‑linéarité. Sans elle, empiler des couches linéaires ordinaires ne représenterait toujours qu’une transformation linéaire. ReLU et ses variantes sont courantes dans les couches cachées, tandis que les activations de sortie dépendent de la tâche.
L’entraînement suit généralement quatre étapes :
- Un passage avant génère des prédictions.
- Une fonction de perte mesure à quel point les prédictions diffèrent de l’objectif.
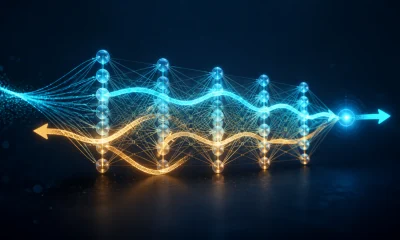
- La rétropropagation applique la règle de chaîne pour calculer le gradient de la perte par rapport à chaque paramètre entraînable.
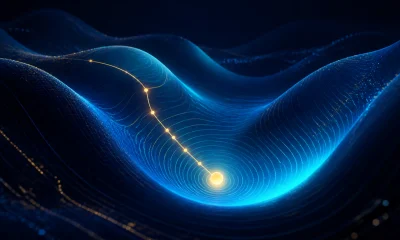
- Un optimiseur tel que la descente de gradient stochastique ou AdamW met à jour les paramètres.
Répéter ces étapes sur de nombreux lots peut améliorer le modèle, mais une perte d’entraînement plus faible ne garantit pas un comportement fiable en situation réelle. La validation, la régularisation, des données représentatives et la surveillance restent essentielles.
Principales architectures d’apprentissage profond
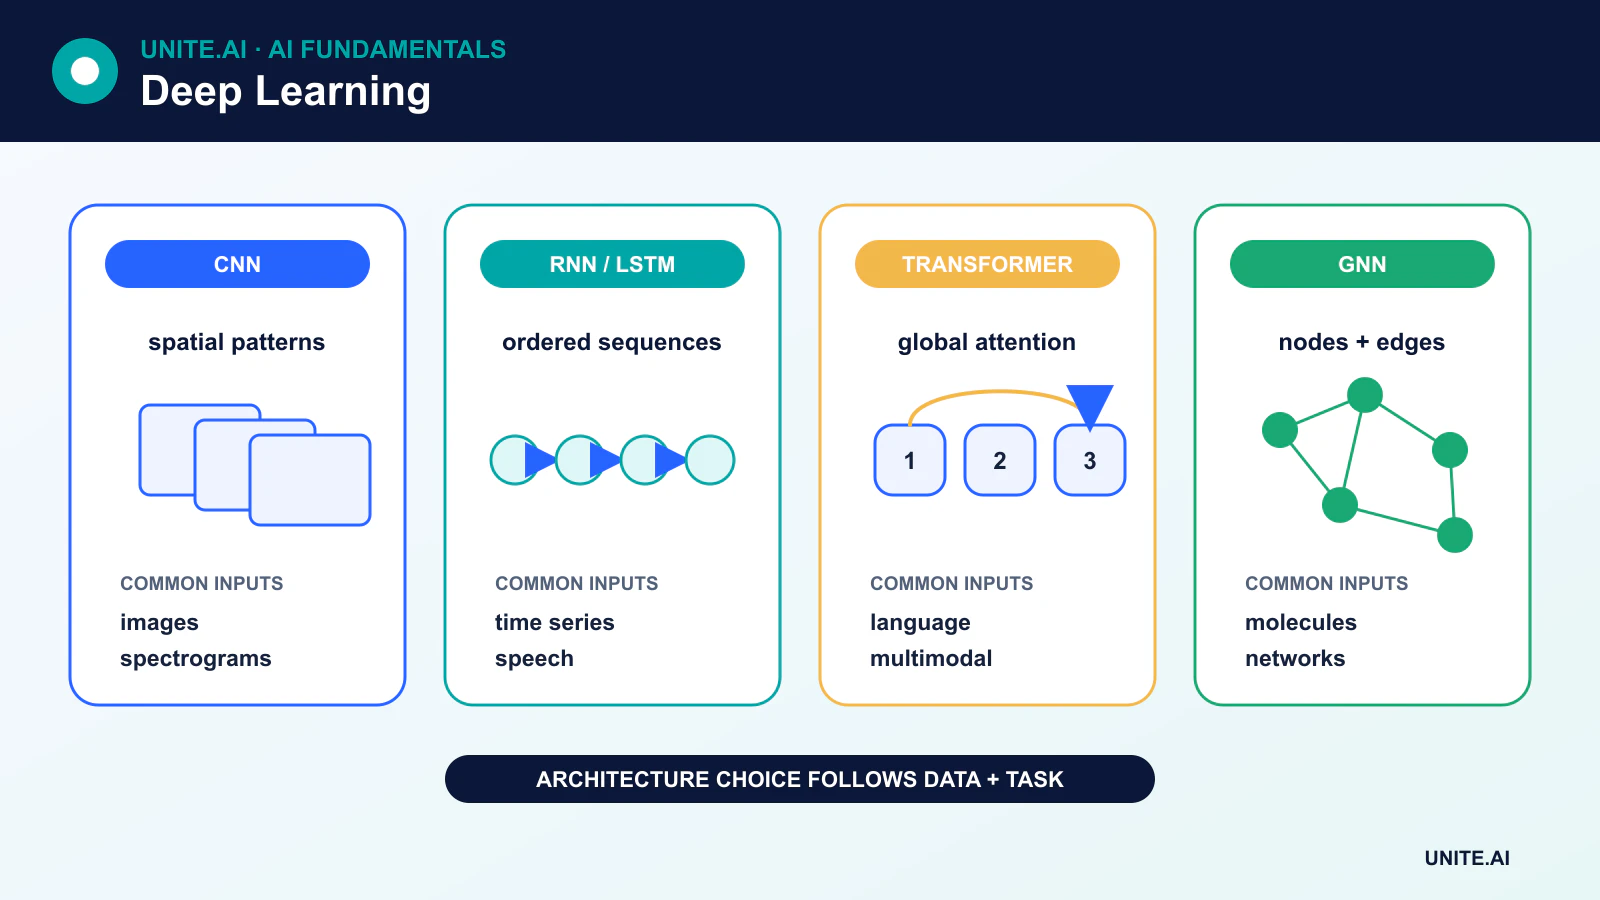
Perceptrons multicouches
Un perceptron multicouche (MLP) utilise des couches entièrement connectées dans lesquelles chaque unité de sortie dépend de toutes les entrées de la couche précédente. Les MLP sont utiles pour les caractéristiques tabulaires et comme composants au sein de systèmes plus vastes, mais ils n’intègrent pas d’hypothèses concernant la localité des images ou l’ordre des séquences.
Réseaux neuronaux convolutionnels
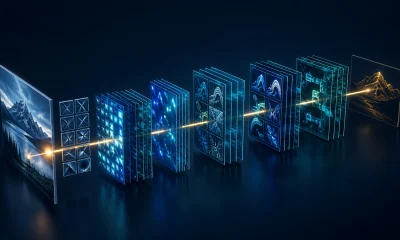
Les réseaux neuronaux convolutionnels (CNN) appliquent des filtres appris sur des régions locales. Le partage de poids les rend efficaces pour les grilles telles que les images et les spectrogrammes. Les CNN restent importants pour la vision et le déploiement en périphérie, bien que les transformeurs visionnels et les modèles hybrides soient également largement utilisés.
Réseaux récurrents, LSTM et GRU
Les réseaux neuronaux récurrents (RNN) mettent à jour un état caché au fur et à mesure du traitement d’une séquence. Les LSTM et les unités récurrentes à portes (GRU) aident à préserver l’information et à réduire le problème du gradient qui disparaît, qui fait que les RNN de base peinent avec les dépendances longues. Ils n’éliminent pas toutes les limitations de contexte long, mais restent utiles pour les signaux en flux, les séries temporelles et les modèles séquentiels compacts.
Transformeurs
Les transformeurs utilisent l’attention pour modéliser les relations entre les éléments d’une séquence ou d’un ensemble. Leur capacité à traiter de nombreuses positions en parallèle les a aidés à remplacer la récurrence dans la plupart des grands systèmes de langage, et les variantes de transformeur traitent maintenant les images, l’audio, la vidéo, les protéines et les données multimodales.
Auto‑encodeurs et modèles génératifs
Un auto‑encodeur compresse une entrée en une représentation et reconstruit l’entrée à partir de celle‑ci. Cela crée un objectif de reconstruction auto‑supervisé ; cela ne convertit pas automatiquement des données non étiquetées en exemples étiquetés.
Les réseaux antagonistes génératifs entraînent un générateur et un discriminateur en compétition. Les modèles de diffusion apprennent à inverser un processus de bruitage progressif. Les transformeurs autoregressifs génèrent un token ou une unité à la fois. Ces approches ont des dynamiques d’entraînement, une contrôlabilité et des exigences de calcul différentes.
Pourquoi la profondeur aide — et pourquoi l’architecture compte
Plusieurs couches permettent à un modèle de composer des transformations simples en des transformations plus complexes. En vision, certaines caractéristiques apprises peuvent évoluer des textures locales vers des motifs spécifiques à la tâche. En langage, les couches d’attention construisent des représentations de tokens dépendantes du contexte. Ces descriptions sont des intuitions utiles, pas des règles fixes sur ce que chaque couche doit apprendre.
Les réseaux modernes s’appuient également sur les connexions résiduelles, la normalisation, une initialisation soigneuse, la régularisation et du matériel optimisé. Ajouter simplement des couches ou des paramètres peut rendre un modèle plus difficile à entraîner, plus lent, ou plus sujet au surapprentissage. L’échelle du modèle n’aide que lorsque les données, l’objectif, l’optimisation et le contexte de déploiement le permettent.
Entraînement vs inférence
Entraînement ajuste les paramètres et constitue généralement l’étape la plus gourmande en calcul. Inférence exécute le modèle entraîné pour produire une sortie. L’inférence peut rester coûteuse pour les grands modèles, c’est pourquoi les équipes utilisent la quantisation, la distillation, le traitement par lots, la mise en cache, la parcimonie et du matériel spécialisé tel que les unités de traitement neuronal.
Limites et utilisation responsable
Les modèles profonds peuvent hériter de biais, mémoriser des informations sensibles, échouer lors d’un changement de distribution et produire des sorties convaincantes mais incorrectes. Ils peuvent également être difficiles à interpréter et coûteux à entraîner. L’évaluation doit couvrir plus qu’une moyenne de benchmark : les équipes ont besoin de performances au niveau des classes ou des sous‑groupes, de robustesse, de calibration, de sécurité, de latence, de consommation d’énergie et des conséquences d’un échec.
Représentations, optimisation et choix d’architecture
Les réseaux profonds apprennent des représentations successives via des couches paramétrées. Les transformations linéaires mélangent les entrées ; les activations non linéaires permettent au réseau d’approximer des fonctions complexes ; la normalisation et les connexions résiduelles facilitent l’optimisation ; l’attention, la convolution, la récurrence ou les opérations d’espace d’état codent différentes hypothèses structurelles. La profondeur augmente le nombre de transformations, sans garantir d’intelligence. L’architecture doit refléter la modalité, le volume de données, la latence, la mémoire et les invariances de la tâche. Un modèle convolutionnel plus petit peut surpasser un transformeur lorsque les données sont limitées et que la structure spatiale locale domine.
L’entraînement calcule une perte, la différencie avec la rétropropagation et met à jour les paramètres avec un optimiseur tel que la descente de gradient stochastique ou Adam. La taille du lot, le taux d’apprentissage, le planning, l’initialisation, la régularisation et la précision numérique interagissent. Les courbes de perte d’entraînement et de validation aident à distinguer sous‑apprentissage, surapprentissage, instabilité et fuite, mais n’établissent pas l’utilité en situation réelle. Utilisez des données d’évaluation indépendantes, des exécutions répétées lorsque la variance compte, des ablations et des comparaisons avec des références plus simples. Un grand nombre de paramètres augmente également le besoin de gouvernance des données, de planification du calcul et de configuration reproductible.
Déploiement sécurisé et efficace des modèles profonds
Le déploiement peut utiliser un point de terminaison hébergé, un accélérateur dédié, un navigateur, un téléphone ou un dispositif embarqué. L’exportation et la compilation peuvent fusionner des opérateurs, quantifier les poids et les activations, ou modifier le comportement numérique, il faut donc valider l’artifact déployé plutôt que seulement le point de contrôle d’entraînement. Mesurez le démarrage à froid, la latence stable, le débit, la mémoire, la consommation d’énergie et la qualité à des tailles de lot et de séquence réalistes. Les méthodes de compression — élagage, distillation, quantisation et adaptation à faible rang — échangent taille ou vitesse contre précision et complexité d’ingénierie et doivent être évaluées sur des classes sensibles et des cas limites.
Les modèles profonds peuvent échouer de manière confiante lors d’un changement de distribution, d’une entrée adversariale, d’une corrélation fallacieuse et de groupes mal représentés. Surveillez les distributions d’entrée et de sortie, les résultats des tâches, la calibration, l’utilisation des ressources et les versions des dépendances. Utilisez le contrôle d’accès, les artefacts signés, les données d’entraînement protégées, les tests de résistance (red teaming) et des limites de taux adaptées au modèle de menace. Les explications telles que les cartes de saillance ou les vues d’attention sont des preuves diagnostiques, pas une preuve de causalité. Combinez‑les avec des tests comportementaux, des contre‑factualités, une révision humaine, une réponse aux incidents et des limites explicites aux décisions automatisées.
Exemple pratique : entraînement d’un détecteur de défauts d’image
Une usine collecte des images de produits provenant de différentes caméras, changements, matériaux et classes de défauts connues, puis les sépare par lot de production afin que les éléments quasi‑identiques ne puissent pas traverser les partitions. Une petite référence convolutionnelle est comparée à un réseau profond pré‑entraîné. L’augmentation reproduit les variations de lumière et de point de vue validées sans effacer les défauts. L’évaluation rapporte le rappel par défaut, le taux de faux‑rejet, la calibration, la latence d’inférence et la robustesse au flou, aux reflets, au remplacement de caméra et aux couleurs de matériaux rares.
Le modèle exporté et le code exact de redimensionnement, de couleur et de normalisation sont testés sur le matériel de la chaîne pour un débit soutenu et un comportement thermique. Les cas à faible confiance sont confiés aux inspecteurs ; une règle indépendante arrête la chaîne en cas de défaillance critique du capteur. Les images ne sont conservées que si cela est autorisé et les artefacts du modèle sont signés. La surveillance relie les prédictions aux résultats d’inspection ultérieurs et aux lots de production. Une nouvelle caméra ou un nouveau matériau déclenche une réévaluation contrôlée plutôt qu’un apprentissage en ligne silencieux à partir d’étiquettes non révisées.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le changement de distribution, les pannes de dépendances, les mauvais usages, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, un apprentissage des incidents, des procédures de suppression et de conservation, et un point clair où il doit être désactivé ou remplacé.
Références principales