Fondamentaux de l’IA
Qu’est-ce que les RNN et les LSTM en apprentissage profond ?

 Ajouter Unite.AI à vos sources préférées sur Google
Réseaux de neurones récurrents (RNN) traitent les séquences en mettant à jour un état caché au fil du temps. Mémoire à long terme (LSTM) sont des RNN à portes conçus pour préserver et contrôler l’information plus efficacement qu’une unité récurrente basique.
Les RNN et les LSTM dominaient autrefois de nombreuses tâches linguistiques, mais les grands chatbots modernes sont principalement basés sur les transformers. Les modèles récurrents restent utiles pour le streaming, les séries temporelles, la parole, le contrôle et les systèmes à ressources limitées où l’état incrémental et la faible latence sont importants.
Points clés
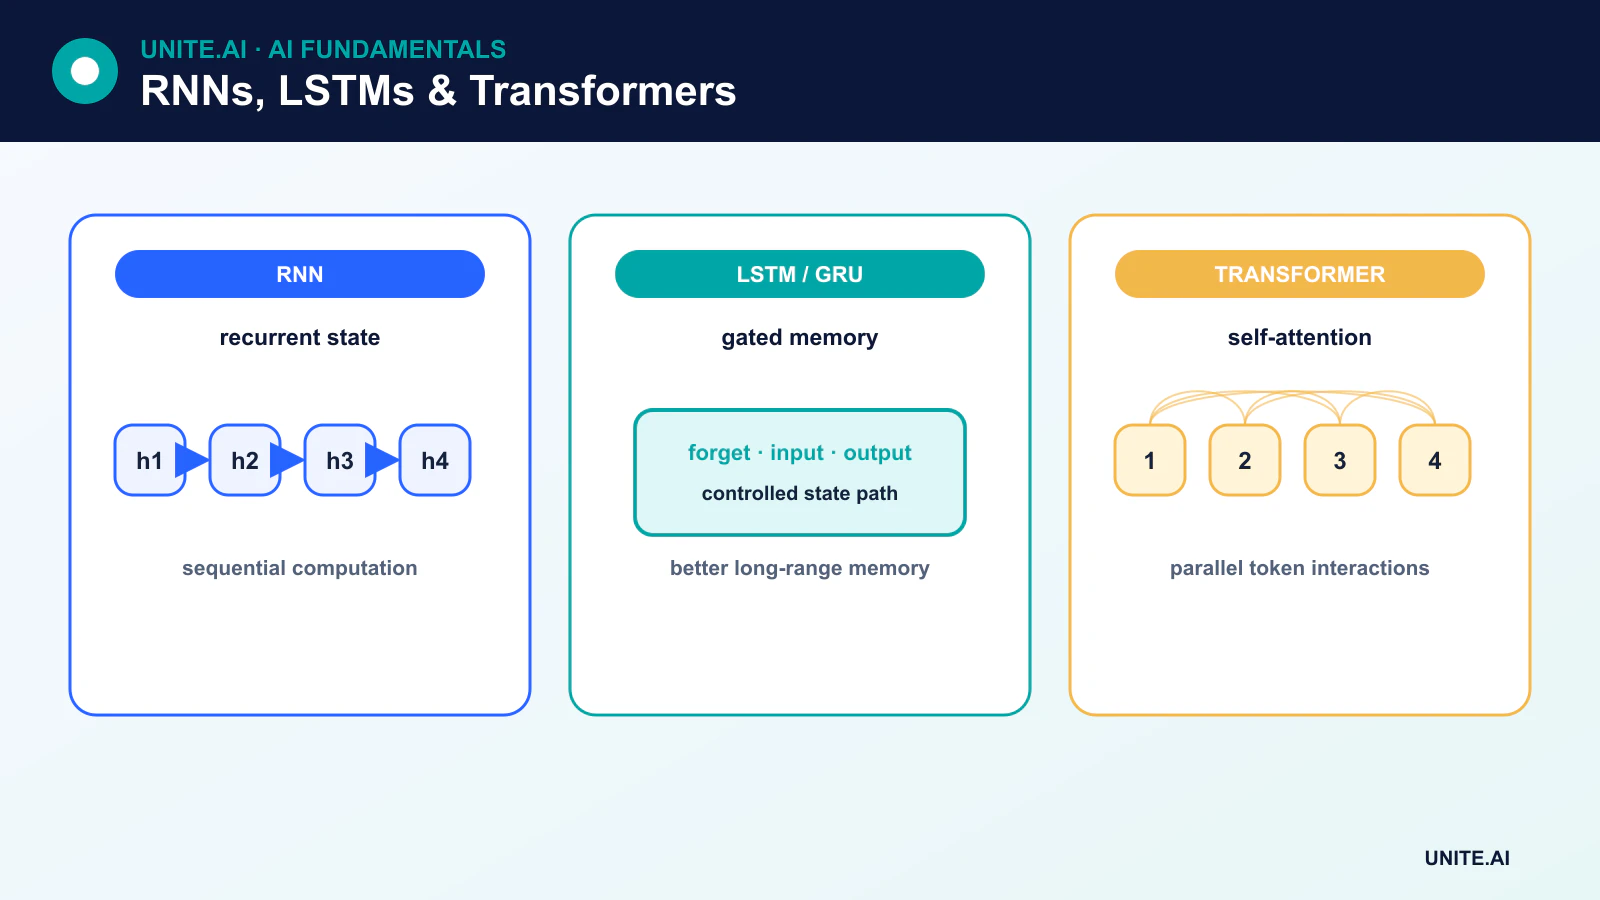
- Un RNN réutilise les mêmes paramètres à chaque pas de la séquence et transmet un état caché vers l’avant.
- L’entraînement dans le temps peut engendrer des gradients qui s’évanouissent ou explosent.
- Un LSTM ajoute un état de cellule ainsi que des portes d’entrée, d’oubli et de sortie.
- Les transformers gèrent les relations à longue portée et l’entraînement parallèle différemment ; aucune des deux architectures n’est la meilleure pour chaque déploiement.
Fonctionnement d’un RNN basique
À l’étape t, une unité récurrente simple combine l’entrée actuelle xₜ avec l’état caché précédent hₜ₋₁ :
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
L’état caché est un résumé appris utilisé pour l’étape suivante et, selon la tâche, comme sortie. Un diagramme « déroulé » représente une copie par pas de temps, mais toutes les copies partagent les mêmes paramètres. La sortie n’est pas simplement recopiée comme nouvelle entrée brute ; la récurrence transmet l’état caché à travers une transformation définie.
Rétropropagation à travers le temps
Les RNN sont entraînés avec la rétropropagation à travers le temps (BPTT). La séquence déroulée forme un graphe de calcul profond, et la rétropropagation calcule comment la perte dépend des paramètres récurrents partagés.
Une multiplication répétée peut faire diminuer les gradients vers zéro ou les faire croître indéfiniment. Les gradients qui s’évanouissent empêchent l’apprentissage de longues dépendances ; les gradients qui explosent entraînent des mises à jour instables. Le clipping des gradients résout les gradients explosifs, tandis que les portes, l’initialisation, la normalisation et des fenêtres d’entraînement plus courtes peuvent aider.
À l’intérieur d’une cellule LSTM
Un LSTM conserve un état de cellule cₜ en plus de l’état caché hₜ. Ses portes sont des contrôles appris, dépendants des données :
- La porte d’oubli contrôle la quantité d’état de cellule précédent conservée.
- La porte d’entrée contrôle la quantité d’information candidate écrite.
- La porte de sortie contrôle la quantité d’information de la cellule qui contribue à l’état caché.
Les sorties sigmoïdes entre zéro et un agissent comme des portes souples, tandis qu’un candidat transformé par tanh fournit du nouveau contenu. Le chemin additif de l’état de cellule aide les gradients à persister, mais les LSTM ne garantissent pas une mémoire illimitée ni n’éliminent tous les problèmes d’optimisation.
GRU et récurrence bidirectionnelle
Une unité récurrente à portes (GRU) regroupe les mécanismes de porte dans une cellule récurrente plus simple, sans état de cellule séparé de type LSTM. Les GRU peuvent s’entraîner plus rapidement et offrir des performances similaires sur certaines tâches.
Un RNN bidirectionnel traite une séquence complète dans les deux sens et combine les états. Il peut utiliser le contexte futur pour le balisage ou l’encodage, mais il n’est pas adapté au streaming causal lorsque les entrées futures ne sont pas encore disponibles.
Modèles séquence à séquence
Les RNN encodeur‑décodeur transforment une séquence en une autre. L’attention a été introduite pour permettre au décodeur de consulter différents états de l’encodeur au lieu de se fier à un vecteur fixe. Cette voie a conduit à l’architecture transformer, qui a remplacé la récurrence par des blocs basés sur l’attention.
RNN vs transformers
Les transformers traitent les positions d’entraînement en parallèle et créent de courts chemins d’attention entre des tokens distants. Les RNN traitent l’état séquentiellement, limitant le parallélisme mais offrant un état récurrent de taille constante pendant le streaming. L’inférence d’un transformer peut nécessiter un cache clé‑valeur croissant, tandis qu’un RNN compresse l’historique dans son état caché et peut perdre des détails.
Choisissez en fonction de la longueur de la séquence, de l’échelle des données, du matériel, de la latence, de la mémoire et du fait que la tâche soit hors ligne ou en streaming. Les architectures hybrides et à espace d’état offrent des compromis supplémentaires.
Cas d’utilisation actuels
Les RNN et les LSTM restent pertinents pour la prévision, la détection d’anomalies, le traitement de capteurs, les composants de parole, l’écriture manuscrite, le contrôle embarqué et la modélisation de séquences à faible latence. Ils ne constituent pas l’explication par défaut des grands modèles de langage actuels ou des chatbots IA.
Récurrence, portes et mémoire de séquence
Un réseau de neurones récurrent traite une séquence en combinant l’entrée actuelle avec un état caché provenant des étapes précédentes. Les poids partagés permettent des longueurs de séquence variables, et le déroulement expose le calcul dans le temps pour l’entraînement. Les RNN basiques peuvent représenter la dépendance temporelle mais les gradients multipliés de façon répétée sur de longues séquences ont tendance à s’évanouir ou à exploser. La rétropropagation tronquée limite la mémoire et le calcul, tandis que le clipping des gradients contrôle les mises à jour extrêmes. L’état caché est un résumé appris, pas un stockage fidèle de chaque token antérieur.
Les réseaux à mémoire long terme (LSTM) ajoutent un état de cellule ainsi que des portes d’entrée, d’oubli et de sortie qui régulent l’écriture, la conservation et l’exposition de l’information. Les unités récurrentes à portes utilisent une structure de réinitialisation et de mise à jour plus simple. Les variantes bidirectionnelles utilisent le contexte futur et ne peuvent donc pas diffuser de façon causale sans délai. Les modèles récurrents empilés, résiduels et augmentés d’attention augmentent la capacité. Le remplissage (padding) et les masques doivent empêcher les éléments de séquence artificiels d’influencer l’état ou la perte, et l’état doit être réinitialisé aux véritables limites de séquence pour éviter les fuites entre les exemples.
Entraînement, comparaison et service avec état
Les RNN et les LSTM restent utiles pour le streaming, les modèles compacts sur appareil, les séries temporelles et les charges de travail où l’état séquentiel est efficace. Les transformers parallélisent l’entraînement et modélisent les interactions à longue portée différemment mais peuvent nécessiter plus de mémoire et de cache. Comparez les architectures en fonction de la précision, de la latence, du débit, de la mémoire, de la consommation énergétique et des performances selon la longueur de la séquence. Évaluez la prévision avec des découpages temporels glissants, le langage avec des métriques sensibles à la séquence, et la détection d’anomalies avec des mesures au niveau des événements. Examinez les échecs après de longues interruptions, des changements de régime, des échantillons manquants et des limites de séquence abruptes.
Le déploiement avec état doit associer l’état caché à la session correcte, le faire expirer, le chiffrer si sensible, et le réinitialiser après des erreurs ou des changements de modèle. Les événements hors ordre ou dupliqués peuvent corrompre l’état ; incluez des horodatages, des numéros de séquence et l’idempotence. Surveillez l’âge de l’état, la longueur de la séquence, les données manquantes, la dérive de sortie et la latence. La quantification nécessite une validation sensible aux portes car de petites variations numériques peuvent s’accumuler avec le temps. La mémoire des RNN permet le contexte, mais elle peut aussi conserver des informations privées ou obsolètes, d’où la nécessité d’une rétention et de contrôles utilisateurs dans la conception.
Exemple pratique : un LSTM pour les séquences de capteurs en streaming
Une application utilise un LSTM pour prévoir la charge à court terme à partir de mesures récentes, du calendrier et de la météo. Les séquences sont construites avec un ordre temporel strict ; l’état caché est réinitialisé aux limites des alimentations, et le remplissage est masqué. Les bases de référence saisonnières naïves et les modèles boostés par gradient sont comparés au LSTM sur des fenêtres glissantes. Les tests couvrent les intervalles manquants, la météo retardée, les jours fériés, les pannes et des longueurs de séquence supérieures à l’entraînement habituel.
Le service de streaming associe l’état à une alimentation, rejette les duplicata hors ordre et fait expirer l’état après de longues interruptions ou des mises à jour du modèle. Une prévision statistique sûre remplace la sortie lorsque les capteurs ou l’état sont invalides. L’inférence quantifiée est vérifiée sur de longues séquences pour détecter la dérive accumulée. La surveillance suit l’âge de l’état, les données manquantes, la latence, le biais et l’erreur d’intervalle. Le modèle est réentraîné uniquement après des changements du réseau et les résultats revus montrent que les relations temporelles apprises ne se généralisent plus.
Preuves de mise en œuvre et disponibilité opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le responsable et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attractif.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les changements, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Questions fréquentes
Un LSTM est‑il toujours meilleur qu’un RNN basique ?
Non. Les portes aident à résoudre de nombreux problèmes de dépendances longues mais ajoutent du calcul et des paramètres. Un RNN basique peut être suffisant pour des séquences courtes et simples, et une autre architecture peut être préférable pour un contexte très long.
Un LSTM peut‑il traiter un historique illimité ?
Non. Son état a une capacité finie, les gradients et les données d’entraînement imposent des limites, et les détails pertinents peuvent être écrasés. La performance sur de longs contextes doit être mesurée plutôt que déduite du nom de l’architecture.
Références principales