Fondamentaux de l’IA
Qu’est‑ce que les CNN (réseaux de neurones convolutifs) ?

 Ajouter Unite.AI à vos sources préférées sur Google
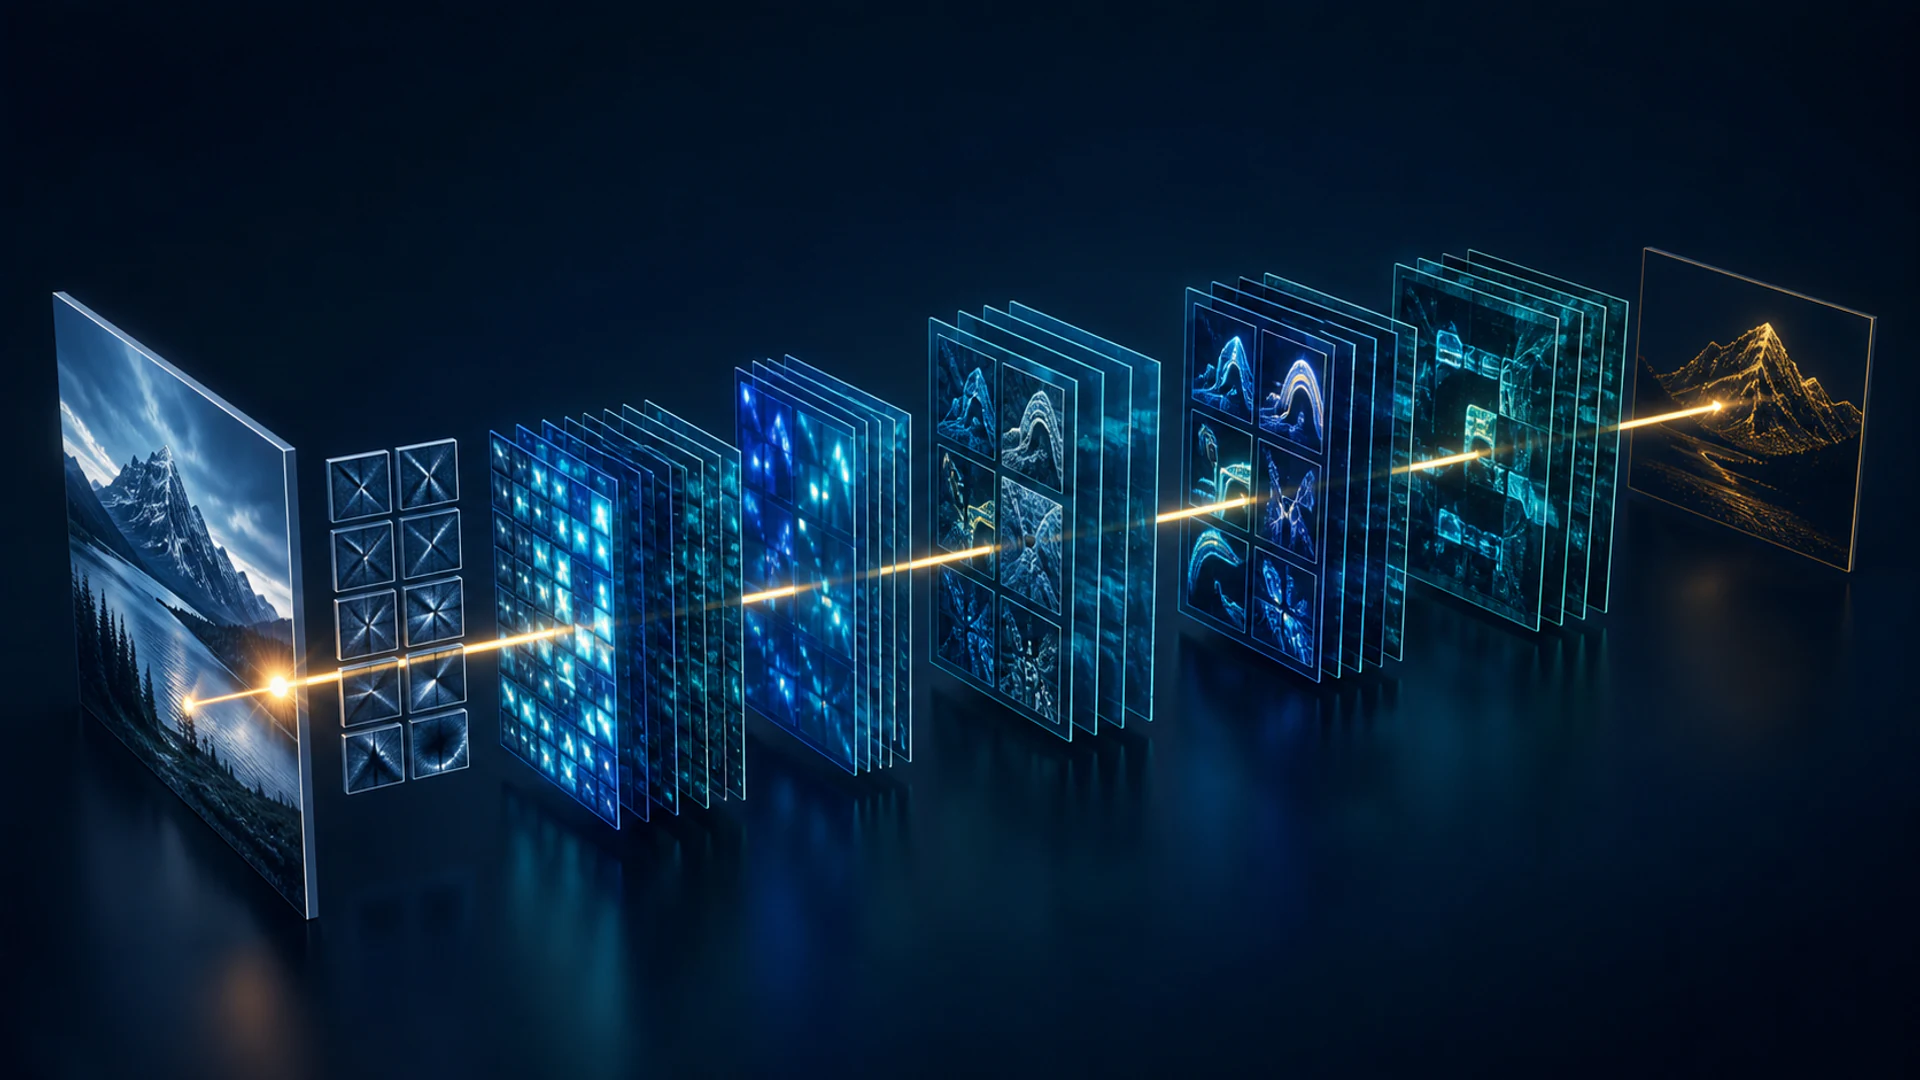
Un réseau de neurones convolutif (CNN) est une architecture de réseau de neurones qui utilise des filtres appris sur des régions locales d’une entrée. Les CNN sont devenus fondamentaux pour la vision par ordinateur parce qu’ils peuvent détecter des motifs quel que soit l’endroit où ils apparaissent et réutiliser les mêmes paramètres sur toute l’image.
Un CNN ne convertit pas une image d’une forme non numérique à une forme numérique — l’image arrive déjà sous forme d’un tenseur de valeurs de pixels. Son objectif est de transformer ce tenseur en cartes de caractéristiques utiles pour la classification, la détection, la segmentation ou toute autre tâche.
Points clés
- Une convolution combine des valeurs d’entrée locales avec un noyau appris pour produire une carte de caractéristiques.
- Le stride, le padding, la dilation et le pooling contrôlent la résolution spatiale et le champ réceptif.
- Le partage de poids rend les CNN plus efficaces en paramètres qu’un réseau entièrement connecté sur les pixels bruts.
- Les vision transformers offrent une alternative, mais les CNN restent performants pour les systèmes efficaces et limités en données.
Comment fonctionne la convolution
Un noyau est une petite grille de poids entraînables. À chaque position, le CNN multiplie les valeurs du noyau par les valeurs d’entrée correspondantes, en additionne les résultats, et ajoute généralement un biais. Répéter cela sur l’ensemble de l’entrée produit une carte de caractéristiques.
Pour une image couleur, un noyau couvre tous les canaux d’entrée. Une couche utilise plusieurs noyaux pour créer plusieurs canaux de sortie. Pendant l’entraînement, la rétropropagation calcule les gradients de ces poids de noyau ; l’opération de convolution ne fabrique pas un nouvel ensemble fixe de poids à partir de chaque image.
Stride, padding et dilation
- Stride contrôle la distance parcourue par le noyau. Un stride supérieur à un réduit la résolution spatiale.
- Padding ajoute des valeurs autour d’une entrée afin que les informations de bord puissent être traitées et que la taille de sortie puisse être contrôlée.
- Dilation espace les éléments du noyau, élargissant le champ réceptif sans augmenter proportionnellement les paramètres.
Le champ réceptif est la région de l’entrée originale qui peut influencer une unité. Empiler des convolutions l’élargit, permettant aux caractéristiques ultérieures de combiner des informations provenant de zones plus étendues.
Activation, normalisation et pooling
Les couches convolutives sont généralement suivies d’activations non linéaires et de normalisation. Le pooling résume les régions locales à l’aide d’une opération telle que le maximum ou la moyenne. Des convolutions à stride appris peuvent également sous‑échantillonner.
Le pooling n’est pas obligatoire. De nombreux réseaux modernes utilisent un pooling moyen global près de la sortie au lieu d’aplatir une grande carte de caractéristiques dans une pile entièrement connectée. Cela réduit le nombre de paramètres et permet au réseau d’agréger les preuves spatiales.
Une architecture CNN moderne
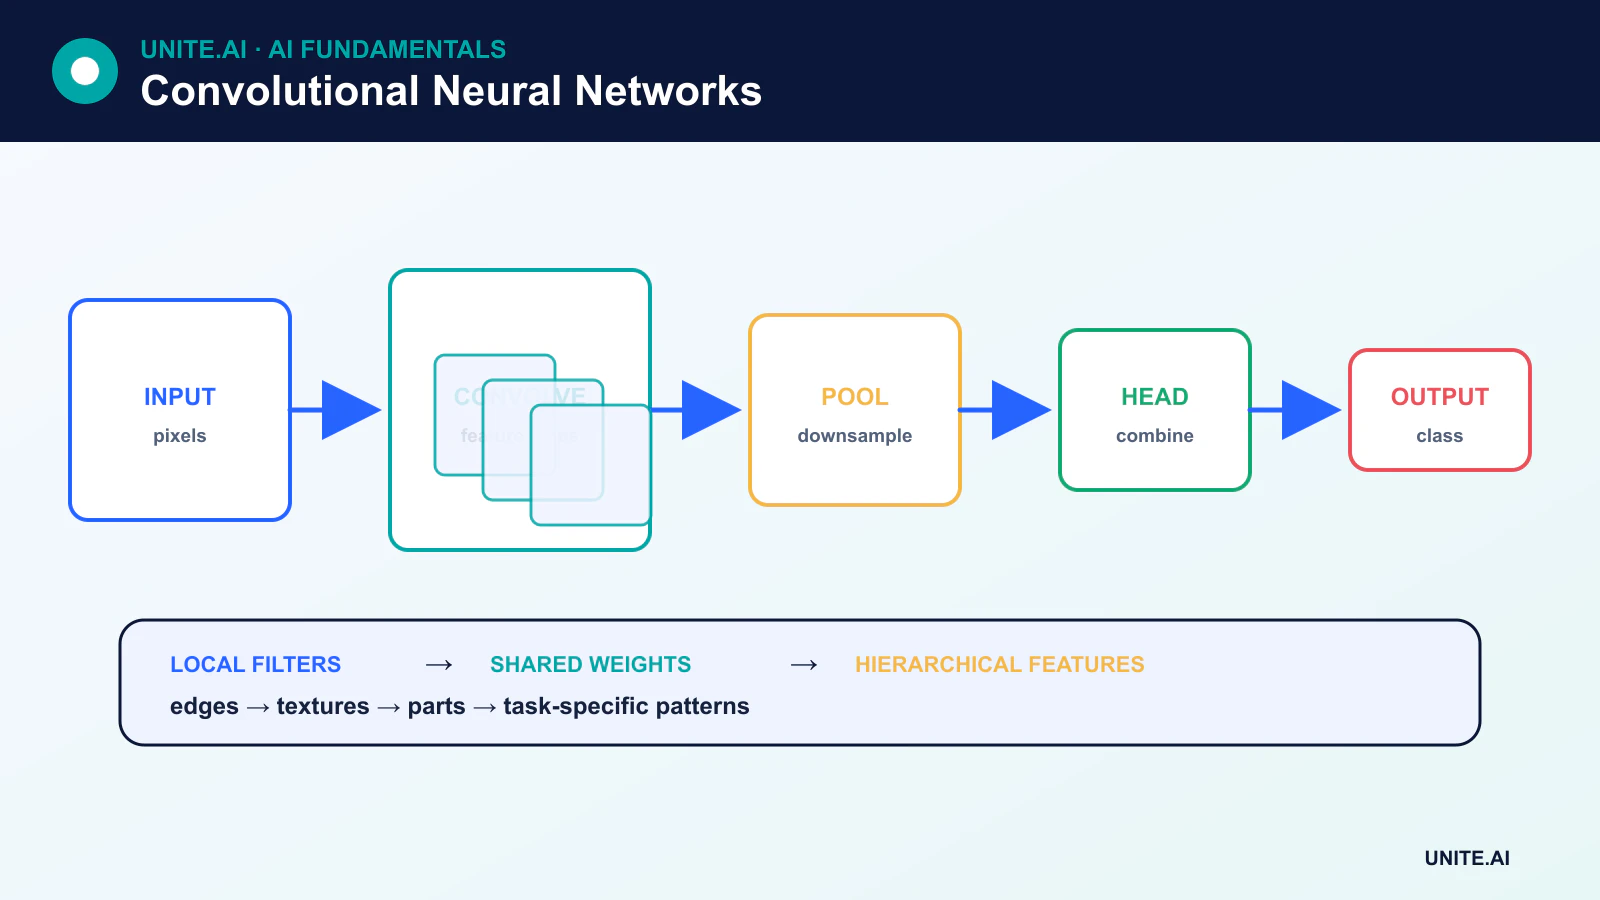
Un modèle de vision typique comprend une tige, une séquence de blocs de caractéristiques, des étapes de sous‑échantillonnage et une tête de tâche. Les connexions résiduelles permettent à un bloc d’apprendre une modification de son entrée et offrent une voie directe pour l’information et les gradients. Le succès des réseaux résiduels a rendu pratique l’entraînement de CNN beaucoup plus profonds.
Les têtes de classification produisent des scores de classe. Les têtes de détection prédisent des catégories et des boîtes. Les architectures de segmentation ajoutent des chemins de décodage qui récupèrent le détail spatial. Le même backbone CNN peut être réutilisé via l’apprentissage par transfert.
Ce que les couches CNN apprennent
Il est courant de visualiser les premiers filtres qui répondent aux bords ou aux textures et les représentations ultérieures qui corrèlent avec des parties ou des objets. C’est une intuition utile, mais ce n’est pas une règle fixe. Les caractéristiques dépendent de la tâche, de l’architecture, des données, de l’objectif et du processus d’entraînement, et certaines unités combinent des informations qui ne se traduisent pas clairement en concept humain.
CNN vs vision transformers
Les vision transformers découpent les images en patchs et utilisent l’attention pour modéliser les relations entre eux. Ils peuvent s’échelonner efficacement avec de grands ensembles de pré‑entraînement. Les CNN intègrent la localité et les hypothèses de translation directement dans l’architecture, ce qui peut les rendre plus efficaces et plus pertinents en données dans des contextes plus restreints.
De nombreux systèmes pratiques combinent convolution et attention. La bonne architecture dépend de la précision, de la latence, de la mémoire, des données d’entraînement, du matériel et du déploiement, et non de la nouveauté de la famille.
Limitations et considérations pratiques
Les CNN peuvent être sensibles aux changements de distribution, aux perturbations adversariales, aux raccourcis de fond et aux données d’entraînement biaisées. Ils ne sont pas parfaitement invariants à la position, à la rotation, à l’échelle ou au point de vue. L’augmentation et les choix d’architecture peuvent améliorer la robustesse mais ne la garantissent pas.
Pour le déploiement, mesurez la latence de bout en bout, la mémoire, le débit et le comportement par sous‑groupe. La quantification et l’élagage peuvent réduire le coût, notamment pour l’IA en périphérie, mais les modèles compressés doivent être revalidés.
Convolution, champs réceptifs et blocs CNN modernes
Une couche convolutionnelle fait glisser des noyaux appris sur une grille et partage les poids entre les positions. La taille du noyau, le stride, la dilation et le padding déterminent la forme de sortie et le champ réceptif. Les premières couches répondent souvent à des bords ou textures locaux ; les couches plus profondes combinent des informations sur de plus grandes régions, bien que les représentations apprises ne correspondent pas toujours clairement à des concepts humains. Le pooling ou la convolution à stride réduit la résolution spatiale. Les canaux transportent les cartes de caractéristiques, tandis que les convolutions groupées et séparables en profondeur échangent le mélange inter‑canaux contre un calcul moindre. Les connexions résiduelles facilitent l’optimisation de réseaux très profonds.
Pour une hauteur et une largeur d’entrée, le padding contrôle le traitement des bords et le stride contrôle l’échantillonnage. Un sous‑échantillonnage agressif peut effacer les petits objets ; le padding nul peut créer des artefacts de bord ; la dilation étend le contexte sans la même croissance de paramètres mais peut produire un effet de grille. La normalisation par lot dépend des statistiques d’entraînement, tandis que des alternatives peuvent mieux fonctionner avec de petites tailles de lot. Les architectures modernes combinent goulots d’étranglement, caractéristiques multi‑échelle, attention ou résidus inversés. Choisissez l’architecture en fonction de la résolution de la tâche, de la bande passante mémoire, de la latence et du matériel cible plutôt qu’en fonction de la seule précision de classification d’images.
Entraînement, interprétation et déploiement
Utilisez des augmentations qui préservent les étiquettes et reflètent les variations réelles, et séparez par sujet ou scène avant l’augmentation. L’apprentissage par transfert est courant : remplacez la tête de tâche, entraînez‑la, puis décongelez prudemment le backbone. Évaluez les performances par classe, la calibration, la robustesse au flou, à la compression, à l’éclairage, à l’échelle, au recadrage et aux perturbations adversariales. Les méthodes de visualisation comme les cartes de caractéristiques et la salience peuvent révéler des raccourcis, mais elles sont sensibles à la méthode et à la référence. Confirmez les dépendances suspectées avec des images contrefactuelles, des tests d’occlusion ou des changements de jeu de données.
Les CNN exportés peuvent être fusionnés, quantifiés ou compilés pour GPU, NPU, navigateur ou microcontrôleur. Validez le graphe déployé, y compris le pré‑traitement et le post‑traitement, sur les appareils exacts. Mesurez la latence de bout en bout, la mémoire, l’énergie et le comportement thermique ; le décodage d’entrée peut dominer un petit modèle. Surveillez les statistiques de la caméra et de l’image, la distribution des sorties et les erreurs confirmées. Les artefacts de modèle signé, les canaux de mise à jour protégés et la gestion élégante des pannes de capteur font partie de la conception de production. Les CNN codent un biais de localité utile, mais ils ne comprennent pas automatiquement les objets ou les scènes causales.
Exemple pratique : déploiement d’un CNN sur une caméra d’inspection
Un CNN classe les défauts de surface à partir d’images linéaires haute résolution. Les ingénieurs découpent les images avec chevauchement afin que les petits défauts survivent au sous‑échantillonnage, conservent les coordonnées pour la révision et valident les augmentations contre les variations optiques réelles. Un CNN résiduel et un modèle plus léger à profondeur séparée sont comparés à rappel égal. Les tests incluent les défauts de bord, les reflets, la compression, le mouvement, les lots de matériaux et les remplacements de caméra, avec des lots de production indépendants réservés à l’évaluation finale.
La compilation fusionne et quantifie le modèle pour un accélérateur en périphérie, mais le graphe déployé est comparé à la référence sur les cas de défauts sensibles. Le décodage, le découpage, l’inférence et la fusion de latence sont mesurés de bout en bout. Le système signale séparément les pixels morts et la dérive d’exposition des défauts du produit. Les opérateurs peuvent inspecter les tuiles sources et remplacer les résultats. Les changements de modèle et de caméra sont déployés progressivement, et la ligne conserve une procédure d’inspection manuelle sûre lorsque le pipeline de vision est indisponible.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendance, les usages abusifs et les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement à la calibration ou à l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attractif.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les changements, le retour en arrière et la retraite. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité d’entrée, le comportement de sortie, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une documentation de récupération, d’apprentissage d’incident, de procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Un CNN a-t-il toujours besoin de pooling ?
Non. Un CNN peut sous‑échantillonner avec une convolution à stride et peut préserver la résolution pour la prédiction dense. Le pooling est un outil de conception plutôt qu’une exigence définissante.
Les filtres CNN sont-ils conçus manuellement ?
Dans un CNN entraîné, les valeurs du noyau sont généralement apprises à partir des données. Cela diffère des filtres de vision classiques dont les coefficients sont choisis à l’avance pour des opérations telles que la détection de contours.
Références principales