Fondamentaux de l’IA
Qu’est‑ce que les réseaux neuronaux ?

 Ajouter Unite.AI à vos sources préférées sur Google
Un réseau neuronal artificiel est un modèle mathématique paramétré constitué de couches d’opérations connectées. Au cours de l’entraînement, le réseau ajuste ses paramètres afin que les entrées soient transformées en sorties utiles. Les réseaux neuronaux peuvent approximer des relations non linéaires complexes et apprendre des représentations directement à partir de textes, d’images, d’audios, de séries temporelles et d’autres données.
Le nom s’inspire historiquement des neurones biologiques, mais les réseaux modernes sont des systèmes d’ingénierie plutôt que des simulations réalistes du cerveau. Des termes comme « neurone » et « apprentissage » sont des raccourcis utiles et ne doivent pas être confondus avec une preuve de cognition semblable à celle de l’homme.
Points clés
- Un neurone calcule une somme pondérée, ajoute un biais entraînable et applique une fonction d’activation.
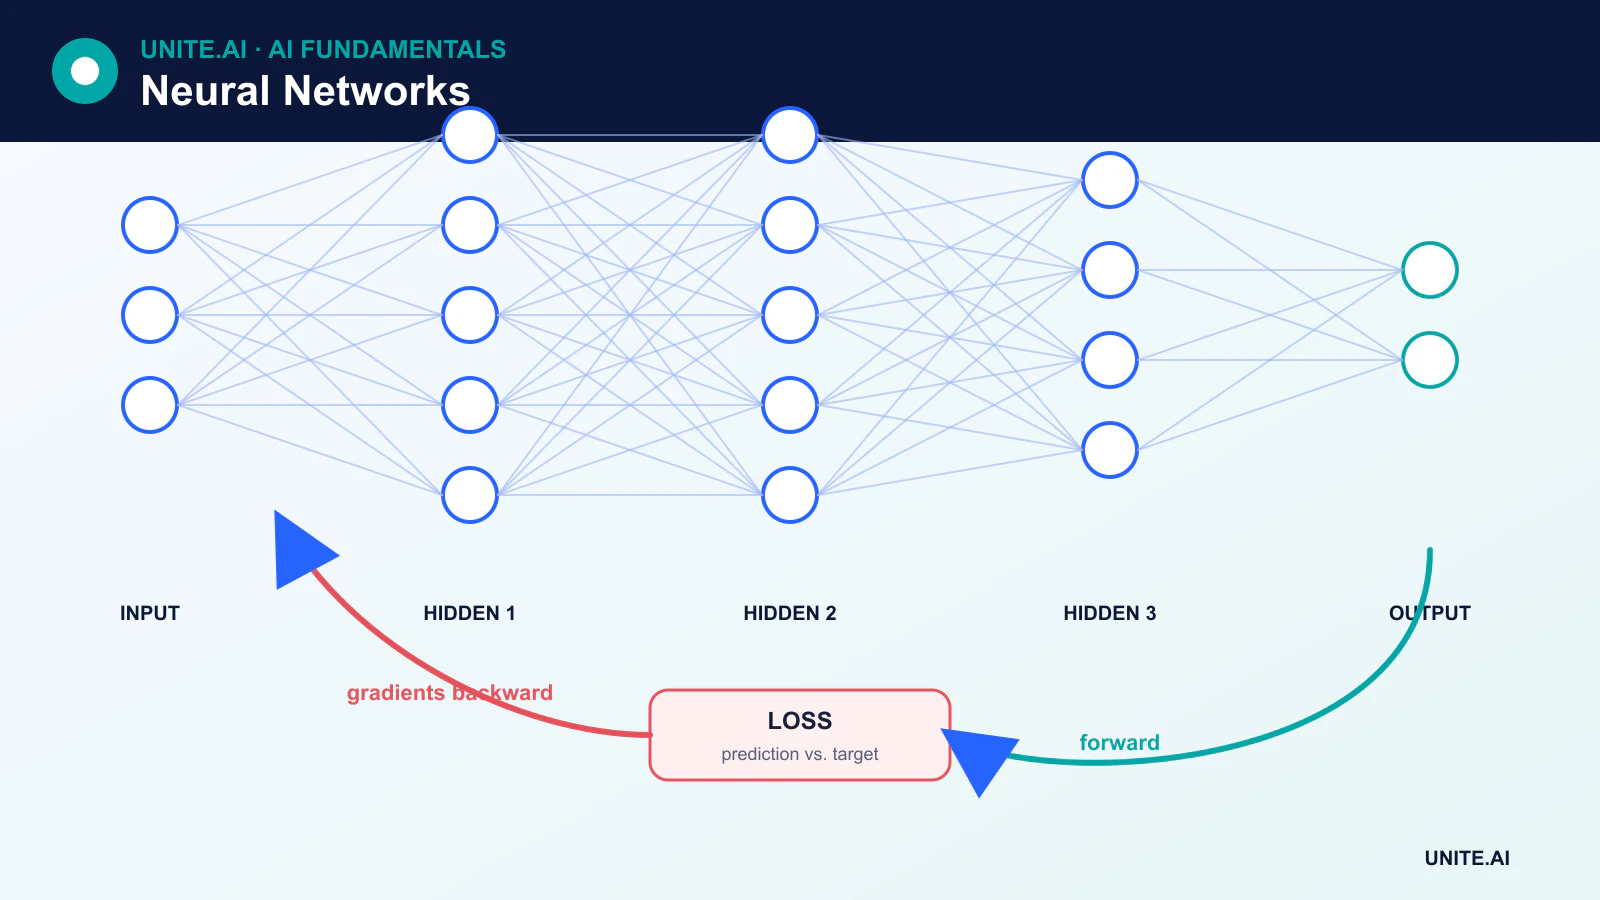
- Un passage avant génère des prédictions ; une fonction de perte mesure l’erreur ; la rétropropagation calcule les gradients ; un optimiseur met à jour les paramètres.
- Les MLP, CNN, RNN et transformeurs organisent les connexions différemment.
- Plus de couches ou de paramètres ne garantissent pas automatiquement un modèle meilleur ou plus fiable.
D’un neurone artificiel unique à un réseau
Pour un vecteur d’entrée x, une unité de base calcule:
z = Wx + boutput = activation(z)
W contient des poids entraînables et b est un biais entraînable. La fonction d’activation introduit la non‑linéarité. Les poids ne « passent pas à travers » l’activation par eux‑mêmes ; l’activation est appliquée à la somme pondérée et au biais.
Un perceptron multicouche (MLP) empile des couches denses. La couche d’entrée représente les caractéristiques, les couches cachées les transforment, et la couche de sortie est conçue pour la tâche — par exemple, des logits de classe ou une valeur de régression.
Comment les réseaux neuronaux apprennent
- Le modèle initialise les paramètres entraînables.
- Un passage avant traite un lot et produit des prédictions.
- Une fonction de perte compare les prédictions à l’objectif d’entraînement.
- Rétropropagation utilise la règle de chaîne pour calculer les gradients.
- Un optimiseur tel que la descente de gradient stochastique ou AdamW met à jour les poids et les biais.
La rétropropagation est devenue centrale dans l’entraînement des réseaux neuronaux grâce à des travaux développés et popularisés sur plusieurs décennies ; elle n’a pas été créée à l’origine à l’ère récente du deep learning. Les cadres modernes implémentent la différenciation automatique en mode inverse afin que les praticiens n’aient pas à dériver manuellement chaque gradient.
Pourquoi les fonctions d’activation sont importantes
Sans activations non linéaires, plusieurs couches linéaires ordinaires se réduisent à une seule transformation linéaire. ReLU est largement utilisé car il est simple et efficace. GELU et SiLU sont courants dans les architectures modernes. Sigmoid et softmax restent utiles pour certaines interprétations de sortie, mais la fonction sigmoïde peut se saturer dans les couches cachées et contribuer à la disparition des gradients.
Principales architectures de réseaux neuronaux
Réseaux neuronaux convolutionnels
CNN appliquent des filtres appris sur des voisinages locaux et partagent les paramètres entre les positions. Ces propriétés les rendent efficaces pour les images et d’autres signaux en forme de grille.
Réseaux récurrents
RNN, LSTM et GRU mettent à jour un état caché au fil d’une séquence. Ils restent utiles pour le streaming et les tâches de séries temporelles, bien que la récurrence limite le traitement parallèle et puisse rencontrer des difficultés avec de longues dépendances.
Transformeurs
Transformeurs utilisent l’attention pour créer des représentations dépendantes du contexte. Les connexions résiduelles, la normalisation, l’information de position et les blocs feed‑forward sont des éléments essentiels de l’architecture. Les transformeurs sous-tendent aujourd’hui de nombreux grands modèles de langage et multimodaux.
Auto‑encodeurs et réseaux génératifs
Auto‑encodeurs apprennent des représentations par reconstruction. Les GAN, les modèles de diffusion et les réseaux autorégressifs génèrent de nouveaux échantillons en utilisant des objectifs et des procédures d’entraînement différents.
Composants qui rendent les réseaux profonds entraînables
Les systèmes modernes utilisent plus que des couches et des activations. Les connexions résiduelles permettent aux informations et aux gradients de contourner les blocs. La normalisation stabilise les activations. La régularisation, l’augmentation de données, le dropout et la décroissance du poids peuvent réduire le surapprentissage. Les couches d’embedding transforment des éléments discrets tels que les tokens en vecteurs. L’attention permet à une représentation de dépendre dynamiquement d’autres éléments.
Points forts et limites
Les réseaux neuronaux peuvent apprendre des caractéristiques à partir de données brutes à haute dimension et s’adaptent à l’augmentation des données et de la puissance de calcul. Ils peuvent toutefois nécessiter de grands ensembles de données, du matériel spécialisé et un réglage minutieux. Leurs prédictions peuvent être mal calibrées, fragiles face à un changement de distribution, vulnérables à des manipulations adversariales ou difficiles à expliquer.
L’architecture doit suivre la tâche et les contraintes de déploiement. Pour de nombreux problèmes tabulaires, un ensemble d’arbres ou un modèle linéaire peut être plus rapide et plus facile à valider. Pour les applications à enjeux élevés, la performance du modèle doit être évaluée par sous‑groupe et mode de défaillance, pas uniquement par un benchmark agrégé.
Couches, activations et flux d’information
Un réseau neuronal compose des fonctions paramétrées. Chaque unité forme une combinaison pondérée des entrées, ajoute un biais et transmet le résultat à travers une activation telle que ReLU, sigmoïde, tanh ou GELU. Empiler les couches permet d’obtenir des caractéristiques hiérarchiques et des frontières de décision non linéaires. La largeur contrôle le nombre d’unités par couche ; la profondeur contrôle les transformations successives ; la connectivité et le partage de poids définissent l’architecture. La sortie du réseau dépend conjointement du pré‑traitement, des paramètres, de la normalisation et du mode d’inférence. Un neurone est une opération mathématique, pas un neurone biologique littéral ni un concept autonome signifiant.
La propagation avant calcule les prédictions ; une fonction de perte quantifie l’erreur ; la rétropropagation applique la règle de chaîne aux gradients ; un optimiseur met à jour les paramètres. L’initialisation, le taux d’apprentissage, les statistiques de lot, les chemins résiduels et la normalisation influencent la disparition, l’explosion ou l’utilité des gradients. La régularisation comprend la décroissance du poids, le dropout, l’augmentation, l’arrêt précoce et les contraintes architecturales. Tracez le comportement d’entraînement et de validation, inspectez les statistiques de gradients et d’activations, et comparez les exécutions répétées. Un grand réseau peut mémoriser les données d’entraînement, tandis qu’un petit peut sous‑ajuster ou manquer de structure nécessaire.
Sélection, évaluation et déploiement d’architecture
Les perceptrons multicouches traitent des vecteurs fixes ; les réseaux convolutionnels exploitent la structure locale ; les modèles récurrents et à espace d’état traitent les séquences ; les transformeurs utilisent l’attention ; les réseaux de graphes échangent des informations le long des arêtes. Les hybrides sont courants. Choisissez en fonction du biais inductif, des données, de la taille de la séquence ou de l’image, de la latence, de la mémoire, de l’interprétabilité et du matériel disponible. Évaluez par rapport à une référence linéaire ou arborescente et effectuez des ablations pour identifier la complexité pertinente. Le nombre de paramètres à lui seul ne prédit pas la qualité, le coût d’inférence ou les exigences de données.
La mise en service nécessite un pré‑traitement figé, un graphe exporté ou compilé, une validation numérique et des tests de ressources sous charge réaliste. La quantification et l’élagage peuvent réduire la taille mais peuvent modifier le comportement des classes rares. Surveillez les entrées, les sorties, la calibration, la latence et les résultats confirmés ; testez les données adversariales et décalées. Protégez les modèles, les dépendances et les données via des artefacts signés, le contrôle d’accès et la revue de la chaîne d’approvisionnement. Les explications provenant d’activations individuelles ou de la saillance nécessitent une vérification causale et comportementale. Les réseaux neuronaux sont des approximateurs de fonctions flexibles, pas des garanties de compréhension, de vérité ou de robustesse.
Exemple pratique : un prévisionneur de demande neuronal
Un détaillant prédit la demande hebdomadaire d’un article à partir des ventes, des promotions, du prix, des jours fériés, de la disponibilité et de la météo. Le réseau est comparé à des références saisonnières naïves, linéaires et d’arbres en utilisant des découpages temporels glissants. Les promotions futures ne sont incluses que lorsqu’elles sont réellement connues au moment de la prévision, tandis que les ruptures de stock sont modélisées car les ventes observées peuvent sous‑estimer la demande. L’évaluation utilise l’erreur absolue pondérée, le biais, la couverture d’intervalle et les résultats par vitesse d’article et magasin.
Le pipeline de mise en service versionne la disponibilité des fonctionnalités, le modèle et l’horizon et refuse une prévision lorsque les entrées requises sont obsolètes. Les planificateurs voient les intervalles et peuvent les remplacer avec des raisons enregistrées. La surveillance détecte les flux manquants, les variations d’erreur, le biais et les prévisions inhabituelles ; les résultats commerciaux sont séparés de la précision des prévisions car la politique de commande influence également les stocks. Une mise à jour du modèle est mise en shadow pendant plusieurs cycles, et le prévisionneur précédent reste disponible pour un retour en arrière lors d’une perturbation saisonnière ou fournisseur.
Preuves d’implémentation et état de préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une ligne de base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le changement de distribution, les pannes de dépendances, les mauvais usages, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer la preuve d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Est‑ce que chaque réseau neuronal est du deep learning ?
Non. Un petit réseau avec une couche cachée est un réseau neuronal, tandis que le deep learning désigne généralement des architectures comportant plusieurs étapes de traitement apprises. La frontière est conventionnelle plutôt qu’un seuil scientifique strict.
Les réseaux neuronaux stockent‑ils leurs données d’entraînement ?
Ils conservent les paramètres appris, et non une copie ordinaire et consultable du jeu de données. Néanmoins, les grands modèles peuvent mémoriser et reproduire des exemples d’entraînement individuels, ce qui engendre des risques de confidentialité et de droits d’auteur qui doivent être testés.
Références principales