
Fondamentaux de l’IA
Qu’est‑ce qu’un réseau antagoniste génératif (GAN) ?

 Ajouter Unite.AI à vos sources préférées sur Google
Un réseau antagoniste génératif (GAN) entraîne deux réseaux de neurones en compétition. Un générateur transforme une entrée aléatoire ou conditionnée en échantillons synthétiques. Un discriminateur tente de distinguer les échantillons générés des exemples d’entraînement réels. Le retour d’information de chaque réseau modifie le problème d’apprentissage de l’autre.
Les GAN peuvent créer des images nettes et des données synthétiques contrôlables, mais l’entraînement antagoniste est difficile à stabiliser. Le réalisme visuel ne constitue pas une preuve de diversité, de validité factuelle ou d’autorisation d’utiliser les données d’entraînement.
Points clés
- Le générateur produit des échantillons ; le discriminateur apprend un signal de décision réel‑vs‑généré.
- L’entraînement recherche un équilibre, mais le changement d’adversaires peut entraîner instabilité, oscillation ou effondrement de mode.
- Les GAN conditionnels contrôlent la génération à l’aide d’étiquettes, de texte ou d’autres contextes.
- L’évaluation doit tester la fidélité, la couverture, la mémorisation et les risques en aval — pas seulement la qualité d’image.
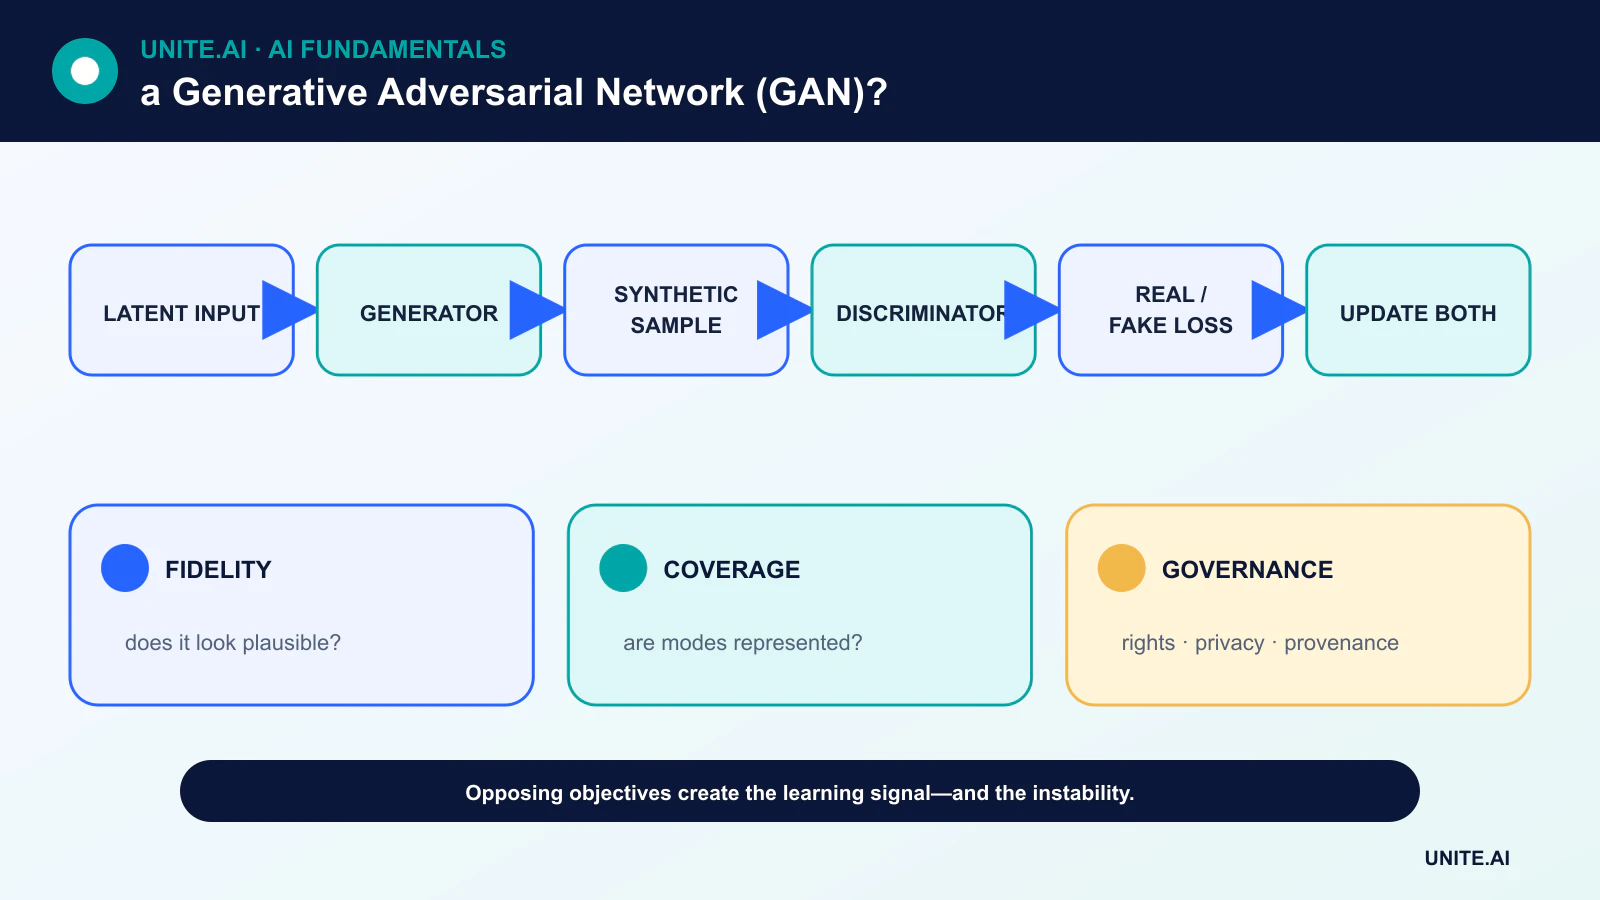
Le jeu antagoniste
La formulation originale est un jeu à deux joueurs en minimax. Le discriminateur s’améliore à séparer les données réelles des données générées, tandis que le générateur s’améliore à produire des échantillons que le discriminateur classe comme réels. Les deux sont entraînés par backpropagation.
Si le discriminateur devient trop précis, son retour d’information au générateur peut être inutile. S’il est trop faible, le générateur peut exploiter des raccourcis faciles. L’entraînement alterne donc les mises à jour et équilibre soigneusement la capacité, les pertes et les paramètres d’optimisation.
Effondrement de mode et stabilité de l’entraînement
L’effondrement de mode survient lorsque de nombreuses entrées latentes produisent des sorties similaires, de sorte que les échantillons semblent plausibles mais ne couvrent qu’une partie de la distribution des données. D’autres échecs incluent l’oscillation, les gradients explosifs et la sensibilité à l’initialisation aléatoire.
Les objectifs de Wasserstein, les pénalités de gradient, la normalisation spectrale, les changements d’architecture et les ratios de mise à jour ajustés peuvent améliorer la stabilité. Ils ne suppriment pas la nécessité d’inspecter la diversité et de répéter les expériences avec plusieurs graines.
Génération conditionnelle et contrôle latent
Un GAN conditionnel fournit au générateur et au discriminateur une étiquette ou un autre contexte, permettant de cibler des classes ou des attributs spécifiques. Les architectures basées sur le style séparent les aspects du contrôle latent à différentes résolutions et ont produit des images très réalistes.
Les directions latentes peuvent être corrélées à des concepts humains, mais la modification d’un attribut peut en changer d’autres parce que les données d’entraînement contiennent des caractéristiques corrélées. Les affirmations de contrôlabilité doivent être testées sur des identités et des contextes divers.
Évaluation, confidentialité et provenance
Des métriques comme le Fréchet Inception Distance comparent les distributions de caractéristiques, mais elles héritent des hypothèses du modèle de caractéristiques et peuvent manquer la mémorisation ou les échecs de sous‑groupes. L’analyse des plus proches voisins, les tests de couverture de type précision/rappel et la révision humaine fournissent des preuves complémentaires.
Un GAN peut mémoriser des exemples rares, reproduire des biais ou générer des médias trompeurs. Les équipes doivent documenter les ensembles de données, les droits, le filtrage, les filigranes ou les mécanismes de provenance ainsi que les contrôles d’abus. Les données synthétiques ne sont pas automatiquement anonymes.
GAN, VAE et modèles de diffusion
Variational autoencoders optimisent un objectif latent basé sur la vraisemblance et sacrifient souvent la netteté des échantillons au profit d’un espace latent structuré. Les modèles de diffusion apprennent à inverser un processus de bruitage et sont devenus une base courante pour la génération d’images.
Les GAN restent utiles lorsque l’échantillonnage rapide en un passage, les correspondances image‑à‑image spécifiques ou le déploiement compact sont importants. La méthode appropriée dépend de la qualité, de la diversité, de la latence, de la stabilité de l’entraînement et de la gouvernance — et non de la nouveauté de l’architecture.
Objectifs antagonistes et dynamique d’entraînement
Un réseau antagoniste génératif entraîne un générateur à produire des échantillons et un discriminateur à distinguer les données générées des données réelles. Dans le jeu minimax original, le discriminateur estime un signal lié au rapport de densité et le générateur tente de le tromper. L’entraînement alterne les mises à jour, de sorte que chaque réseau apprend face à un adversaire en mouvement plutôt qu’à une perte fixe. Si le discriminateur devient trop fort, les gradients du générateur peuvent devenir inutiles ; s’il est trop faible, la qualité des échantillons générés stagne. La valeur de perte à elle seule ne correspond pas directement à la qualité des échantillons.
L’effondrement de mode survient lorsque le générateur produit des variétés limitées qui trompent le discriminateur. L’oscillation, la sensibilité aux hyperparamètres et la normalisation instable sont également courantes. Les objectifs de Wasserstein, les pénalités de gradient, la normalisation spectrale, le rapprochement de caractéristiques, les statistiques de mini‑batch et des calendriers de mise à jour soigneusement équilibrés traitent différents mécanismes d’échec. Les GAN conditionnels utilisent des étiquettes, du texte ou des images pour guider la sortie ; les architectures basées sur le style séparent les influences latentes. La qualité et la couverture du jeu de données restent fondamentales car le générateur reproduit et recombine la distribution qu’il voit.
Évaluation et usage responsable
Évaluez séparément la fidélité et la diversité. Le Fréchet Inception Distance compare les distributions de caractéristiques mais dépend de la taille de l’échantillon, du modèle de caractéristiques, du pré‑traitement et du domaine ; le Inception Score omet la comparaison avec les données réelles. La précision et le rappel pour les modèles génératifs, l’analyse des plus proches voisins, les vérifications de mémorisation et l’évaluation humaine des tâches apportent des preuves supplémentaires. Pour la synthèse scientifique ou médicale, utilisez des métriques de domaine et une validation en aval. Conservez un jeu réel de validation et comparez‑le avec des références de diffusion ou d’auto‑régresseurs à puissance de calcul et résolution équivalentes.
Les GAN peuvent augmenter les données, traduire des domaines, super‑résoudre des images, synthétiser des médias et soutenir la simulation, mais les données synthétiques peuvent amplifier les biais ou divulguer des exemples d’entraînement. Vérifiez les licences, le consentement, l’identité et la provenance. Protégez‑vous contre l’usurpation non consentie et l’usage trompeur, étiquetez ou signez les sorties le cas échéant, et conservez les métadonnées de génération. Une image photoréaliste n’est pas une preuve documentaire ; l’incertitude et l’origine synthétique doivent rester visibles lorsque les sorties influencent des décisions.
Déploiement et reproductibilité
Enregistrez le générateur, le discriminateur, l’optimiseur, le jeu de données, la graine aléatoire, le facteur de troncature et les paramètres d’échantillonnage. La quantification ou l’exportation peuvent modifier la normalisation et la sortie, il faut donc valider l’artifact de service. Surveillez la distribution des invites ou des conditions, les filtres de sécurité, la diversité des sorties, la latence et les rapports. Utilisez des limites de débit et des protections d’identité dans les systèmes publics. L’entraînement d’un GAN est une expérience d’optimisation couplée : les images de démonstration sélectionnées ne peuvent établir la robustesse, la couverture ou l’absence de mémorisation, et un modèle doit être évalué sur l’ensemble complet de la distribution des tâches de génération prévues.
Exemple pratique : images de défaut synthétiques avec un GAN
Un fabricant entraîne un GAN conditionnel pour créer des images rares de défauts de surface. Il vérifie que les images d’entraînement sont autorisées et sépare les lots de production avant l’entraînement et l’évaluation. Les échantillons générés sont contrôlés pour la mémorisation des plus proches voisins, la géométrie des défauts, les artefacts de fond, la diversité et la plausibilité par des experts. Un classificateur entraîné avec une augmentation synthétique est évalué uniquement sur des défauts réels indépendants, comparé au même classificateur avec une augmentation conventionnelle.
Les données synthétiques ne sont acceptées que si le rappel en conditions réelles s’améliore sans augmenter les rejets erronés ou les erreurs de sous‑groupes. Les paramètres de génération et la provenance restent attachés à chaque image, et les fichiers synthétiques n’entrent jamais dans le jeu de test ou les archives de preuves comme des inspections réelles. Les opérateurs ne peuvent pas utiliser le générateur pour falsifier des dossiers d’audit. L’équipe compare les alternatives de diffusion et le coût de la collecte de davantage d’exemples réels, en reconnaissant que l’apparence réaliste ne prouve pas que le GAN a capturé le processus de défaillance physique.
Preuves d’implémentation et état de préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un ensemble d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Un GAN comprend‑il les images qu’il crée ?
Un GAN apprend une structure statistique utile à la génération. Cela ne constitue pas, à lui seul, une compréhension sémantique ou causale semblable à celle d’un humain.
Les échantillons générés par un GAN sont‑ils sûrs à utiliser comme données d’entraînement ?
Seulement après avoir vérifié la couverture, la validité des étiquettes, la mémorisation, les biais et si la distribution synthétique aide sur un jeu de test réel réservé.
Références principales












