
Fondamentaux de l’IA
Qu’est‑ce qu’un autoencodeur ?

 Ajouter Unite.AI à vos sources préférées sur Google
Un autoencoder est un réseau de neurones entraîné à reconstruire son entrée. Un encodeur transforme l’entrée en une représentation latente ; un décodeur reconstruit à partir de cette représentation. L’entraînement minimise une perte de reconstruction, parfois avec des contraintes supplémentaires.
Copier parfaitement l’entrée n’est pas automatiquement utile. L’architecture ou l’objectif doit créer un goulot d’étranglement, ajouter du bruit, imposer de la parcimonie ou empêcher autrement un mappage identité trivial afin que le code latent capture une structure utile.
Points clés
- L’encodeur compresse ou transforme une entrée ; le décodeur la reconstruit à partir d’un code latent.
- Un goulot d’étranglement sous‑complet, du bruit ou une régularisation incitent le modèle à apprendre la structure plutôt qu’à copier.
- L’erreur de reconstruction peut aider à la détection d’anomalies, mais les anomalies ne garantissent pas une erreur élevée.
- Les autoencodeurs variationnels apprennent un modèle latent probabiliste et diffèrent des autoencodeurs déterministes.
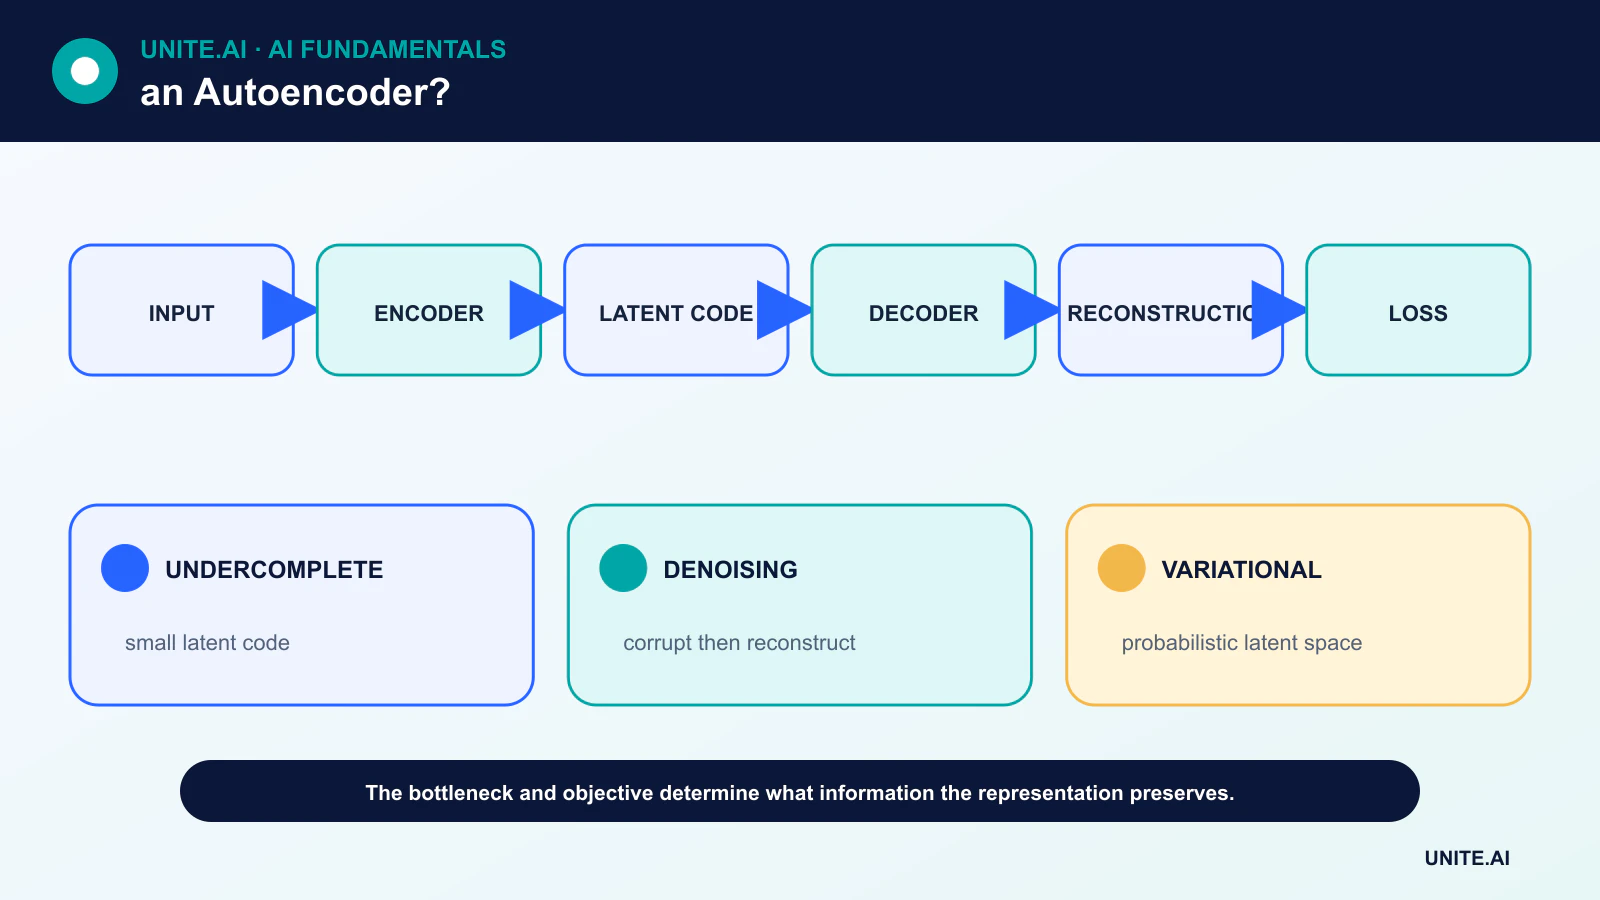
Encodeur, espace latent et décodeur
Pour une entrée x, l’encodeur produit le code latent z = f(x) et le décodeur produit la reconstruction x̂ = g(z). La perte compare x et x̂, par exemple avec l’erreur quadratique moyenne pour des valeurs continues ou une vraisemblance adaptée aux données.
La dimension latente peut être plus petite que l’entrée, créant ainsi un autoencodeur sous‑complet. Un réseau profond peut également apprendre des représentations non linéaires, étendant l’idée de la réduction de dimensionnalité.
Variantes courantes d’autoencodeur
Un autoencodeur parcimonieux pénalise une activation généralisée. Un autoencodeur de débruitage reçoit une entrée corrompue et reconstruit la version propre. Un autoencodeur contractif pénalise la sensibilité du code aux petites variations de l’entrée.
Un autoencodeur variationnel (VAE) encode les paramètres d’une distribution de probabilité, échantillonne une valeur latente et équilibre la reconstruction avec un terme de régularisation qui façonne l’espace latent. Cela permet l’échantillonnage mais modifie l’objectif et l’interprétation.
Entraînement et évitement des solutions triviales
Les autoencodeurs utilisent la rétropropagation comme les autres réseaux de neurones. Un réseau avec une capacité excessive peut mémoriser les exemples d’entraînement ou apprendre une fonction proche de l’identité. La taille du goulot d’étranglement, la corruption, les pénalités et la validation sur des données non vues le contraignent.
Le choix de la perte est important. Une perte pixel‑par‑pixel peut produire des reconstructions d’images floues, tandis que les pertes perceptuelles héritent des hypothèses d’un autre réseau. La meilleure métrique de reconstruction n’est pas forcément la meilleure mesure de similarité sémantique.
Utilisations et limites
Les autoencodeurs peuvent apprendre des caractéristiques, débruiter des signaux, compresser des données, initialiser des modèles et produire des variables latentes pour la visualisation. Pour la détection d’anomalies, un modèle entraîné sur des données normales peut attribuer une erreur de reconstruction plus élevée aux entrées inhabituelles.
Cette approche peut échouer lorsque l’autoencodeur reconstruit également bien les anomalies ou lorsque des variations bénignes sont plus difficiles à reconstruire que l’anomalie cible. Les seuils nécessitent des données de validation étiquetées ou soigneusement examinées, et l’erreur doit être surveillée par sous‑groupe et condition de fonctionnement.
Autoencodeurs versus d’autres modèles génératifs
Un autoencodeur déterministe n’est pas automatiquement un modèle génératif probabiliste. Les VAE définissent une distribution latente structurée ; les GANs entraînent un générateur contre un discriminateur ; les modèles de diffusion apprennent un processus de débruitage.
Le choix dépend de l’objectif : reconstruction, représentation, vraisemblance, fidélité des échantillons, contrôlabilité ou notation d’anomalies. Un modèle plus petit et spécifique à la tâche est souvent plus pratique qu’un grand générateur d’images.
Objectifs encodeur–décodeur et représentations latentes
Un autoencodeur apprend un encodeur qui mappe l’entrée x vers un code latent z et un décodeur qui reconstruit x à partir de z. Si la capacité est illimitée, il peut apprendre un mappage identité avec peu de structure utile. Les goulots d’étranglement, la régularisation, la corruption, la parcimonie ou les contraintes architecturales imposent une représentation qui préserve les informations sélectionnées. La perte de reconstruction définit ce qui est considéré comme similaire: l’erreur quadratique moyenne privilégie la fidélité moyenne des pixels, tandis que les pertes perceptuelles ou spécifiques à une modalité mettent en avant des caractéristiques différentes. Une perte faible ne garantit pas de signification sémantique.
Les autoencodeurs sous‑complets limitent la dimension latente. Les autoencodeurs de débruitage reconstruisent des données propres à partir d’une entrée corrompue. Les variantes parcimonieuses pénalisent l’activation ; les variantes contractives pénalisent la sensibilité. Les autoencodeurs variationnels apprennent une distribution latente probabiliste en combinant la reconstruction avec un terme de divergence, permettant l’échantillonnage mais modifiant l’objectif. Les autoencodeurs convolutionnels, séquentiels, graphiques et de type transformeur codent la structure de la modalité. Choisissez la taille latente et la régularisation via une validation en aval, pas uniquement grâce à des graphiques bidimensionnels attrayants.
Détection d’anomalies, compression et évaluation
Pour la détection d’anomalies, entraînez le modèle sur des données normales représentatives et évaluez l’erreur de reconstruction ou la vraisemblance latente, mais les anomalies peuvent parfois bien se reconstruire et les cas normaux rares être mal reconstruits. Sélectionnez les seuils sur des cas de validation étiquetés ou examinés, rapportez le rappel au niveau des événements et les fausses alertes, et testez les changements d’état de fonctionnement. Comparez avec des bases statistiques simples et des méthodes à classe unique. Pour la compression, comptez le codec complet — y compris la taille du modèle, la quantification, les métadonnées et le calcul de décodage — et comparez la qualité à un débit binaire équivalent avec les codecs établis.
La qualité de la représentation peut être évaluée via des sondes linéaires, la stabilité du regroupement, la recherche, la reconstruction et les tâches en aval, chacune répondant à une question différente. Évitez les fuites lors de l’apprentissage de l’encodeur et de la sélection des seuils. Inspectez quelles caractéristiques la perte ignore et si des attributs sensibles restent encodés. Un latent compressé n’est pas automatiquement anonymisé ; l’inversion et l’inférence d’attributs peuvent récupérer des informations privées. Les reconstructions générées peuvent également sembler plausibles tout en modifiant des détails critiques.
Déploiement et surveillance
Versionnez l’encodeur et le décodeur ensemble, validez les changements numériques après exportation et conservez l’échelle d’entrée. Surveillez la distribution des reconstructions, la dérive latente, les alertes de seuil et les résultats confirmés. Dans la surveillance industrielle, conditionnez le modèle sur le mode de fonctionnement afin que les transitions normales ne soient pas traitées comme des défauts. Pour la reconstruction médicale ou scientifique, ne présentez jamais un détail généré comme preuve mesurée sans validation ni traçabilité. Les autoencodeurs sont des apprenants de représentation flexibles, mais ce sont les contraintes et la perte — et non le nom de l’architecture — qui déterminent les informations conservées, éliminées ou fabriquées.
Exemple pratique : un autoencodeur pour les anomalies de pompes
Un autoencodeur sous‑complet apprend des fenêtres de vibration à partir d’opérations de pompes saines vérifiées, couvrant les charges et les températures. Il est comparé à des seuils statistiques et à des méthodes à classe unique, et son seuil de reconstruction est sélectionné sur des transitions normales examinées et des défauts connus. L’évaluation utilise le rappel d’événements, le délai d’avertissement, les fausses alertes par heure de fonctionnement et les résultats par pompe, et non des fenêtres aléatoires plaçant des échantillons adjacents dans l’entraînement et le test.
Le modèle de production se conditionne sur l’état de fonctionnement et expose les motifs résiduels aux ingénieurs. Une forte erreur déclenche une inspection ; il ne diagnostique pas la pièce ni n’arrête la pompe automatiquement. La déconnexion du capteur, le clipping et une charge non vue génèrent des états explicitement invalides. La surveillance suit la distribution des reconstructions, la confirmation des alertes et la santé des capteurs. Lorsque la maintenance ou le matériel modifie la référence, l’ancien modèle reste disponible tandis qu’un candidat est entraîné sur des données examinées et rejoué sur des incidents historiques.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs prévus, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et chaque seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un secours sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, un apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Questions fréquemment posées
Les autoencodeurs sont-ils une compression sans perte ?
Pas généralement. Ils apprennent généralement des représentations avec perte spécifiques à la tâche et à la distribution et nécessitent le décodeur entraîné pour reconstruire les données.
Chaque goulot d’étranglement est-il interprétable ?
Non. Un code compact peut être utile sans que chaque dimension corresponde à un concept lisible par l’homme.
Références principales












