Fondamentaux de l’IA
Qu’est‑ce que le clustering K‑means ?

 Ajouter Unite.AI à vos sources préférées sur Google
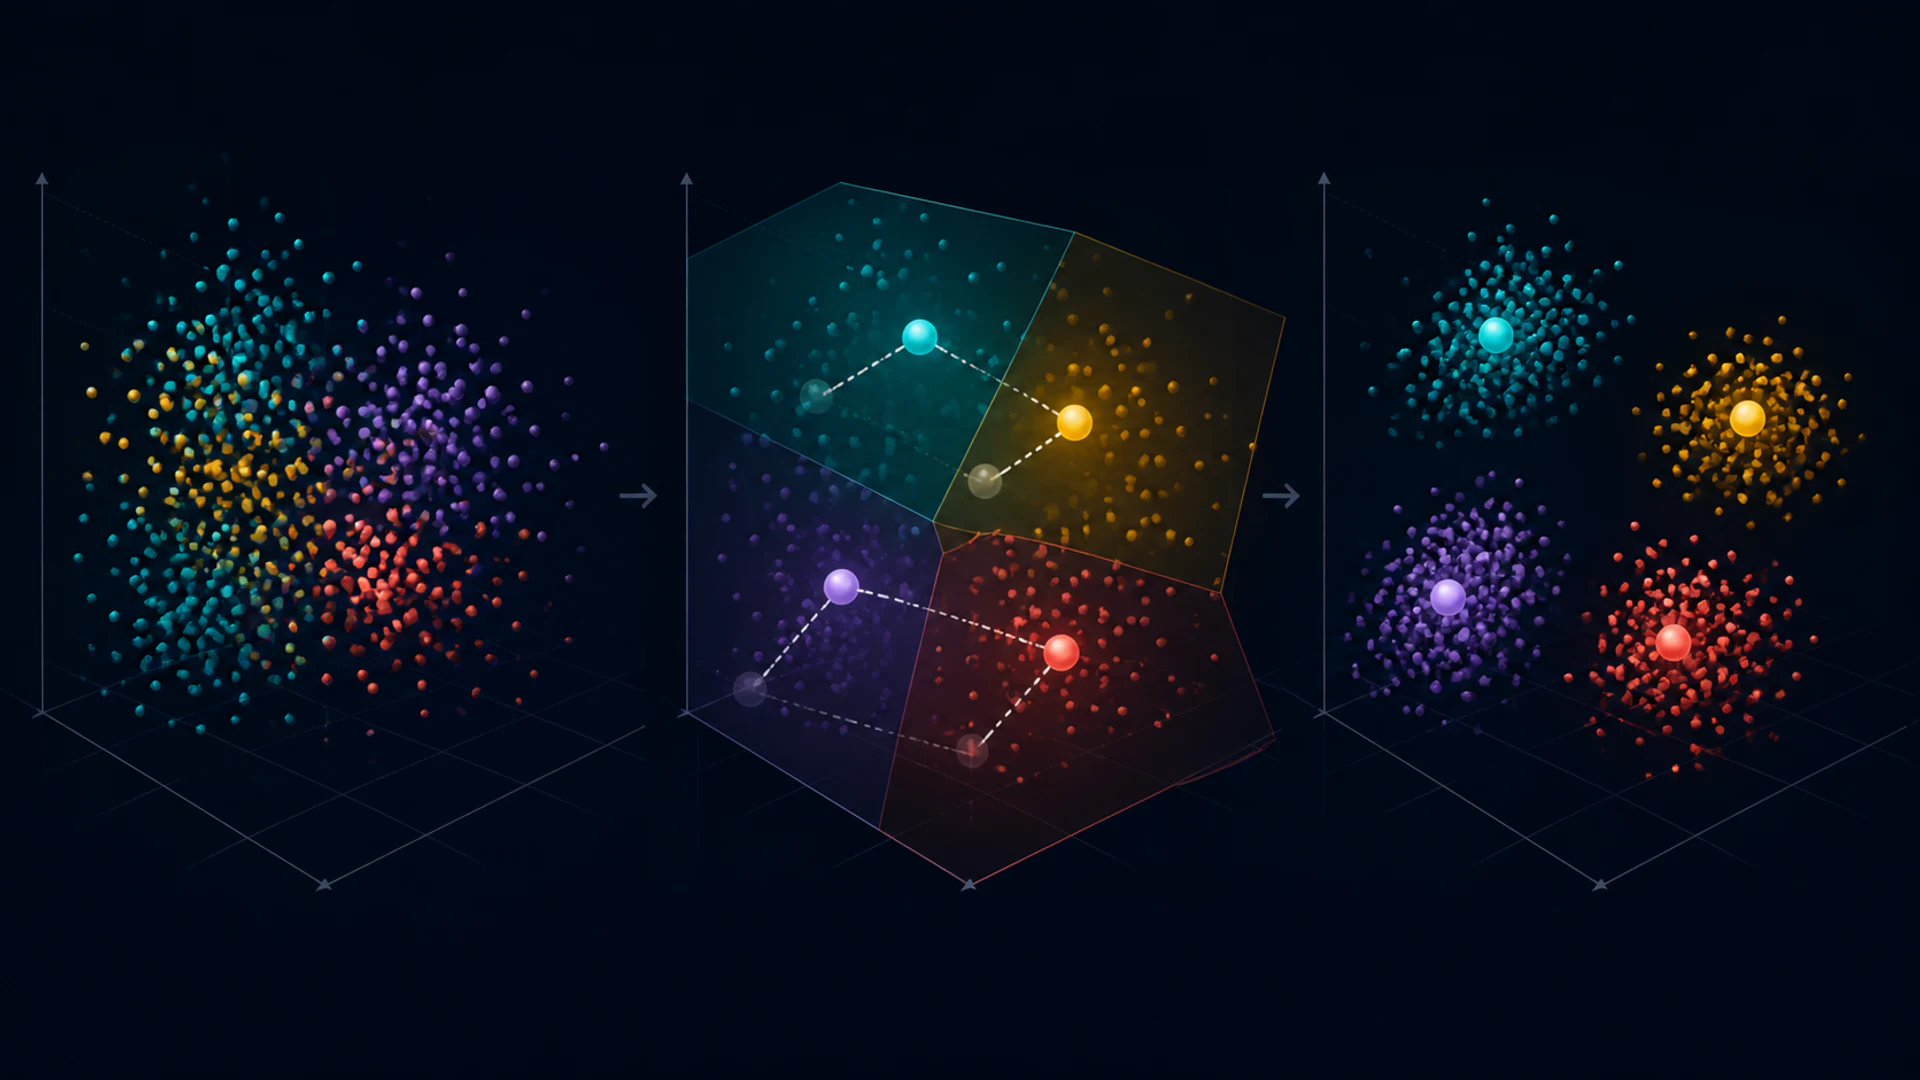
K-means est un algorithme non supervisé qui partitionne des observations numériques en k groupes. Il alterne entre l’attribution de chaque point à son centroïde le plus proche et le recomptage de chaque centroïde comme la moyenne des points qui lui sont assignés.
L’algorithme est rapide et utile, mais son résultat dépend du redimensionnement, de la distance, de l’initialisation et du k choisi. Un groupe est une partition mathématique, pas automatiquement une catégorie du monde réel.
Points clés
- K‑means minimise la distance euclidienne carrée intra‑groupe aux centroïdes.
- L’initialisation est importante ; k‑means++ répartit les centroïdes initiaux et améliore généralement les résultats.
- Standardisez les variables lorsque leurs unités ou échelles doivent contribuer de façon comparable.
- K‑means a du mal avec les valeurs aberrantes, les groupes non sphériques, les densités inégales et les données catégorielles.
L’objectif et la boucle de mise à jour
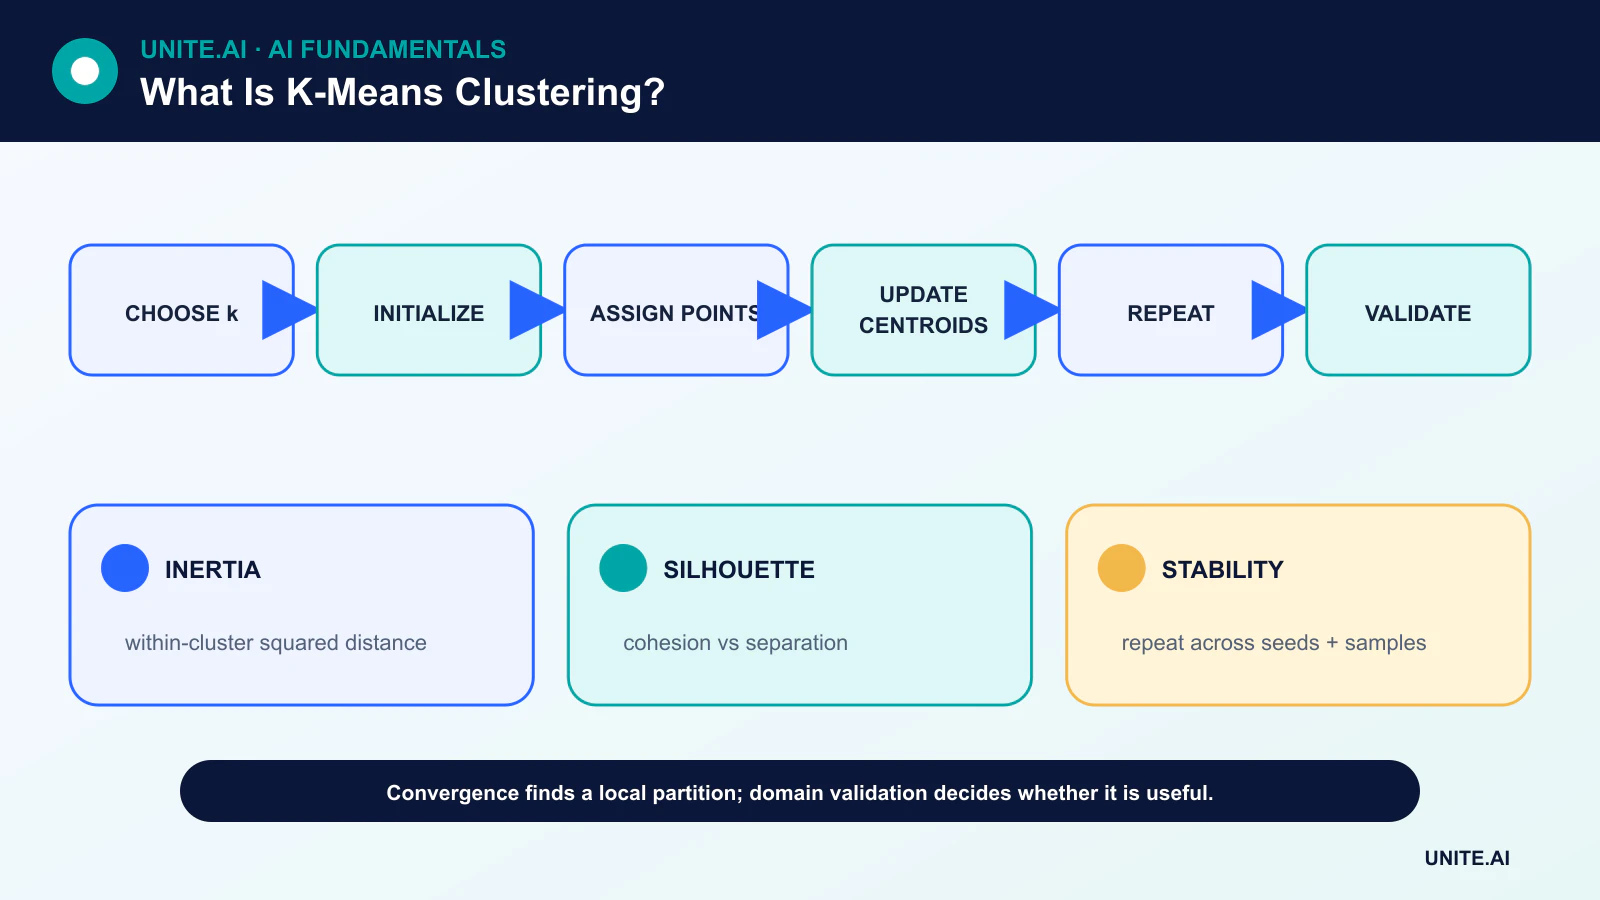
Étant donné k centroïdes, l’étape d’affectation envoie chaque observation à celui qui est le plus proche. L’étape de mise à jour remplace chaque centroïde par la moyenne des observations qui lui sont assignées. La somme des carrés intra‑groupe ne peut pas augmenter avec ces étapes, ainsi le processus converge vers un optimum local.
La convergence ne garantit pas l’optimum global. Des centroïdes initiaux différents peuvent conduire à des partitions différentes, c’est pourquoi les implémentations exécutent plusieurs initialisations et conservent la solution présentant la plus faible inertie.
Initialisation et k‑means++
Choisir aléatoirement tous les centroïdes de départ dans une même zone dense peut produire une solution médiocre ou ralentir la convergence. k‑means++ sélectionne les graines avec une probabilité liée à la distance aux graines déjà existantes, favorisant une couverture du jeu de données.
Exécuter plusieurs fois reste utile. Enregistrez la graine aléatoire et le nombre d’initialisations afin que les résultats puissent être reproduits.
Mise à l’échelle et distance
La distance euclidienne carrée rend K‑means sensible aux unités. Une variable mesurée en milliers peut dominer une autre mesurée entre zéro et un. La standardisation est courante, mais la connaissance du domaine doit déterminer si une variance standardisée égale reflète une importance égale.
Les valeurs aberrantes peuvent tirer la moyenne loin des points typiques. Un redimensionnement robuste, l’élagage ou des méthodes basées sur les méd oïdes peuvent être plus appropriés. Les variables catégorielles encodées en one‑hot créent une géométrie de distance qui ne correspond pas forcément à la similarité des catégories.
Choisir k et valider les groupes
L’inertie diminue chaque fois que k augmente, il ne peut donc pas être sélectionné seul. L’heuristique du coude recherche une amélioration décroissante. L’analyse de silhouette compare cohésion et séparation. La stabilité à travers les échantillons et les graines ajoute une vérification supplémentaire.
La validation la plus forte est l’utilité pour le domaine visé. Comparez les groupes avec des résultats connus, une revue d’experts ou une tâche en aval sans prétendre que les étiquettes post‑hoc ont été découvertes objectivement.
Limites et alternatives
K‑means privilégie des groupes compacts, approximativement sphériques et de même échelle. Les modèles de mélanges gaussiens représentent des composantes ellipsoïdales probabilistes ; les méthodes de type DBSCAN identifient des régions denses et le bruit ; le clustering hiérarchique produit un arbre de fusions.
La réduction de dimensionnalité peut améliorer la vitesse ou débruiter les entrées, mais l’ajuster sur l’ensemble complet des données peut modifier la question de validation. Le mini‑batch K‑means réduit le calcul pour de grands ensembles de données au prix d’une mise à jour approximative.
Objectif, initialisation et convergence
K‑means partitionne les observations numériques en k groupes en minimisant la distance euclidienne carrée intra‑groupe aux centroïdes. L’algorithme de Lloyd alterne l’attribution de chaque point à son centroïde le plus proche et le recomptage des centroïdes jusqu’à ce que les attributions ou l’objectif se stabilisent. Il converge vers un optimum local, pas nécessairement le meilleur global. L’initialisation k‑means++ répartit les centres initiaux et améliore généralement les résultats, mais plusieurs graines restent importantes. Standardisez les variables lorsque les unités doivent contribuer de façon comparable, car la distance carrée amplifie les variables à grande échelle et les valeurs aberrantes.
La méthode suppose des groupes approximativement compacts, sphériques et d’échelle similaire sous géométrie euclidienne. Elle a des difficultés avec des variétés allongées, des densités inégales, des données catégorielles, des valeurs aberrantes importantes et des structures imbriquées. Les groupes vides et les points dupliqués nécessitent une prise en charge définie. Le mini‑batch k‑means s’adapte aux grands volumes de données avec un compromis d’approximation. Pour du texte clairsemé, le k‑means sphérique orienté cosinus peut mieux correspondre à la direction, tandis que les mélanges, les méthodes de densité, le clustering hiérarchique ou le k‑medoids codent d’autres hypothèses.
Choisir k et valider le sens
Les courbes du coude, les scores de silhouette, les critères d’information dans les modèles associés et la stabilité peuvent orienter le choix de k, mais aucun ne découvre un nombre unique et correct. L’utilité commerciale et l’interprétation du domaine sont importantes. Ré‑ajustez sur différents échantillons et graines, comparez le déplacement des centroïdes et la cohérence des attributions, et validez les groupes sur des résultats indépendants qui n’ont pas servi à les créer. Une projection bidimensionnelle peut déformer la séparation, il faut donc examiner les distances et les exemples dans l’espace de représentation original ou validé.
Les groupes sont des ensembles descriptifs créés à partir des variables et de la métrique sélectionnées ; ils ne sont pas des catégories naturelles ou des segments causaux. Les profils basés sur les mêmes variables que le clustering peuvent être circulaires. Utilisez des attributs réservés et une revue qualitative, et vérifiez si les groupes reproduisent principalement la géographie, la source des données ou des traits sensibles. Les petits groupes peuvent être des anomalies ou des artefacts. Nommer un groupe ne fait pas que chaque membre corresponde à l’étiquette.
Déploiement et maintenance
Conservez le redimensionnement, l’ordre des variables, les centroïdes, la définition de la distance et les étiquettes de groupe ensemble. Pour de nouveaux points, surveillez la distance au centroïde assigné et la fraction qui dépasse largement le support d’entraînement ; fournissez un état « inconnu » plutôt que de forcer chaque cas dans un groupe. Suivez la taille des groupes, les centroïdes et la pertinence des résultats au fil du temps. Le ré‑entraînement modifie les identités des groupes, il faut donc mapper ou versionner les règles en aval plutôt que de réutiliser silencieusement les anciens noms. K‑means constitue une base utile de compression et de segmentation lorsque sa géométrie correspond à la problématique, mais ce n’est pas un moteur de découverte universel.
Exemple pratique : segmentation client avec k‑means
Une société d’abonnement standardise les variables d’usage sur une fenêtre fixe, supprime les identifiants de compte et teste k à travers différentes graines. La stabilité, la silhouette et les résultats commerciaux réservés sont examinés, mais les équipes produit inspectent également les comptes représentatifs et limites. Elles découvrent qu’un groupe correspond simplement à de nouveaux clients avec une observation plus courte, ainsi la durée d’abonnement est gérée explicitement. K‑means est comparé aux alternatives hiérarchiques et basées sur la densité plutôt que d’être considéré comme approprié a priori. L’exercice est traité comme un apprentissage non supervisé, et non comme une découverte d’étiquettes.
Les segments guident les recherches et les expérimentations de messages, pas l’éligibilité ou le prix. Les nouveaux comptes éloignés de tous les centroïdes reçoivent une affectation « inconnue ». Le redimensionnement, les variables, les centroïdes et les noms sont versionnés, et le ré‑entraînement mappe les nouveaux groupes aux anciens uniquement avec preuve. La surveillance suit la taille des groupes, la distance et la pertinence des résultats. Les attributs sensibles et les proxys sont audités, et l’équipe évite de décrire les groupes comme des types de personnalité naturels alors qu’il s’agit de partitions mathématiques d’un comportement sélectionné.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être négligés. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un examinateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les changements, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Le K‑means est‑il supervisé ou non supervisé ?
Il est non supervisé car il reçoit les variables et le nombre de groupes choisi, sans étiquettes cibles.
Le K‑means classe‑t‑il de nouvelles données ?
Après l’ajustement, un nouveau point peut être assigné à son centroïde le plus proche. Il s’agit d’une assignation à un groupe, pas nécessairement d’une prédiction de classe supervisée.
Références principales