
Fondamentaux de l’IA
Apprentissage supervisé vs apprentissage non supervisé

 Ajouter Unite.AI à vos sources préférées sur Google
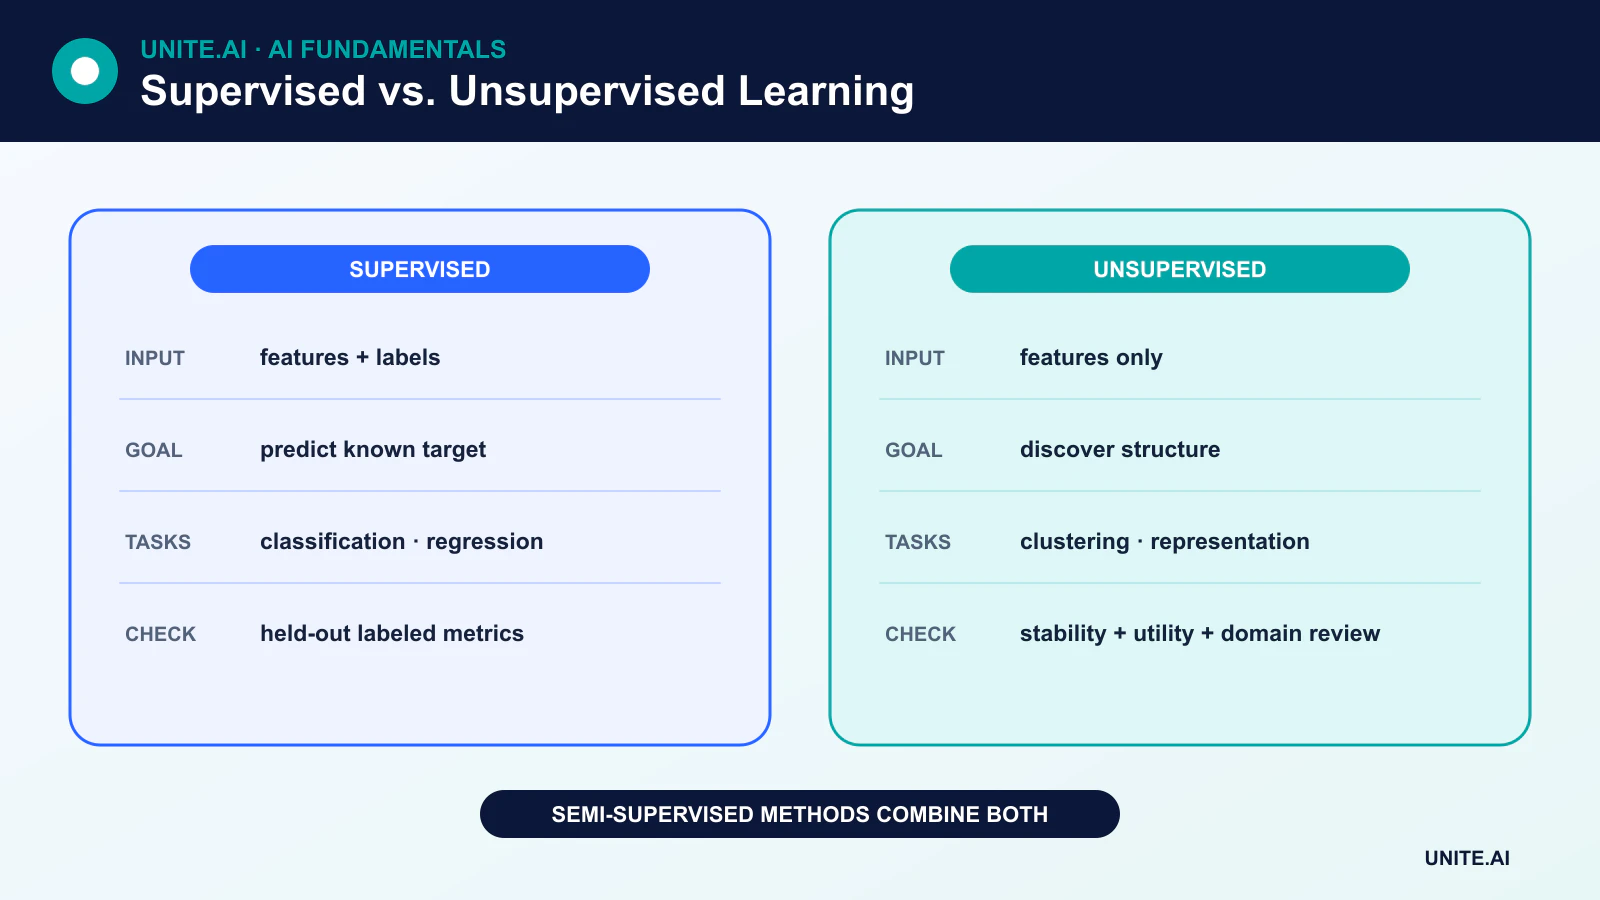
Apprentissage supervisé apprend à partir d’exemples associés à des réponses cibles. Apprentissage non supervisé recherche une structure dans les données sans étiquettes cibles. La différence ne porte pas sur la supériorité ou la précision d’une approche ; elle réside dans le type de signal d’apprentissage disponible et la question à laquelle le système est conçu pour répondre.
Il s’agit de deux paradigmes majeurs au sein de l’apprentissage automatique, mais les systèmes modernes utilisent également l’apprentissage semi‑supervisé, auto‑supervisé et par renforcement.
Points clés
- L’apprentissage supervisé prédit une cible connue ; l’apprentissage non supervisé découvre des motifs ou des représentations.
- La classification et la régression sont des tâches supervisées ; le regroupement, l’estimation de densité et de nombreuses méthodes de réduction de dimensionnalité sont non supervisés.
- Les sorties non supervisées ne correspondent pas automatiquement à des classes du monde réel et peuvent être plus difficiles à évaluer.
- Le coût de calcul et la précision dépendent de l’algorithme, des données, de la tâche et de l’évaluation — et non du seul paradigme.
Comment fonctionne l’apprentissage supervisé
Un jeu de données supervisé contient des caractéristiques X et une cible y. L’entraînement ajuste le modèle afin que ses prédictions se rapprochent des cibles. L’évaluation utilise des exemples étiquetés réservés pour estimer la capacité de généralisation.
Classification
La classification prédit une catégorie : spam ou non spam, un sujet de document parmi plusieurs, ou un ou plusieurs objets dans une image. Les métriques pertinentes comprennent la précision, le rappel, le F1, la calibration et les mesures sensibles aux coûts. L’exactitude peut être trompeuse lorsqu’une classe est rare ; une matrice de confusion révèle quelles classes sont confondues.
Régression
La régression prédit une valeur continue, comme la demande, la durée ou la température. La régression linéaire peut utiliser une ou plusieurs caractéristiques ; elle ne se limite pas à établir une relation entre deux variables. Les métriques de régression comprennent l’erreur absolue moyenne, la racine de l’erreur quadratique moyenne et les coûts spécifiques à la tâche.
Algorithmes supervisés courants
Les méthodes supervisées comprennent les modèles linéaires et logistiques, les arbres de décision, les forêts aléatoires, le gradient boosting, les machines à vecteurs de support, les k‑plus proches voisins et les réseaux de neurones.
La régression logistique produit un score ou une probabilité qui peut être converti en classe à l’aide d’un seuil choisi. Une feuille d’arbre de décision contient une prédiction basée sur une région de l’espace des caractéristiques, pas nécessairement sur une seule observation d’entraînement. Le KNN prédit à partir d’exemples d’entraînement étiquetés proches et nécessite toujours une conception solide d’entraînement/validation/test.
Comment fonctionne l’apprentissage non supervisé
L’apprentissage non supervisé reçoit des caractéristiques sans colonne cible. Son objectif est défini indirectement — par exemple, minimiser la distance au sein des grappes, reconstruire une entrée, estimer la densité des données, ou conserver le maximum de variance possible dans moins de dimensions.
Regroupement
K‑means attribue les points à un nombre choisi de grappes et met à jour les centres de grappes afin de réduire la distance quadratique intra‑grappe. L’algorithme découvre des groupements géométriques selon une distance et une représentation des caractéristiques données. Ces groupes ne correspondent pas automatiquement à des types de clients, diagnostics ou autres étiquettes de domaine significatives.
Réduction de dimensionnalité
Réduction de dimensionnalité représente les données en utilisant moins de variables. L’analyse en composantes principales trouve des directions orthogonales qui conservent le maximum de variance possible sous une projection linéaire. D’autres méthodes préservent des notions de structure différentes et peuvent produire des visualisations très diverses.
Anomalie et estimation de densité
Les méthodes non supervisées peuvent estimer où les données sont denses et signaler des observations inhabituelles. Un score d’anomalie ne prouve pas une fraude, une défaillance ou un comportement malveillant ; il identifie une déviation selon la représentation et le modèle choisis.
Évaluation de l’apprentissage non supervisé
Il n’existe pas de notion universelle d’« exactitude » en apprentissage non supervisé. Un praticien peut utiliser des métriques internes telles que le score de silhouette, comparer la stabilité entre échantillons, tester l’utilité dans une tâche en aval, ou interroger des experts du domaine pour savoir si la structure découverte est pertinente. Si des étiquettes de vérité terrain existent pour l’évaluation, des métriques de clustering externes peuvent être utilisées sans transformer le processus d’entraînement en apprentissage supervisé.
Au‑delà de la comparaison binaire
Apprentissage semi‑supervisé
L’apprentissage semi‑supervisé combine un petit ensemble étiqueté avec un plus grand ensemble non étiqueté. Le pseudo‑étiquetage, la régularisation de cohérence et les méthodes basées sur les graphes en sont des exemples. Les données non étiquetées doivent néanmoins ressembler suffisamment à la distribution cible pour être utiles.
Apprentissage auto‑supervisé
L’apprentissage auto‑supervisé tire ses cibles de l’entrée elle‑même, comme la prédiction de tokens masqués ou l’appariement de vues transformées. Il constitue une base pour les modèles modernes de langage, de vision et multimodaux, y compris les transformers.
Apprentissage par renforcement
L’apprentissage par renforcement optimise les décisions grâce à des récompenses générées par l’interaction. Il diffère à la fois de la prédiction étiquetée et de la découverte de motifs statiques.
Choisir la bonne approche
Commencez par la décision ou l’insight que le système doit produire. Si des cibles fiables existent et que la prédiction est l’objectif, l’apprentissage supervisé est naturel. Si l’objectif est l’exploration, la représentation ou le regroupement, une méthode non supervisée peut convenir. Lorsque les étiquettes sont rares, un pré‑entraînement auto‑supervisé ou semi‑supervisé suivi d’une évaluation supervisée peut être plus efficace.
Dans tous les cas, les fuites de données, l’échantillonnage biaisé, les proxies faibles et le décalage de distribution peuvent dominer le choix de l’algorithme. Un modèle techniquement correct entraîné sur le mauvais objectif peut néanmoins échouer.
Signaux d’apprentissage, objectifs et méthodes représentatives
L’apprentissage supervisé utilise des exemples associés à des étiquettes ou valeurs cibles et optimise l’erreur de prédiction. La classification, la régression, le classement et la prédiction structurée diffèrent par la sortie et la fonction de perte. L’apprentissage non supervisé recherche une structure sans étiquettes cibles via le regroupement, l’estimation de densité, la réduction de dimensionnalité, l’apprentissage de représentation ou la modélisation générative. L’apprentissage auto‑supervisé crée des cibles de prédiction à partir des données elles‑mêmes, tandis que l’apprentissage semi‑supervisé combine un petit ensemble étiqueté avec un plus grand ensemble non étiqueté. Ces catégories décrivent le signal d’apprentissage ; la même architecture neuronale peut être entraînée sous plusieurs paradigmes.
Les étiquettes rendent un objectif explicite mais introduisent un coût d’annotation, du bruit, des hypothèses de politique et un décalage temporel. Les données non étiquetées sont plus faciles à collecter mais n’indiquent pas à l’algorithme quelle structure découverte est utile. Une grappe peut refléter l’éclairage, la longueur d’un document ou la source d’acquisition plutôt qu’une catégorie pertinente. Définissez l’évaluation de manière indépendante : les modèles supervisés utilisent des résultats étiquetés réservés, tandis que les modèles non supervisés nécessitent stabilité, reconstruction, vraisemblance, récupération, utilité en aval ou validation d’experts. La simple séparation visuelle ne constitue pas une preuve de structure valide.
Choisir un paradigme et prévenir les erreurs courantes
Utilisez l’apprentissage supervisé lorsqu’une cible stable et des étiquettes représentatives existent. Recourez à l’exploration non supervisée pour résumer, détecter la nouveauté, compresser ou générer des hypothèses, mais considérez les sorties comme provisoires. Le pré‑entraînement auto‑supervisé est précieux lorsque les données brutes sont abondantes et que les tâches en aval partagent les représentations. Les méthodes semi‑supervisées ne sont utiles que lorsque les hypothèses sur les données non étiquetées et la structure des classes sont valides. Comparez avec des bases simples et tenez compte du coût total de collecte, d’étiquetage, de révision, de calcul et d’erreurs plutôt que de supposer que le non étiqueté implique automatiquement un faible coût.
Prévenez les fuites en séparant les entités liées avant de dériver les étiquettes, augmentations ou pseudo‑étiquettes. Surveillez l’équilibre des classes, l’accord d’annotation, la stabilité des grappes, les collapses et les dérives. Les pseudo‑étiquettes peuvent renforcer les erreurs initiales ; le regroupement peut encoder des attributs sensibles ; une représentation pré‑entraînée peut transférer les biais de la source. La révision humaine doit se concentrer sur les cas limites et leurs conséquences. En production, documentez comment le signal d’apprentissage a été créé et quand il devient obsolète. Le paradigme détermine où la supervision intervient dans le système, et non l’absence de choix et de valeurs humaines.
Exemple pratique : découverte et étiquetage des sujets de support
Une entreprise utilise d’abord des embeddings non supervisés et le clustering pour explorer les thèmes dans des messages de support anonymisés. Les analystes examinent des exemples représentatifs et limites et constatent que certaines grappes reflètent la longueur du message et le canal plutôt que les problèmes. Ils développent une taxonomie supervisée avec une classe inconnue, des consignes d’annotation et un accord mesuré. Un classificateur est ensuite évalué sur des périodes ultérieures, des langues et des produits, en le comparant aux bases de mots‑clés et de plus proches voisins.
Les nouveaux messages non étiquetés permettent de détecter le glissement, mais ne réentraînent pas automatiquement le classificateur. Les réviseurs étiquettent les cas incertains et émergents sélectionnés via l’apprentissage actif, avec des contrôles de qualité et un ensemble d’évaluation scellé. La surveillance suit la prévalence des sujets, la confiance, les désaccords et les résultats de routage. Lors du lancement d’un nouveau produit, la taxonomie et la capacité des équipes en aval sont mises à jour conjointement. Le flux de travail utilise des méthodes non supervisées pour la génération d’hypothèses et des preuves supervisées pour le routage opérationnel.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le responsable et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un ensemble d’évaluation versionné avant l’optimisation. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le décalage de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un réviseur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attractif.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Références principales












