
Fondamentaux de l’IA
Qu’est‑ce que l’apprentissage few‑shot ?

 Ajouter Unite.AI à vos sources préférées sur Google
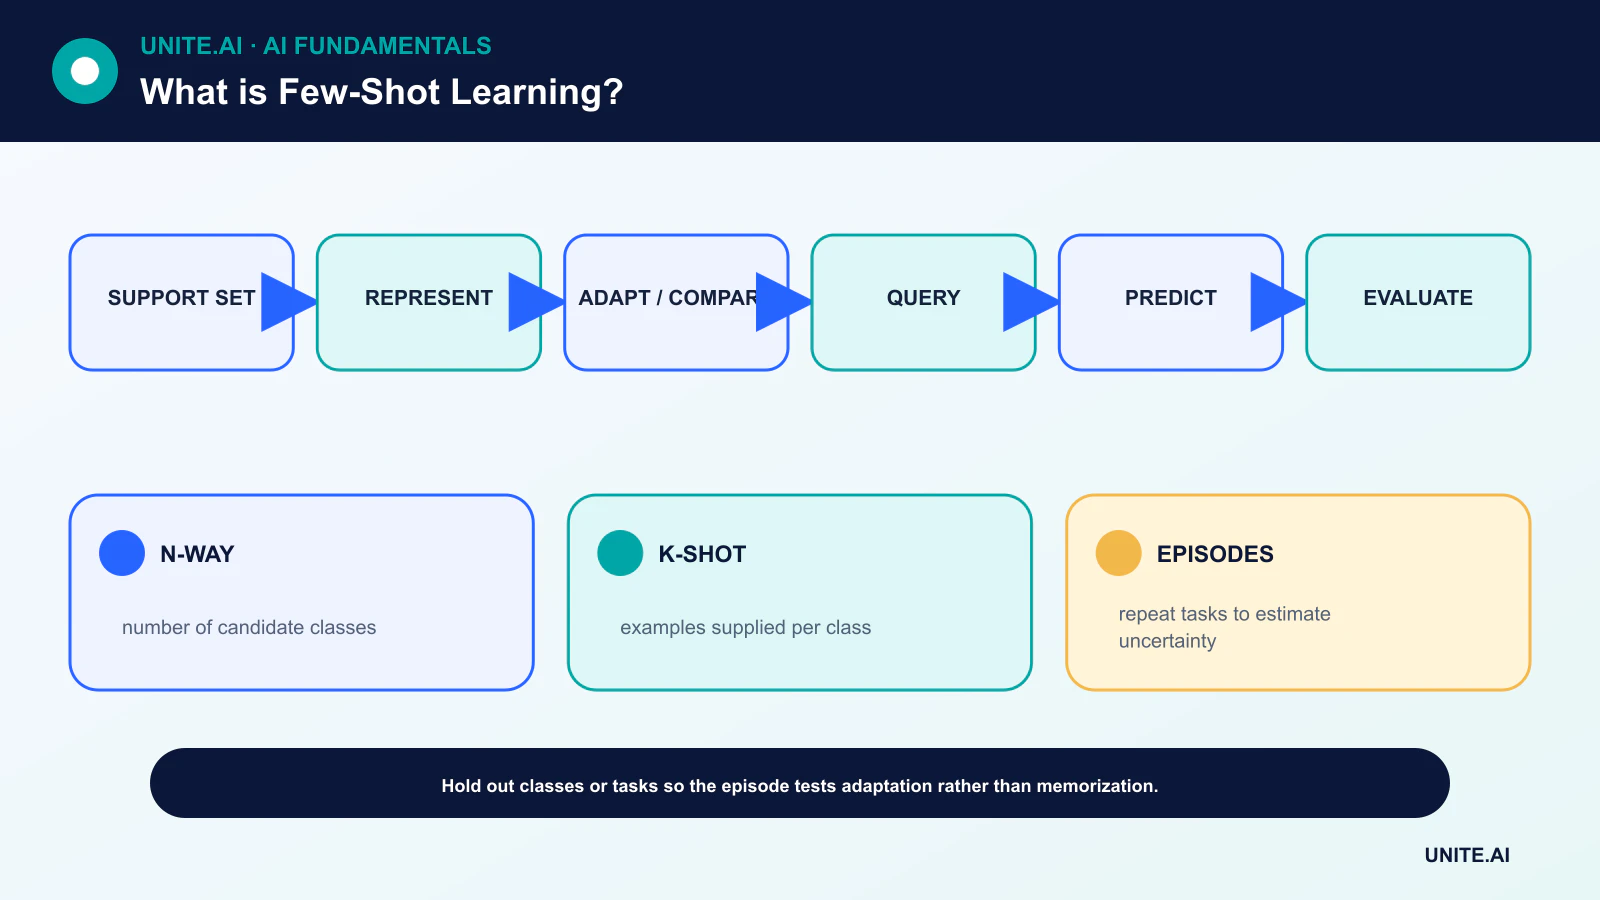
Few-shot learning étudie comment un modèle peut s’adapter à une nouvelle tâche ou classe à partir d’un petit nombre d’exemples étiquetés. Dans les benchmarks classiques, un épisode fournit un ensemble de support — par exemple cinq classes avec un ou cinq exemples par classe — et demande au modèle de classer des requêtes invisibles.
Le terme désigne également l’apprentissage en contexte, où un modèle de langage pré‑entraîné reçoit quelques démonstrations dans son prompt sans mise à jour des paramètres. Ces configurations partagent l’objectif de très peu d’exemples, mais utilisent des mécanismes d’adaptation différents et nécessitent des conceptions d’évaluation distinctes.
Points clés
- N‑way K‑shot désigne N classes et K exemples de support étiquetés par classe.
- Les méthodes d’apprentissage métrique comparent les requêtes aux représentations apprises des exemples de support.
- Le méta‑apprentissage optimise sur de nombreuses tâches afin qu’une nouvelle tâche puisse être apprise rapidement.
- Avec peu d’exemples, les erreurs d’étiquetage, les fuites, l’ambiguïté des classes et l’incertitude sont amplifiées, ainsi les références de base et le reporting de confiance sont importants.
Épisodes, ensembles de support et ensembles de requêtes
Un épisode few‑shot sépare un petit ensemble de support étiqueté d’un ensemble de requêtes utilisé pour l’évaluation. Lors du méta‑entraînement, le modèle voit de nombreux épisodes de ce type. Une évaluation rigoureuse réserve des classes, tâches ou domaines entiers afin que l’épisode de test mesure l’adaptation plutôt que la mémorisation.
Rapportez les distributions de précision sur de nombreux épisodes plutôt que sur un seul échantillon pratique. Comparez avec des références simples de voisin le plus proche et linéaires ; une méthode sophistiquée qui ne surpasse pas une représentation bien entraînée associée à un classificateur basique peut ne pas justifier sa complexité.
Apprentissage métrique et prototypes
Les réseaux de correspondance (matching networks) et méthodes similaires intègrent les exemples de support et de requête dans un espace où les vecteurs proches doivent partager la même étiquette. Les réseaux prototypiques moyennent les embeddings de support pour chaque classe et classifient une requête en fonction de la distance à ces prototypes de classe.
Cela relie l’apprentissage few‑shot à la qualité des représentations. Un modèle d’apprentissage profond pré‑entraîné peut déjà organiser correctement les caractéristiques pertinentes, tandis qu’une représentation inadaptée peut rendre chaque distance trompeuse.
Méta‑apprentissage basé sur l’optimisation
Model-Agnostic Meta-Learning (MAML) recherche des paramètres pouvant s’adapter avec un petit nombre d’étapes de gradient. D’autres méthodes apprennent un optimiseur, une initialisation ou une règle de mise à jour des paramètres. La boucle externe évalue la performance post‑adaptation sur l’ensemble des tâches.
Le méta‑apprentissage suppose qu’une structure utile est partagée entre les tâches d’entraînement et les tâches cibles. Lorsque la distribution cible diffère fortement, l’adaptation rapide peut échouer. La validation doit varier le nombre d’exemples, les classes, les domaines et la difficulté des tâches au lieu de considérer un seul benchmark comme universel.
Apprentissage par transfert et stratégies au niveau des données
Transfer learning est souvent le point de départ pratique le plus solide : geler un encodeur pré‑entraîné, entraîner une petite tête, puis affiner sélectivement si suffisamment de données existent. L’augmentation de données peut introduire des invariances, mais des exemples synthétiques irréalistes peuvent amplifier les biais ou créer des raccourcis.
L’apprentissage actif peut prioriser quels exemples étiqueter, tandis que l’apprentissage semi‑supervisé peut exploiter des données non étiquetées supplémentaires. Ce sont des stratégies complémentaires, pas des synonymes de l’apprentissage few‑shot.
Le prompting few‑shot est différent
Un transformeur peut inférer un motif à partir de démonstrations placées dans son contexte. Aucune mise à jour persistante des paramètres n’est requise. L’ordre, la formulation et l’équilibre des étiquettes peuvent modifier sensiblement la sortie, et les exemples peuvent occuper une grande partie de la fenêtre de contexte.
Utilisez un ensemble d’évaluation représentatif, versionnez chaque prompt et démonstration, et testez les alternatives zero‑shot, few‑shot et fine‑tuned. Un petit ensemble de support ne permet pas de formuler des affirmations fortes à l’échelle de la population, surtout pour des cas rares ou critiques pour la sécurité.
Paradigmes d’apprentissage few‑shot et construction de tâches
L’apprentissage few‑shot vise à exécuter une tâche à partir de très peu d’exemples étiquetés. Dans les méthodes basées sur les métriques, un encodeur projette les exemples dans un espace où les prototypes ou voisins les plus proches représentent les classes. Le méta‑apprentissage basé sur l’optimisation entraîne une initialisation ou une règle de mise à jour pour une adaptation rapide. L’apprentissage par transfert affine un modèle pré‑entraîné sur un petit ensemble cible. L’apprentissage en contexte fournit des exemples dans un prompt sans mettre à jour les poids. Ces mécanismes diffèrent, ainsi les affirmations doivent préciser si les paramètres changent, quel entraînement préalable a eu lieu et comment les exemples sont sélectionnés.
L’évaluation doit séparer les classes, tâches, sujets ou domaines d’entraînement et de test selon la généralisation revendiquée. Un épisode N‑way K‑shot contient N classes et K exemples de support par classe, ainsi que des exemples de requête pour le scoring. Des épisodes répétés estiment la variance due à la sélection du support. Pour le prompting, l’ordre des exemples, la formulation des étiquettes, le format et la similarité des démonstrations peuvent modifier sensiblement les résultats. Comparez avec des références zero‑shot, voisin le plus proche, linear‑probe et fine‑tuning ordinaire en utilisant la même représentation et le même budget de données.
Qualité des données, incertitude et transfert négatif
Avec peu d’exemples, les cas mal étiquetés ou atypiques ont une influence disproportionnée. Définissez des règles d’annotation, inspectez chaque élément de support et conservez une issue « inconnu » ou « abstention ». L’augmentation de données et les exemples synthétiques ne sont utiles que lorsqu’ils préservent la tâche et ajoutent une variation réaliste. Un modèle pré‑entraîné peut transférer des raccourcis ou des biais de son domaine source. Testez des cas hors domaine, des groupes rares et la sensibilité à la suppression d’un exemple de support. Rapporte des intervalles de confiance sur l’ensemble des tâches et des graines aléatoires, et non un seul prompt favorable.
L’apprentissage actif peut solliciter des étiquettes sur des cas informatifs, tandis que les méthodes semi‑supervisées utilisent des données non étiquetées sous des hypothèses supplémentaires. La récupération peut sélectionner dynamiquement des démonstrations pertinentes mais doit éviter les fuites d’étiquettes de test. L’adaptation peut sur‑apprendre rapidement, il faut donc contraindre les mises à jour, utiliser la régularisation et valider sur des exemples séparés. Pour les tâches à haut risque, quelques étiquettes justifient rarement des décisions autonomes ; utilisez le modèle pour prioriser ou assister la révision jusqu’à ce que des preuves suffisantes des résultats existent.
Exploitation en production
Versionnez le modèle de base, l’embedding ou le modèle de prompt, les démonstrations, le schéma d’étiquettes et les paramètres d’adaptation. Protégez les exemples car les prompts ou les gradients peuvent exposer des enregistrements sensibles. Surveillez les performances à mesure que les classes et le langage évoluent, et rafraîchissez les exemples de support via une révision gouvernée plutôt que par auto‑étiquetage automatique. L’apprentissage few‑shot réduit le besoin d’étiquettes cibles en exploitant la structure préalable ; il n’élimine pas la nécessité d’une évaluation représentative, d’une définition de tâche rigoureuse, d’une expertise domaine, ou d’une solution de secours sûre lorsque la nouvelle tâche sort de ce cadre.
Exemple concret : classification few‑shot pour un nouveau produit
Une équipe de support a besoin d’étiquettes de routage pour un produit avec seulement cinq exemples examinés par problème. Elle compare les prototypes les plus proches dans un embedding pré‑entraîné, une tête linéaire, un fine‑tuning efficace en paramètres et le prompting en contexte. Les familles de produits, les clients et les messages ultérieurs sont exclus du méta‑entraînement et de la sélection du modèle. Un échantillonnage répété de l’ensemble de support rapporte le rappel par classe, la calibration, la variance et la sensibilité à une démonstration mal étiquetée.
Les messages à faible confiance ou non pris en charge sont dirigés vers le support général, et les réviseurs corrigent les étiquettes via une file d’attente gouvernée. Les exemples sont anonymisés, versionnés et jamais sélectionnés dans l’ensemble de test final. La surveillance suit le nouveau vocabulaire, les taux de classe, les corrections et les désaccords. Lorsque suffisamment d’étiquettes sont accumulées, le système few‑shot est comparé à un entraînement supervisé ordinaire. Une mise en place rapide est utile, mais elle ne justifie pas l’automatisation si les performances restent instables ou si le nouveau produit diffère sensiblement des familles de tâches antérieures.
Preuves de mise en œuvre et disponibilité opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une ligne de base reproductible et un ensemble d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées mal formées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attractif.
Avant le lancement, attribuez l’autorité pour la publication, les exceptions, les modifications, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de rétention, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Questions fréquentes
L’apprentissage one‑shot est‑il identique à l’apprentissage few‑shot ?
L’apprentissage one‑shot est le cas particulier avec un seul exemple de support étiqueté par classe ou tâche. L’apprentissage zero‑shot n’utilise aucun exemple cible étiqueté.
L’apprentissage few‑shot élimine‑t‑il le besoin de données ?
Non. Il déplace la dépendance vers les données de pré‑entraînement, les tâches connexes, les représentations et les hypothèses. Les étiquettes cibles sont peu nombreuses ; l’historique d’apprentissage total est généralement vaste.
Références principales












