
Fondamentaux de l’IA
Qu’est‑ce que l’apprentissage ensembliste ?

 Ajouter Unite.AI à vos sources préférées sur Google
Apprentissage par ensembles combine les prédictions de plusieurs modèles. L’idée centrale est que des modèles présentant des erreurs différentes peuvent produire un résultat plus précis ou plus stable lorsque leurs sorties sont moyennées, agrégées par vote ou transmises à un méta‑apprenant.
Ajouter des modèles ne suffit pas. Si chaque membre apprend le même raccourci, leurs erreurs seront corrélées et l’ensemble ne fera que gagner en confiance sur la même faute.
Points clés
- Les ensembles fonctionnent mieux lorsque les modèles membres sont utiles individuellement et commettent des erreurs sensiblement différentes.
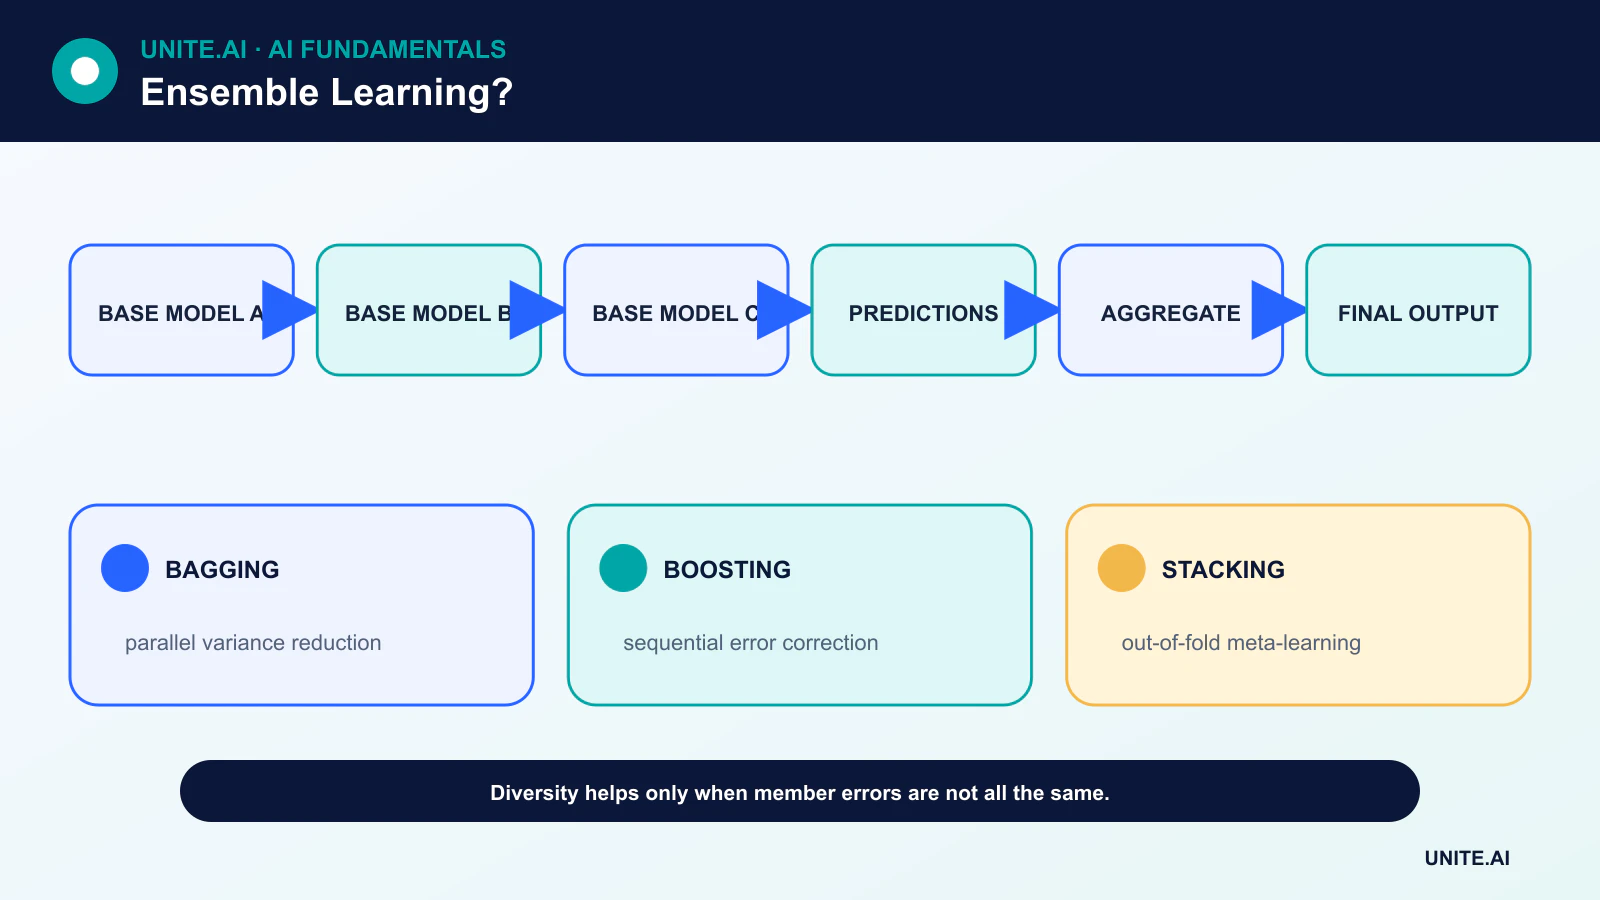
- Le bagging entraîne les membres en parallèle sur des données rééchantillonnées ; le boosting entraîne les apprenants séquentiellement pour corriger les erreurs.
- Le stacking entraîne un méta‑modèle sur les prédictions hors‑pli, et non sur les prédictions en‑échantillon.
- Les gains de précision doivent être pondérés par rapport à la latence, à la calibration, à l’interprétabilité et au coût de maintenance.
Vote et moyenne
Le vote dur (hard voting) sélectionne la classe qui obtient le plus de votes. Le vote doux (soft voting) moyenne les probabilités de classe, généralement après calibration. Les ensembles de régression agrègent souvent les prédictions numériques. Les versions pondérées donnent davantage d’influence aux membres les plus performants.
Une moyenne peut réduire la variance lorsque les erreurs ne sont pas parfaitement corrélées. Elle ne peut pas corriger un défaut de données partagé, une erreur d’étiquette ou un sous‑groupe manquant. La diversité doit être mesurée à l’aide du désaccord et du chevauchement des erreurs, et non supposée simplement à partir de noms de modèles différents.
Bagging et forêts aléatoires
Le bootstrap aggregating (bagging) entraîne les modèles sur des jeux de données rééchantillonnés et les moyenne. Un arbre de décision présente une haute variance, ce qui en fait un candidat naturel au bagging.
Les forêts aléatoires ajoutent une sélection aléatoire de caractéristiques lors des scissions, réduisant la corrélation entre les arbres. Les exemples hors‑bag (out‑of‑bag) peuvent estimer la performance, mais un jeu de test final non exploité reste précieux pour la sélection de modèle et les affirmations de déploiement.
Boosting
Le boosting construit un modèle additif en plusieurs étapes. Les apprenants ultérieurs se concentrent sur les exemples ou les résidus que l’ensemble actuel gère mal. AdaBoost modifie les poids des exemples ; le gradient boosting ajuste les apprenants aux gradients négatifs d’une fonction de perte choisie.
Les arbres boostés peuvent modéliser des relations tabulaires complexes, mais des arbres profonds, un nombre excessif de rounds et des fuites peuvent encore sur‑ajuster. Le taux d’apprentissage, la profondeur des arbres, le sous‑échantillonnage et l’arrêt précoce sont des paramètres clés.
Stacking et blending
Le stacking crée un modèle de second niveau qui apprend à combiner les prédictions de base. Pour éviter les fuites, chaque ligne d’entraînement du méta‑modèle doit provenir d’un modèle de base qui n’a pas été entraîné sur cette ligne. La validation croisée génère ces prédictions hors‑pli.
Le blending utilise un jeu de validation distinct pour le méta‑modèle, ce qui est plus simple mais réduit les données disponibles pour l’entraînement. Les deux approches exigent le même pré‑traitement et le même contrôle de version lors de l’inférence.
Compromis opérationnels
Un ensemble peut multiplier la mémoire, la puissance de calcul et les modes de défaillance. Il peut être plus difficile à expliquer, à calibrer et à mettre à jour de façon cohérente. La distillation peut compresser un ensemble en un modèle plus petit, mais l’étudiant doit être évalué de manière indépendante.
Une sélection pratique compare la performance, la latence maximale, la calibration, l’utilisation des ressources et le coût des erreurs. Parfois, un modèle bien régularisé est préférable à un gain de précision marginal provenant d’une pile fragile.
Pourquoi les ensembles fonctionnent
L’apprentissage par ensembles combine plusieurs modèles de sorte que leurs erreurs s’annulent partiellement ou que leurs points forts couvrent différentes zones. Le bagging entraîne les modèles sur des données rééchantillonnées et moyenne les prédictions, réduisant ainsi la variance ; les forêts aléatoires ajoutent une sélection aléatoire de caractéristiques pour dés‑corréler les arbres. Le boosting entraîne les apprenants séquentiellement afin de se concentrer sur les résidus, réduisant souvent le biais mais augmentant la sensibilité au bruit et aux réglages. Le stacking entraîne un méta‑modèle sur les prédictions des modèles de base. La diversité doit être utile : la moyenne de modèles identiques ajoute du coût sans réelle réduction d’erreur.
La corrélation entre les erreurs détermine le bénéfice. La diversité peut provenir d’échantillons de données, de caractéristiques, d’algorithmes, d’hyperparamètres, d’initialisations aléatoires ou de fenêtres temporelles. Le vote dur élimine la confiance ; le vote doux moyenne les probabilités mais nécessite une calibration compatible. La régression peut être moyennée ou utiliser une agrégation robuste. En stacking, les prédictions hors‑pli sont essentielles — entraîner le méta‑modèle sur des prédictions de base provenant des mêmes données d’ajustement entraîne une fuite. Conservez une base de moyenne simple avant d’adopter un combineur complexe.
Évaluation, calibration et incertitude
Comparez chaque membre et l’ensemble sur un jeu de validation avec le même pré‑traitement. Rapportez les métriques de tâche, la calibration, les erreurs par sous‑groupe, la variance entre les plis ou les graines, ainsi que le coût des ressources. Un ensemble peut améliorer la qualité moyenne tout en masquant un point aveugle partagé dû à des données ou des étiquettes communes. Inspectez le désaccord : il peut révéler une incertitude, mais des modèles erronés mais confiants et corrélés peuvent être d’accord. Calibrez l’ensemble final, pas seulement les membres, et validez les seuils d’abstention en fonction de la capacité de révision et des conséquences.
Les estimations hors‑bag sont utiles pour les modèles baggés mais ne remplacent pas un test final représentatif du déploiement. Pour des données temporelles, évitez le rééchantillonnage qui rompt l’ordre. Pour les usages liés à la sécurité, testez les défaillances des membres, les modèles obsolètes et les entrées adversariales. Les ensembles pondérés peuvent sur‑ajuster les données de validation lorsqu’un grand nombre de candidats est testé. Enregistrez la sélection des candidats et utilisez une validation imbriquée lorsque le réglage est intensif.
Déploiement et maintenance
Les ensembles multiplient la mémoire, la latence, la consommation d’énergie et les dépendances opérationnelles. La distillation peut compresser le comportement combiné en un seul modèle, avec une nouvelle exigence de validation. Versionnez les membres, le pré‑traitement, les poids et le routage comme un seul artefact ; définissez le comportement lorsqu’un membre dépasse le délai ou produit un résultat invalide. Surveillez les prédictions des membres et le désaccord afin que les pannes silencieuses soient visibles. Retirez les membres redondants et réentraîner délibérément. Les ensembles améliorent les prédictions lorsque la diversité des erreurs est réelle, mais ils ne transforment pas des données d’entraînement biaisées ou une cible invalide en preuve fiable.
Exemple pratique: un ensemble pour les alertes météo sévères
Une équipe de prévision combine un jeu de caractéristiques de modèle physique, un arbre à gradient boosté, un modèle de séquence neuronale et une base statistique calibrée. Les prédictions hors‑pli entraînent un méta‑modèle simple, et l’évaluation utilise des tempêtes futures entièrement exclues de l’entraînement des membres. Les métriques comprennent le rappel d’événement, les fausses alertes, le temps d’avance, la calibration, la performance géographique et la fiabilité lors de conditions extrêmes rares. La corrélation des erreurs des membres est étudiée car des données d’entrée partagées peuvent créer des points aveugles communs.
Le déploiement conserve chaque prédiction ainsi que le résultat combiné. Si un membre est indisponible, le système utilise une configuration dégradée pré‑validée plutôt que de renormaliser silencieusement. Le désaccord déclenche une revue supplémentaire mais n’est pas systématiquement traité comme une incertitude. La surveillance suit la dérive des membres, la latence et les résultats des tempêtes, les poids n’étant mis à jour que via une validation contrôlée. Les alertes publiques restent soumises aux processus décisionnels météorologiques autorisés ; l’ensemble améliore les preuves mais ne redéfinit pas de façon autonome la politique d’alerte.
Preuves d’implémentation et disponibilité opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le responsable et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant le réglage. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement à la calibration ou à l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et chaque seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer la preuve d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sûre et vérifiez la surveillance avec des pannes intentionnellement injectées. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés, sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Une forêt aléatoire est‑elle un ensemble ?
Oui. Elle combine de nombreux arbres de décision aléatoires, généralement par vote ou moyenne.
Des modèles identiques peuvent‑ils former un ensemble utile ?
Ils le peuvent si les données d’entraînement, l’initialisation ou l’échantillonnage génèrent des erreurs suffisamment différentes, mais une simple duplication n’apporte aucun avantage.
Références principales












