Fondamentaux de l’IA
Qu’est‑ce que la réduction de dimensionnalité ?

 Ajouter Unite.AI à vos sources préférées sur Google
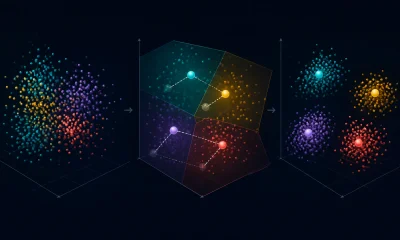
Réduction de dimensionnalité représente les données avec moins de variables tout en préservant les informations utiles à une tâche. Elle peut réduire le stockage et le bruit, améliorer la visualisation, atténuer les caractéristiques redondantes et faciliter l’entraînement des modèles en aval.
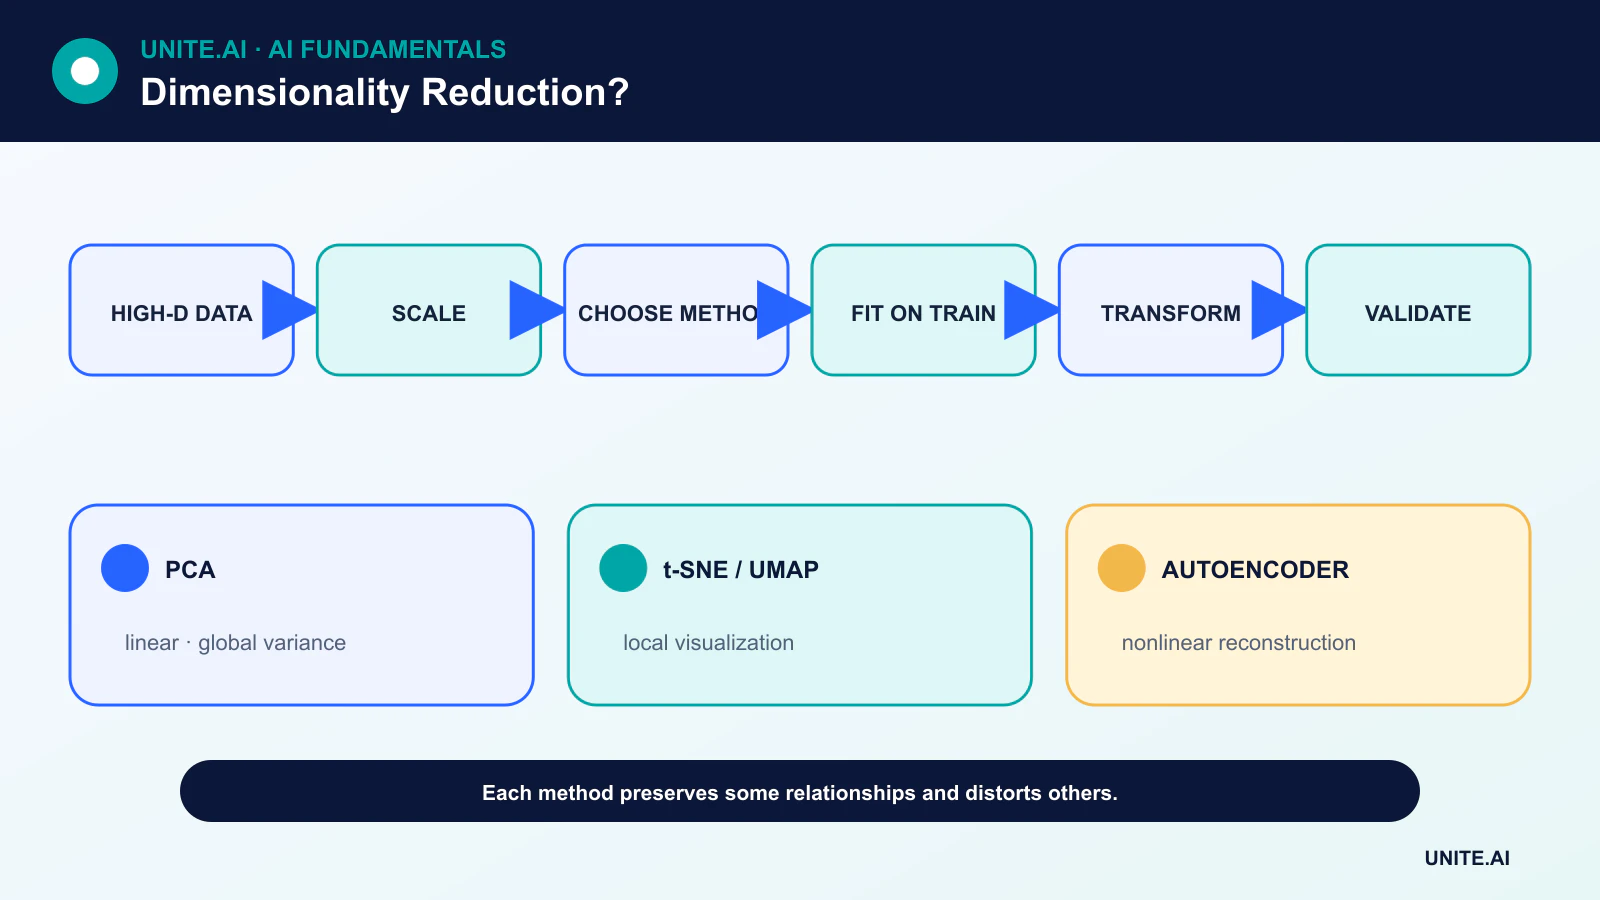
Aucune méthode ne préserve toutes les relations. Une réduction utile commence par définir ce qui doit être conservé: la variance, la séparation des classes, les voisinages locaux, la géométrie globale, la qualité de reconstruction ou l’interprétabilité.
Points clés
- La sélection de variables conserve les variables originales ; l’extraction de caractéristiques crée de nouvelles coordonnées de dimension inférieure.
- L’ACP est linéaire et axée sur la variance ; t‑SNE et UMAP mettent l’accent sur la structure de voisinage pour la visualisation.
- Les plongements de visualisation peuvent déformer les distances, les tailles de clusters et la séparation globale.
- Entraînez la réduction uniquement sur les données d’entraînement, puis appliquez la transformation apprise aux données de validation et de test.
Sélection de variables vs projection
La sélection de variables élimine des variables en s’appuyant sur des règles métier, l’absence de données, la redondance, des tests prédictifs ou la régularisation. Elle conserve les significations originales, ce qui peut faciliter la gouvernance et l’explication.
Les méthodes de projection combinent les variables en de nouvelles coordonnées. Elles peuvent saisir une structure distribuée mais chaque coordonnée peut être plus difficile à interpréter. Un auto‑encodeur apprend une projection non linéaire via la reconstruction.
ACP et SVD
L’analyse en composantes principales identifie des directions orthogonales de variance décroissante après centrage des données. La décomposition en valeurs singulières offre une voie numérique commune. L’échelle est importante: une unité de mesure à haute variance peut dominer les composantes.
L’ACP est déterministe à l’exception du signe et des valeurs propres répétées, prend en charge la transformation hors‑échantillon et fournit des résumés de variance expliquée. Une variance élevée n’est pas toujours pertinente pour la tâche, et les composantes linéaires ne peuvent pas dérouler chaque variété courbée.
t‑SNE et UMAP
t‑SNE construit des distributions de probabilité sur les voisins et optimise une carte de faible dimension qui met l’accent sur la similarité locale. UMAP construit un graphe de voisinage pondéré et optimise une représentation de dimension inférieure avec des objectifs liés à la structure locale.
Les deux sont de puissants outils exploratoires mais sont sensibles au prétraitement, à la métrique de distance et aux hyperparamètres. L’espace vide, la surface d’un cluster et la distance inter‑clusters dans un tracé 2D ne doivent pas automatiquement recevoir une interprétation du monde réel.
Méthodes supervisées et représentations conscientes de la tâche
L’analyse discriminante linéaire utilise les étiquettes de classe pour rechercher la séparation, ce qui la différencie de l’ACP non supervisée. L’apprentissage de représentations neuronales peut optimiser des objectifs de prédiction ou contrastifs au lieu de la reconstruction.
Si les étiquettes guident la réduction, tout ajustement et réglage doivent rester à l’intérieur du processus d’entraînement. Sinon, des informations provenant de l’ensemble de test peuvent fuir vers la sélection du modèle et engendrer un résultat optimiste.
Choisir et valider une méthode
Commencez par le prétraitement et une base simple. Pour la compression, mesurez la reconstruction ou la performance en aval selon les dimensions. Pour la visualisation, testez la stabilité selon les graines et les hyperparamètres et comparez la préservation du voisinage avec les connaissances métier.
En production, demandez si la méthode peut transformer de nouveaux enregistrements, comment elle gère les valeurs manquantes, si elle change lors d’un ré‑entraînement et si les utilisateurs ont besoin d’explications sur les caractéristiques originales. Le surapprentissage peut survenir à l’étape de réduction tout comme dans le modèle final.
Méthodes de réduction linéaires et non linéaires
La réduction de dimensionnalité projette des données à haute dimensionnalité vers moins de coordonnées tout en préservant la structure sélectionnée. L’analyse en composantes principales trouve des directions orthogonales de variance maximale après centrage ; l’échelle est nécessaire lorsque les unités doivent contribuer de manière comparable. La décomposition en valeurs singulières calcule une structure de rang faible associée et prend en charge les matrices creuses. L’analyse discriminante linéaire utilise les étiquettes pour trouver des directions séparant les classes. Ces méthodes fournissent des transformations explicites, mais la variance ou la séparation des classes ne garantit pas la préservation de l’information requise pour une tâche en aval.
Les méthodes de variété comme t‑SNE et UMAP construisent des voisinages et optimisent une disposition de faible dimension. Elles sont puissantes pour l’exploration mais déforment la distance globale, la densité, la taille des clusters et parfois la séparation. Les résultats dépendent du prétraitement, de la métrique, du nombre de voisins ou de la perplexité, de l’initialisation et de la graine. Un cluster attrayant en deux dimensions peut apparaître même sans groupes discrets. Utilisez plusieurs réglages, colorez uniquement selon des métadonnées non utilisées lors de l’ajustement, et validez la structure apparente dans l’espace original ou avec des étiquettes indépendantes.
Sélection de variables, plongements et évaluation
La sélection de variables conserve les variables originales via des filtres, des wrappers ou l’importance basée sur le modèle ; l’apprentissage de représentations crée de nouvelles caractéristiques latentes à l’aide d’auto‑encodeurs ou de modèles supervisés. Les projections aléatoires préservent approximativement les distances sous certaines conditions et offrent des bases efficaces. Choisissez la méthode selon la compression, la visualisation, la réduction du bruit, la vitesse, le stockage ou la performance du modèle. Entraînez le réducteur uniquement sur les données d’entraînement, puis transformez les ensembles de validation et de test. La réduction supervisée doit être imbriquée dans la validation croisée afin d’éviter les fuites d’étiquettes.
Évaluez la variance expliquée ou la reconstruction pour la compression linéaire, la fiabilité et la préservation du voisinage pour la visualisation, ainsi que la précision, la calibration, la latence et la robustesse en aval pour la prédiction. Mesurez la stabilité selon les échantillons et les graines. Vérifiez si les classes rares ou les groupes sensibles sont fusionnés et si la cartographie inverse est possible. Les coordonnées réduites peuvent encore contenir des informations privées ; un tracé bidimensionnel n’est pas une anonymisation. Documentez la transformation, le normaliseur, l’ordre des variables et les limites.
Utilisation en production
Le service nécessite la transformation exacte ajustée ainsi que le schéma d’entrée. Surveillez les caractéristiques manquantes, le glissement de gamme, la distribution des scores des composantes, l’erreur de reconstruction et les résultats en aval. Si de nouvelles catégories ou capteurs apparaissent, ré‑entraînez et versionnez l’ensemble du pipeline plutôt que d’ajouter silencieusement des colonnes. La réduction peut améliorer le calcul et débruiter un modèle, mais elle peut aussi éliminer des signaux faibles importants pour des événements rares. Considérez‑la comme une étape de mesure apprise dont les informations conservées et perdues doivent être testées par rapport à la décision.
Exemple pratique: réduction des caractéristiques du comportement client
Un analyste standardise 200 mesures comportementales et ajuste une ACP uniquement sur les clients d’entraînement. La validation croisée choisit le nombre de composantes en fonction de la performance de churn en aval et de la stabilité, et non d’un nuage de points en deux dimensions. Les charges sont examinées pour détecter les sources dominantes et les valeurs manquantes. L’ACP, la sélection de variables, la projection aléatoire et un modèle régularisé non réduit sont comparés en termes de calibration, de latence et de résultats pour les segments de clients rares. Des échantillons répétés testent également si les composantes principales et les conclusions en aval restent stables.
Le pipeline déployé fixe l’ordre des variables, le normaliseur et les composantes et rejette les versions de schéma manquantes. La surveillance suit les distributions des composantes, l’erreur de reconstruction et les résultats en aval. Une visualisation avec des clusters apparents sert à générer des questions, pas à attribuer des personas client. Parce que les composantes latentes codent toujours le comportement, l’accès et la rétention restent contrôlés. Si les définitions sources changent, la transformation complète et le modèle sont reconstruits et validés plutôt que de projeter des données incompatibles dans d’anciennes composantes.
Preuves de mise en œuvre et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement opérationnel, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un jeu d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le glissement de distribution, les pannes de dépendance, les usages abusifs et les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les changements, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également des procédures documentées de récupération, d’apprentissage des incidents, de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
La réduction de dimensionnalité améliore‑t‑elle toujours un modèle ?
Non. Elle peut éliminer des informations prédictives ou compliquer l’interprétation. Comparez avec une base sans réduction sur des données de test.
Des clusters séparés en t‑SNE prouvent‑ils l’existence de vraies classes ?
Non. La carte est une visualisation optimisée des relations de voisinage et peut créer une séparation apparente. Validez les clusters avec des preuves indépendantes.
Références principales