
Fondamentaux de l’IA
Qu’est‑ce que la reconnaissance vocale conversationnelle (CSR) ?

 Ajouter Unite.AI à vos sources préférées sur Google
La reconnaissance vocale conversationnelle (CSR) étend la reconnaissance automatique de la parole au‑delà de la transcription isolée en utilisant le contexte du dialogue, les signaux de prise de parole, les informations sur les intervenants et un traitement à faible latence. L’objectif est de prendre en charge une interaction en temps réel où les mots, le timing, les interruptions et les tours précédents comptent.
Le CSR est une appellation émergente, tant produit que recherche, et non une classe de modèle standardisée unique. Un système performant combine la reconnaissance en flux continu (streaming ASR) avec la détection de fin d’énoncé, la gestion des intervenants, la modélisation linguistique contextuelle, l’état du dialogue et une politique de réponse, puis évalue l’expérience de bout en bout.
Points clés
- La reconnaissance en flux continu émet des hypothèses provisoires et les révise à mesure que davantage d’audio arrive.
- La détection de fin d’énoncé et la prédiction de prise de parole sont distinctes de la précision de transcription.
- L’historique de la conversation et les mots‑clés peuvent améliorer la reconnaissance mais aussi propager les erreurs antérieures.
- Évaluez la latence, les interruptions, les intervenants, les accents, le bruit, la confidentialité et l’accomplissement des tâches — pas uniquement le taux d’erreur de mots.
De l’ASR au dialogue en direct
L’ASR traditionnel convertit l’audio en texte. Un système conversationnel doit décider quand écouter, quand un tour est terminé, si la parole est dirigée vers le système, et comment se remettre d’une transcription ou d’une réponse erronée.
Les modèles en flux traitent les trames de façon incrémentale et génèrent des transcriptions partielles. Une faible latence améliore la réactivité, mais un engagement prématuré peut augmenter les révisions ou les erreurs. L’application nécessite une politique distinguant texte stable et texte provisoire.
Prise de parole, chevauchement et intervenants
La durée du silence à elle seule constitue un signal de fin d’énoncé faible. L’achèvement lexical, la prosodie, le timing, le regard et l’état du dialogue peuvent aider à prédire si une personne garde ou cède la parole. L’interruption (barge‑in) permet à l’utilisateur d’interrompre la parole synthétisée sans perdre le contexte.
Les voix qui se chevauchent et la diarisation restent difficiles. Les systèmes doivent conserver l’incertitude sur l’intervenant, éviter d’attribuer une déclaration à la mauvaise personne et offrir une voie de correction — en particulier pour les enregistrements utilisés dans la santé, la finance ou le domaine juridique.
Reconnaissance contextuelle
Les tours précédents peuvent désambiguïser les noms et les références ; les listes de mots‑clés peuvent orienter la reconnaissance vers les termes du domaine. Les modèles de parole‑langage peuvent encoder le contexte audio et texte dans un cadre de sollicitation ou d’attention partagé.
Le contexte peut également renforcer une transcription antérieure erronée ou divulguer des informations entre les sessions. Limitez l’historique à l’objectif actuel, séparez les métadonnées fiables de la parole de l’utilisateur, et utilisez le contexte de transformeur avec des règles explicites de conservation et d’accès.
Évaluation et déploiement responsable
Rapportez le taux d’erreur de mots en flux continu, la latence du premier jeton et de la finalisation, le taux de révision, les erreurs d’end‑de‑phrase, le succès du barge‑in, l’attribution des intervenants et l’accomplissement des tâches. Testez avec de vrais microphones, du bruit, des accents, le changement de langue, le handicap et la parole émotionnellement chargée.
Les données vocales peuvent identifier ou révéler des informations sensibles. Appliquez le consentement, la minimisation, le chiffrement, les limites de conservation et la révision humaine. Reliez les réponses générées aux contrôles de sécurité des chatbots, car une transcription précise ne rend pas une réponse correcte ou autorisée.
De l’entrée acoustique à l’état conversationnel
Un système de parole conversationnelle capte l’audio, applique un conditionnement du signal, détecte la parole, reconnaît les mots ou unités sémantiques, identifie les intervenants si nécessaire et met à jour l’état du dialogue. Les systèmes en flux continu produisent des hypothèses partielles avant la fin d’une énonciation. Ces hypothèses peuvent évoluer, de sorte que les composants en aval doivent distinguer les résultats provisoires des résultats finaux.
La détection d’activité vocale et la détection de fin d’énoncé décident du moment où la parole commence et où l’utilisateur a terminé. Des seuils de silence fixes échouent avec des locuteurs lents, du bruit de fond et des pauses de réflexion. Les modèles de prise de parole peuvent utiliser les mots, la prosodie, le regard et le contexte du dialogue, mais ils doivent équilibrer la rapidité de réponse avec le risque d’interrompre l’intervenant.
La diarisation répond à la question qui a parlé quand ; la reconnaissance d’intervenant estime l’identité ; la séparation de sources isole les voix qui se chevauchent. Ce sont des tâches différentes avec des risques distincts. Dans les réunions, la santé et le service client, attribuer les bons mots à la bonne personne peut être aussi important que le taux d’erreur de mots de la transcription.
Contexte, chevauchement, émotion et récupération d’interaction
Le contexte conversationnel résout les pronoms, les ellipses, les corrections, les termes du domaine et les références aux tours précédents. Un système peut combiner les preuves acoustiques avec l’historique du dialogue et les connaissances récupérées, mais le contexte antérieur peut également biaiser la reconnaissance vers une attente incorrecte. Conservez les preuves audio et la confiance afin que le contexte ne supprime pas silencieusement l’incertitude.
Le dialogue naturel comprend les rétroactions, les interruptions, les faux départs, les rires, le changement de langue et la parole simultanée. Un agent réactif a besoin d’une gestion du barge‑in : arrêter ou diminuer sa sortie, capter la nouvelle parole de l’utilisateur, décider si l’interruption modifie l’intention, et récupérer sans dupliquer ou perdre une action.
La prosodie et les signaux paralinguistiques peuvent indiquer l’emphase ou l’incertitude, mais déduire l’émotion, la santé ou l’intention à partir de la voix est sujet à erreurs et dépend culturellement. Utilisez ces estimations avec prudence, divulguez‑les le cas échéant, et ne prenez pas de décisions importantes basées sur une étiquette émotionnelle non validée.
Évaluation, confidentialité et conception de production
Le taux d’erreur de mots reste utile, mais l’évaluation conversationnelle doit également mesurer l’attribution des intervenants, la précision des entités, le succès sémantique des tâches, la stabilité des hypothèses partielles, la latence de fin d’énoncé, le succès des interruptions, la récupération et le taux de correction par l’utilisateur. Segmentez par accent, langue, appareil, bruit, chevauchement, style de parole et conditions réseau.
L’architecture en flux continu nécessite des tampons limités, une régulation du flux (back‑pressure), la reconnexion, des numéros de séquence et une finalisation explicite. Séparez les budgets de latence du modèle et du dialogue, tracez chaque étape et testez les réseaux dégradés. Lorsqu’un système déclenche des actions, confirmez l’intention à fort impact et rendez les nouvelles tentatives idempotentes afin que l’audio répété ou les reconnexions ne dupliquent pas les transactions.
La parole contient des informations d’identité, de contenu, d’environnement et de tiers. Minimisez la conservation, chiffrez le transport et le stockage, contrôlez l’accès, définissez la suppression et distinguez l’audio des transcriptions et embeddings dérivés. Fournissez des indicateurs d’enregistrement visibles et des alternatives lorsque le consentement fait défaut. Un modèle local peut réduire le transfert mais nécessite toujours une autorisation et des contrôles de cycle de vie.
Exemple pratique : un agent vocal gérant l’interruption et la correction
Un appelant dit : « Réservez mardi—non, mercredi après‑midi », alors que l’agent commence à répondre après « mardi ». La reconnaissance en flux continu émet des transcriptions partielles évolutives, la détection de fin d’énoncé repère la parole continue, et le barge‑in interrompt la sortie. L’état du dialogue indique que la date précédente est remplacée plutôt que de créer deux demandes. La confirmation d’entité se concentre sur la date et l’heure corrigées, tandis que le système conserve la confiance et les preuves pour l’interprétation finale.
L’architecture sépare la capture audio, la détection de parole, la reconnaissance en flux continu, la gestion des intervenants, la politique de dialogue, l’exécution d’outil et la synthèse. Les numéros de séquence et la finalisation empêchent les résultats partiels tardifs d’écraser la transcription finale. L’outil de réservation accepte une requête structurée, vérifie l’autorisation et la disponibilité, et utilise une clé d’idempotence. Une réservation conséquente est lue et confirmée avant l’exécution ; une reconnexion ne peut pas la répéter silencieusement.
Les tests combinent la précision des mots et des entités avec la latence de fin d’énoncé, le succès des interruptions, la gestion des corrections, l’attribution des intervenants, l’accomplissement des tâches et le taux d’actions dupliquées. Les scénarios couvrent le bruit, le chevauchement, les accents, le changement de langue, la parole lente, les dispositifs d’assistance, les réseaux faibles et les attaques synthétiques. La conservation de l’audio est minimisée et divulguée, les données des tiers sont traitées explicitement, et les utilisateurs peuvent passer au texte ou à un humain. L’intelligence conversationnelle est mesurée par la récupération sûre et le résultat, pas uniquement par la précision de la transcription.
Liste de contrôle de mise en œuvre pratique
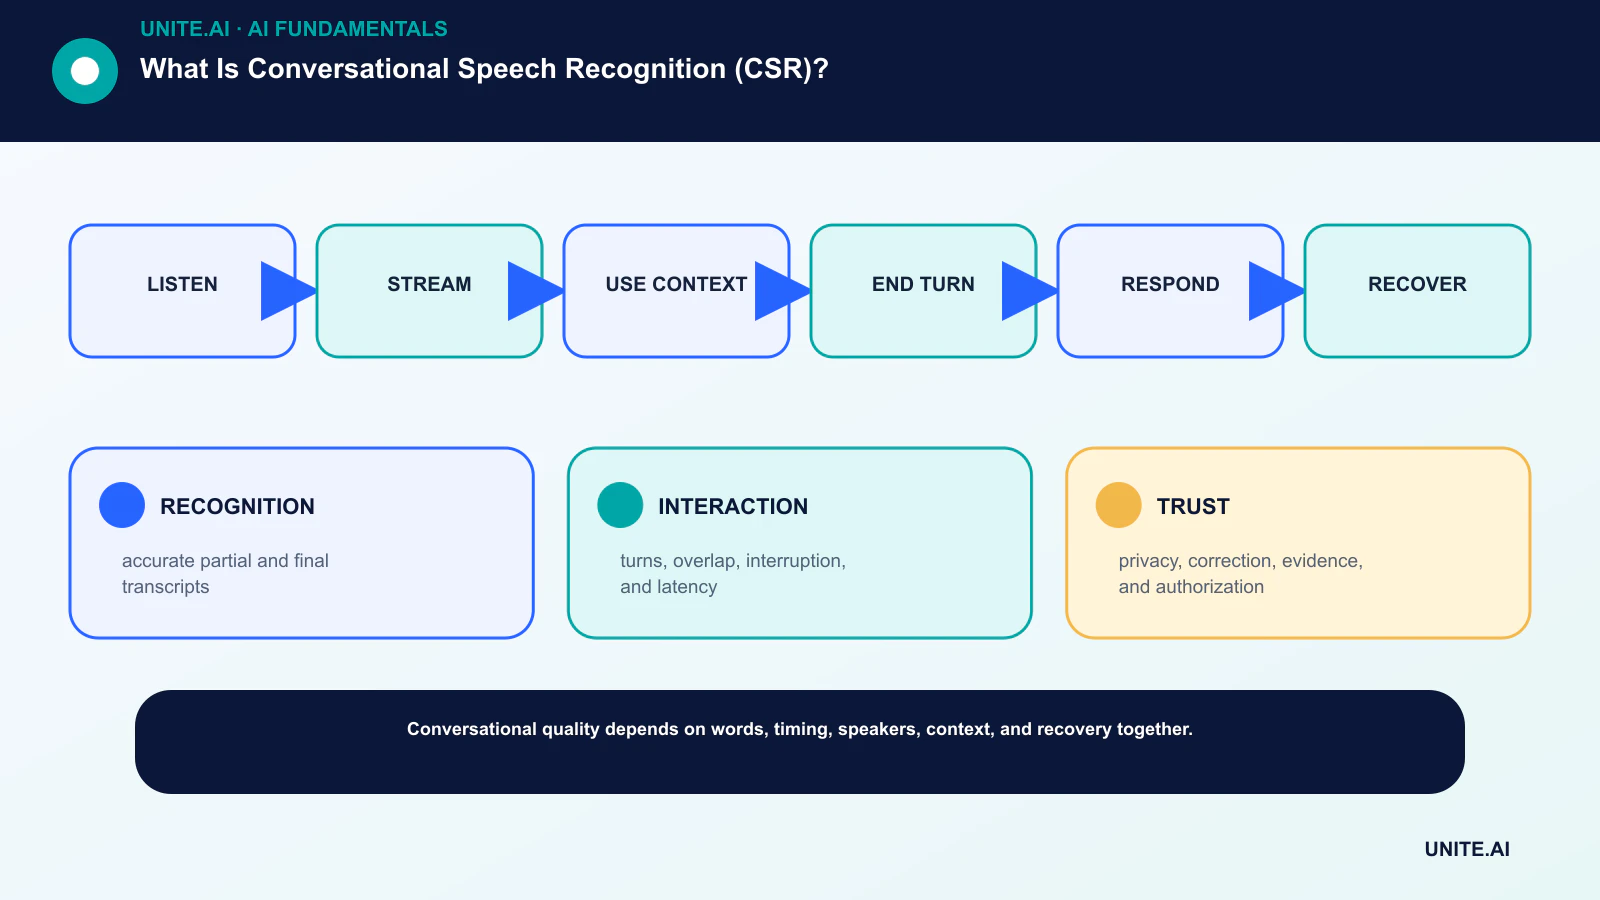
Transformez le concept en un flux de travail limité et testable : écouter → diffuser → utiliser le contexte → terminer le tour → répondre → récupérer. Désignez un responsable imputable, documentez les données et les dépendances, établissez une base simple, définissez des critères d’acceptation et d’arrêt, testez des défaillances représentatives, et définissez la surveillance, le retour en arrière et la révision avant d’élargir le périmètre. Enregistrez les versions et les hypothèses afin qu’une autre équipe puisse reproduire le résultat et comprendre les changements.
Avant le lancement, effectuez une revue de préparation documentée avec les personnes qui conçoivent, exploitent, sécurisent et sont affectées par le système. Testez les cas normaux, les conditions limites, les défaillances de dépendances et les usages abusifs ; conservez les preuves et les risques non résolus. Définissez qui peut approuver la mise en production, modifier un seuil, annuler une sortie ou arrêter le fonctionnement. Reconsidérez la décision après l’arrivée de données réelles, car un pilote techniquement réussi ne garantit pas une performance fiable à plus grande échelle.
- RECONNAISSANCE: transcriptions partielles et finales précises.
- INTERACTION: tours, chevauchement, interruption et latence.
- CONFIANCE: confidentialité, correction, preuves et autorisation.
Foire aux questions
Le CSR est-il différent de l’ASR ?
L’ASR est le composant de conversion parole‑texte. Le CSR utilise l’ASR ainsi que le contexte du dialogue, le timing, la gestion des intervenants et des fins d’énoncé, et des politiques d’interaction pour la conversation en temps réel.
Un taux d’erreur de mots plus bas garantit-il un meilleur agent vocal ?
Non. Un système peut transcrire avec précision tout en interrompant les utilisateurs, en répondant lentement, en attribuant mal les intervenants ou en effectuant la mauvaise action. Des métriques d’interaction de bout en bout sont nécessaires.
Références principales












