
Fondamentaux de l’IA
Qu’est‑ce que la rétropropagation ?

 Ajouter Unite.AI à vos sources préférées sur Google
Backpropagation est l’algorithme utilisé pour calculer comment la perte d’un réseau de neurones varie par rapport à ses paramètres entraînables. Il applique la règle de chaîne du calcul différentiel en sens inverse à travers les opérations enregistrées lors d’un passage avant.
La rétropropagation calcule les gradients ; elle ne décide pas, à elle seule, de la mise à jour. Un optimiseur tel que la descente de gradient stochastique ou AdamW utilise ces gradients pour modifier les poids, les biais et les autres paramètres entraînables.
Points clés
- Le passage avant construit des valeurs intermédiaires et produit une prédiction.
- La fonction de perte convertit la prédiction et la cible en un objectif d’entraînement scalaire.
- La rétropropagation utilise les dérivées locales et la règle de chaîne pour calculer efficacement les gradients des paramètres.
- Les frameworks modernes implémentent la différentiation automatique en mode inverse sur un graphe de calcul.
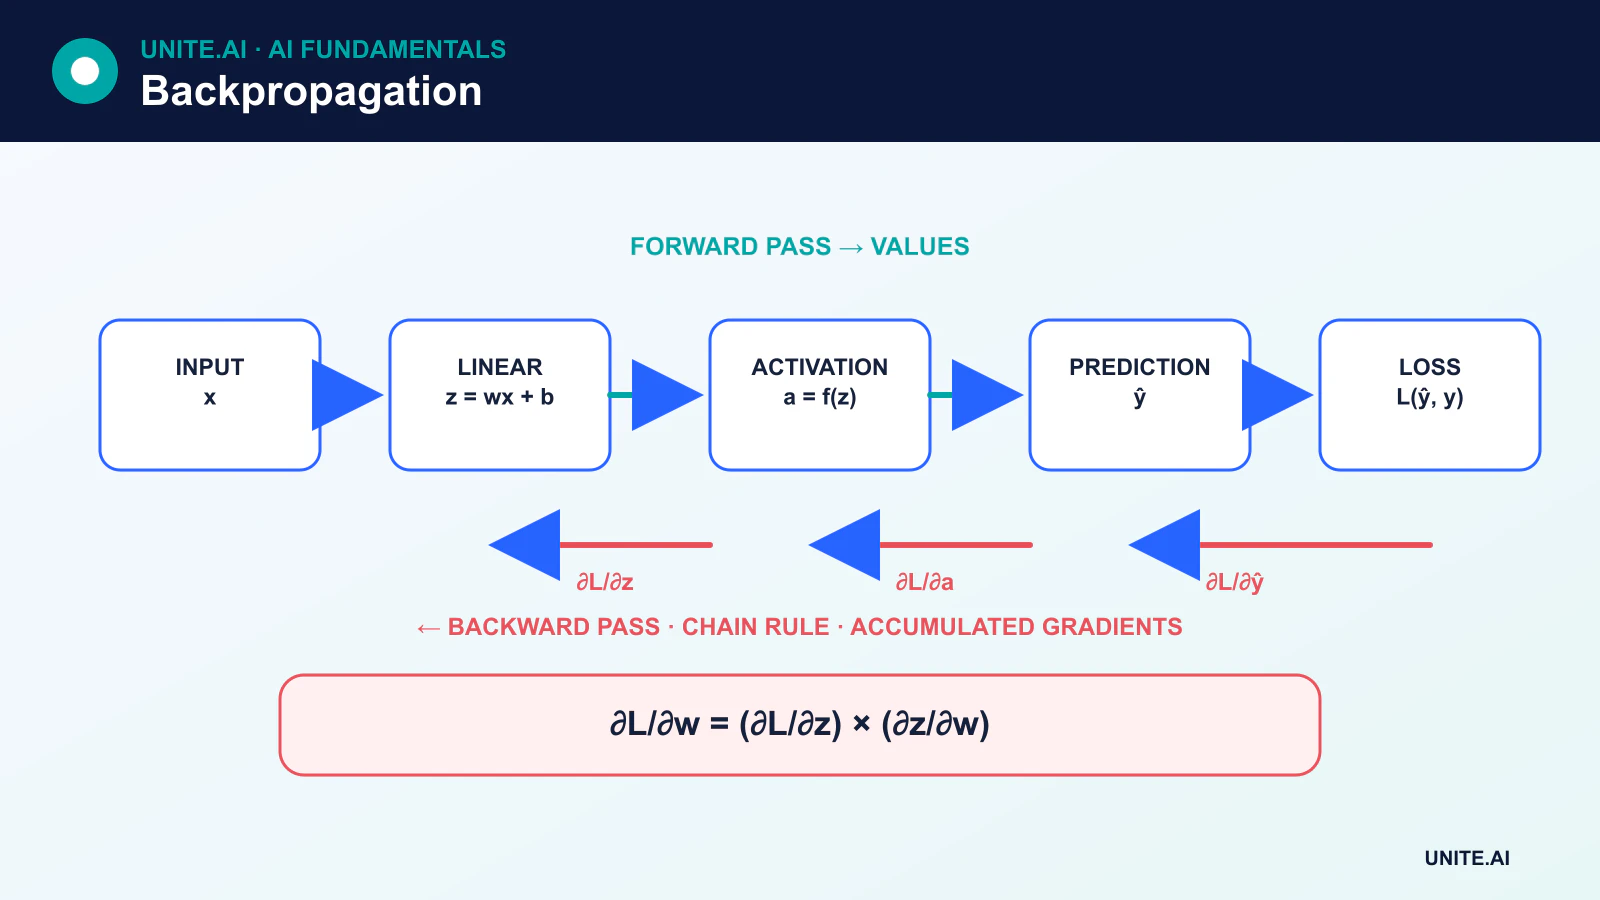
Le passage avant
Considérons une unité simple :
z = wx + bŷ = activation(z)
L’entrée est x, tandis que w et b sont des paramètres de poids et de biais entraînables. Les biais changent généralement pendant l’entraînement tout comme les poids. Un réseau combine de nombreuses opérations de ce type, ainsi que la normalisation, l’attention, les convolutions, les connexions résiduelles ou d’autres blocs différentiables.
Le passage avant évalue ces opérations et produit une prédiction. Une fonction de perte telle que l’entropie croisée ou l’erreur quadratique moyenne mesure l’objectif. La perte optimale dépend de la tâche et de l’interprétation de la sortie.
La règle de chaîne
Si la perte L dépend d’une valeur intermédiaire z, et que z dépend du paramètre w, la règle de chaîne donne :
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Un réseau profond comporte de nombreux chemins. La rétropropagation parcourt le graphe de calcul en sens inverse, accumulant les contributions lorsqu’une valeur influence la perte via plusieurs chemins. Le résultat est un gradient pour chaque paramètre entraînable qui a participé au calcul avant.
Un petit exemple numérique
Supposons ŷ = wx + b, avec x = 2, w = 3 et b = 1. La prédiction est 7. Si la cible est 5 et que la perte est L = ½(ŷ – y)², alors :
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
L’optimiseur peut alors déplacer w et b dans la direction du gradient négatif. Cette formule est spécifique à l’unité linéaire choisie et à la perte d’erreur quadratique ; une règle de rétropropagation universelle est la règle de chaîne appliquée au graphe réel, et non une équation « d’erreur » fixe.
Rétropropagation versus descente de gradient
La descente de gradient est une méthode d’optimisation. La rétropropagation fournit les gradients dont elle a besoin. Une étape d’entraînement suit généralement :
- Effacer ou réinitialiser les gradients stockés.
- Exécuter le passage avant.
- Calculer la perte.
- Exécuter le passage arrière.
- Appliquer la mise à jour de l’optimiseur.
Séparer ces concepts facilite la compréhension du momentum, d’AdamW, de l’accumulation de gradients et de l’entraînement en précision mixte.
Différentiation automatique
Des frameworks tels que PyTorch enregistrent les opérations et construisent un graphe lors du passage avant. La différentiation automatique en mode inverse calcule alors efficacement les produits vecteur‑Jacobien des sorties vers les paramètres. Cela est plus général que de coder manuellement les dérivées pour un réseau fixe et constitue une base des frameworks modernes d’apprentissage profond.
Certaines opérations ne sont pas différentiables ou ont des dérivées instables. Les frameworks définissent des sous‑gradients ou des conventions documentées dans certains cas, mais les praticiens doivent tout de même comprendre les tenseurs détachés, les opérations in‑place et la précision numérique.
Gradients qui disparaissent et qui explosent
La multiplication répétée à travers de nombreuses couches ou étapes temporelles peut rendre les gradients extrêmement petits ou grands. Les gradients qui disparaissent ralentissent l’apprentissage dans les couches précédentes ; les gradients qui explosent déstabilisent les mises à jour. Les activations de la famille ReLU, une initialisation soigneuse, les connexions résiduelles, la normalisation, la récurrence à portes et le clipping de gradient aident, mais aucune n’est une solution universelle.
Vérification des gradients
La vérification des gradients par différences finies compare un gradient analytique ou automatique avec une approximation numérique. Elle est lente mais utile pour déboguer des opérations personnalisées. Le suivi des normes de gradient et la détection de valeurs NaN ou infinies peuvent révéler des instabilités pendant l’entraînement.
La règle de chaîne à travers un graphe de calcul
La rétropropagation calcule efficacement les gradients d’une perte scalaire par rapport à chaque paramètre différentiable. Un passage avant enregistre les valeurs intermédiaires dans un graphe de calcul. En partant de la perte, la différentiation automatique en mode inverse applique la règle de chaîne, multipliant les dérivées locales et accumulant les contributions là où les chemins se rejoignent. Pour une couche y=f(x,w), la sensibilité en amont de y se combine avec les dérivées partielles pour produire les sensibilités de x et w. La rétropropagation calcule les gradients ; l’optimiseur décide comment les paramètres évoluent.
Une couche affine simple produit y=Wx+b. Le gradient de W est le produit extérieur du gradient en amont et de l’entrée, le gradient de b somme les valeurs en amont, et le gradient d’entrée se multiplie par la matrice de poids transposée. Les activations ajoutent des dérivées élémentaires. La convolution, la normalisation, l’attention et la réutilisation récurrente suivent le même principe de graphe mais nécessitent des formes de tenseur correctes, le broadcasting, le masquage et le partage de paramètres. Les frameworks libèrent les activations sauvegardées après le passage arrière sauf si elles sont conservées, de sorte que la mémoire augmente souvent avec la taille du lot, la profondeur et la longueur de la séquence.
Échecs de gradients, vérification et pratique d’ingénierie
Les produits de nombreuses dérivées peuvent disparaître ou exploser. Les activations de type ReLU, une initialisation soigneuse, la normalisation, les connexions résiduelles, le gating et le clipping de gradient traitent différents mécanismes. Les activations saturées et les opérations non différentiables peuvent bloquer des signaux utiles ; la rétropropagation tronquée limite l’historique de la séquence ; la précision mixte peut sous‑déborder sans mise à l’échelle de la perte. Les gradients qui explosent sont un symptôme, de sorte que le clipping doit s’accompagner d’une investigation du taux d’apprentissage, des données, de l’architecture et des erreurs numériques plutôt que de les masquer.
Vérifiez les opérations personnalisées avec des vérifications de gradients par différences finies sur de petites entrées en double précision, en évitant les points non différentiables. Inspectez les normes de gradient, les NaN, les paramètres inactifs, et si les gradients atteignent les modules attendus. Effacez délibérément les gradients accumulés et distinguez le comportement d’entraînement de celui d’évaluation pour le dropout et la normalisation. Le checkpoint recompute les activations pour économiser la mémoire ; l’entraînement distribué doit agréger les gradients de manière cohérente. Une perte d’entraînement décroissante montre qu’un chemin d’optimisation existe, pas que les gradients sont conceptuellement corrects, que les données sont exemptes de fuites, ou que le modèle généralise.
Exemple pratique : vérification d’une couche neuronale personnalisée
Un ingénieur implémente une couche spectrale différentiable pour un réseau audio. Un petit test en double précision compare les gradients automatiques avec les différences finies centrales sur les entrées et les paramètres, en excluant les points où l’opération est intentionnellement non différentiable. La forme, le broadcasting, le padding et la conversion complexe‑vers‑réel reçoivent des cas séparés. Le test vérifie les gradients accumulés lorsqu’un paramètre est réutilisé et confirme que les trames audio masquées ne produisent aucun gradient.
Pendant l’entraînement, les tableaux de bord suivent les normes de gradient et d’activation, les NaN, les paramètres inactifs et la mise à l’échelle de la perte. Un lot délibérément corrompu confirme que la validation intercepte une sortie non finie avant une mise à jour de l’optimiseur. Les implémentations en précision mixte et exportées sont comparées à la référence. Les tests de reprise de checkpoint incluent l’état de l’optimiseur et l’ordre aléatoire. La couche n’est pas acceptée simplement parce que la perte totale diminue ; les gradients unitaires, la stabilité numérique et la généralisation en aval doivent tous fournir des preuves cohérentes.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une base reproductible et un ensemble d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, le décalage de distribution, les pannes de dépendances, les mauvais usages, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise à jour, les exceptions, les changements, le rollback et la retraite. Utilisez un déploiement progressif, conservez une solution de repli sûre et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, la santé des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Foire aux questions
La rétropropagation met‑elle à jour les poids ?
La rétropropagation calcule les gradients. L’optimiseur applique une mise à jour en utilisant ces gradients, son taux d’apprentissage et éventuellement un état tel que le momentum ou des moments adaptatifs.
La rétropropagation est‑elle réaliste sur le plan biologique ?
La rétropropagation standard est un algorithme d’ingénierie et n’est pas acceptée comme modèle détaillé de l’apprentissage dans les cerveaux biologiques. L’analogie neuronale historique ne doit pas être considérée comme une équivalence biologique.
Références principales












