
Fondamentaux de l’IA
Qu’est‑ce qu’un arbre de décision ?

 Ajouter Unite.AI à vos sources préférées sur Google
Un arbre de décision est un modèle d’apprentissage supervisé qui effectue une prédiction en appliquant une séquence de règles si‑alors. Chaque nœud interne teste une caractéristique, chaque branche représente le résultat de ce test, et chaque feuille produit une prédiction de classe, une probabilité ou une valeur numérique.
Les arbres de décision sont utilisés pour la classification et la régression. Leur attrait est pratique: ils peuvent représenter des interactions non linéaires, nécessitent relativement peu de prétraitement et produisent un chemin que l’on peut inspecter. Leur faiblesse est l’instabilité — de petits changements dans les données d’entraînement peuvent engendrer un arbre différent.
Points clés
- Un arbre partitionne récursivement l’espace des caractéristiques; il n’a pas besoin d’isoler chaque observation d’entraînement.
- Les séparations en classification utilisent généralement l’impureté de Gini ou l’entropie, tandis que les séparations en régression réduisent l’erreur de prédiction ou la variance.
- La profondeur, la taille minimale des feuilles et l’élagage contrôlent la complexité et le surapprentissage.
- Les forêts aléatoires et les arbres en gradient boosting améliorent le pouvoir prédictif en combinant de nombreux arbres.
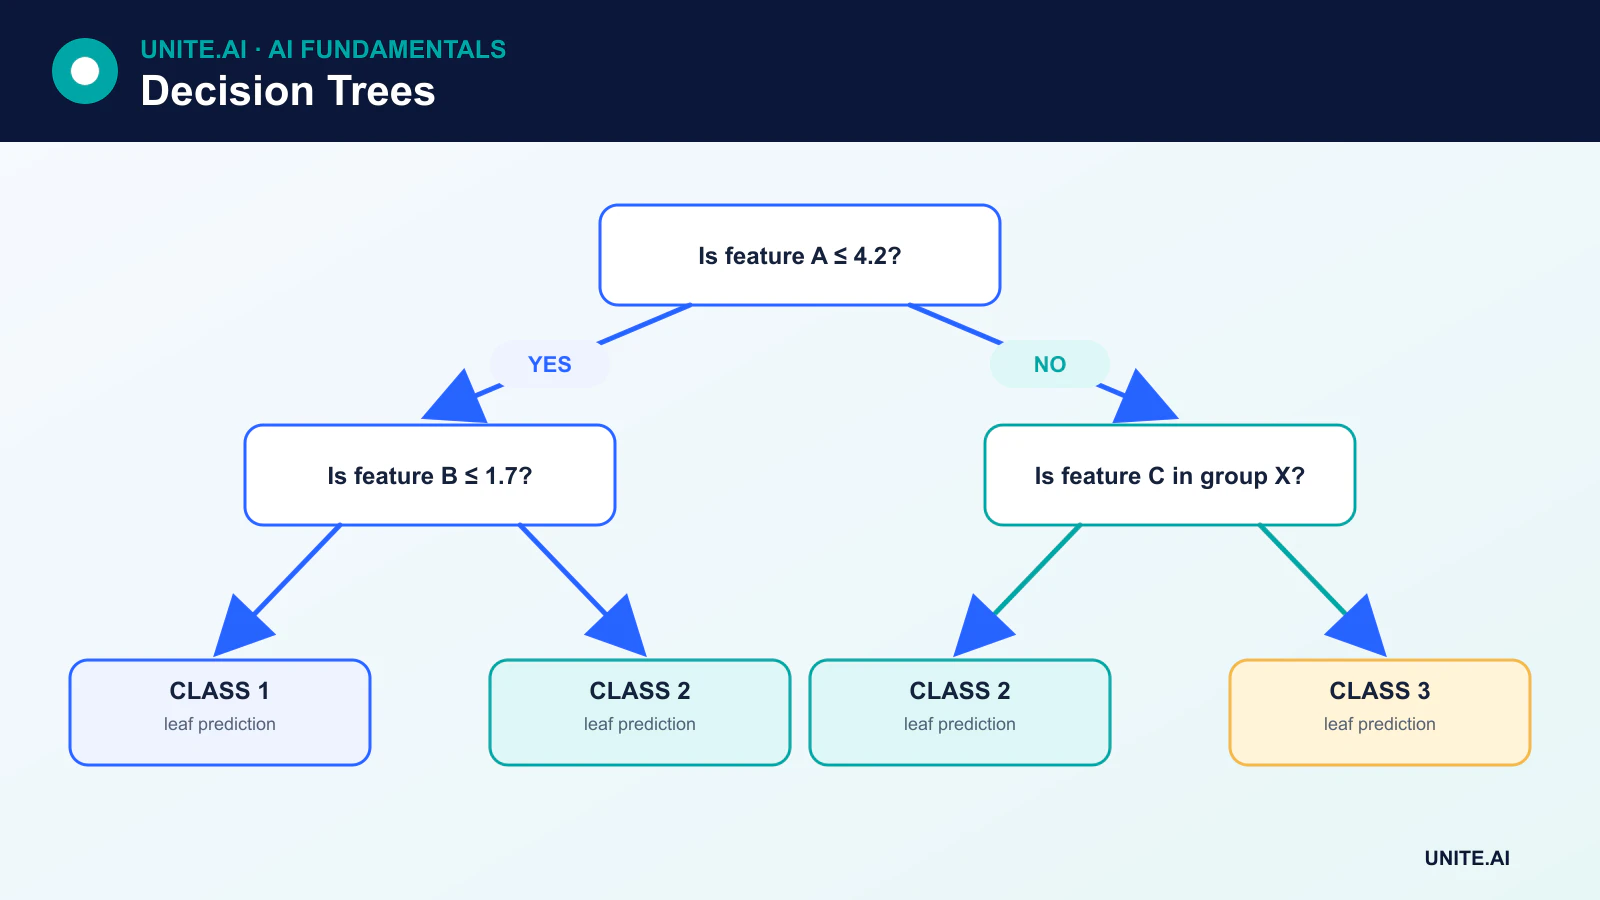
Comment un arbre de décision effectue une prédiction
Supposons qu’un modèle prévoie si une machine est susceptible de tomber en panne. Le nœud racine pourrait demander si la vibration dépasse un seuil appris. Une branche pourrait ensuite tester la température de fonctionnement. L’observation atteint une feuille contenant la probabilité d’échec estimée parmi les exemples d’entraînement qui ont suivi le même chemin.
Pour la régression, la feuille peut renvoyer la valeur cible moyenne des observations dans cette région. Pour la classification, elle peut renvoyer la classe majoritaire ou une distribution des fréquences de classe. Une feuille peut contenir de nombreuses observations; séparer complètement les données d’entraînement est généralement indésirable car cela peut produire un arbre surajusté.
Comment un arbre choisit une division
L’entraînement examine les caractéristiques candidates et les seuils, puis sélectionne la division qui améliore le plus un objectif défini. L’amélioration doit être pondérée par le nombre d’observations qui se dirigent vers chaque nœud enfant.
Impureté de Gini
Pour la classification, l’impureté de Gini mesure le degré de mélange des classes dans un nœud:
Gini = 1 - Σ p(k)²
Un nœud ne contenant qu’une seule classe a une impureté nulle. Une division candidate est utile lorsque l’impureté pondérée de ses enfants est inférieure à celle du nœud parent.
Entropie et gain d’information
L’entropie est une autre mesure de l’incertitude des classes:
Entropy = -Σ p(k) log₂ p(k)
Le gain d’information est l’entropie du parent moins l’entropie pondérée des enfants. Gini et entropie produisent souvent des arbres similaires, bien qu’ils ne soient pas toujours identiques.
Perte de régression
Les arbres de régression choisissent généralement des divisions qui réduisent l’erreur quadratique, l’erreur absolue ou un autre critère de régression. Chaque feuille prédit alors une valeur basée sur les cibles d’entraînement à l’intérieur de cette région.
CART et autres algorithmes d’arbre
CART, ou Classification and Regression Trees, utilise des divisions binaires et sous‑tend les implémentations courantes telles que les arbres de décision de scikit-learn. D’autres algorithmes incluent ID3, C4.5 et C5.0. Les implémentations diffèrent par les types de division pris en charge, la gestion des valeurs manquantes, l’élagage et les objectifs.
Les variables catégorielles peuvent nécessiter un encodage, des divisions de sous‑ensembles directes ou une gestion propre à l’implémentation. Les valeurs manquantes peuvent être imputées ou traitées via des directions par défaut apprises ou des divisions de substitution. Il est important de comprendre le comportement de la bibliothèque spécifique plutôt que de supposer que chaque implémentation d’arbre fonctionne de la même manière.
Contrôler la complexité d’un arbre
Un arbre profond peut mémoriser le bruit. Les contrôles courants incluent:
- Profondeur maximale: limite la longueur d’un chemin de prédiction.
- Nombre minimum d’échantillons par division ou feuille: empêche les régions trop petites.
- Diminution minimale d’impureté: exige qu’une division apporte un bénéfice suffisant.
- Nombre maximal de feuilles: plafonne la complexité totale.
- Élagage coût‑complexité: supprime les branches dont l’amélioration ne justifie pas la complexité supplémentaire.
L’élagage est un processus d’optimisation structuré, et non une suppression aléatoire. Les hyperparamètres doivent être choisis à l’aide de données de validation ou de validation croisée, tandis que l’ensemble de test final reste intact.
Points forts et limites
Les arbres de décision peuvent modéliser des interactions et des effets de seuil sans mise à l’échelle des caractéristiques. Ils acceptent des entrées numériques et, selon l’implémentation, catégorielles. La prédiction est rapide, et un petit arbre est facile à visualiser.
Cependant, un arbre unique peut présenter une variance élevée, créer des changements de prédiction brusques près d’une division, et favoriser les caractéristiques disposant de nombreux points de division possibles. Les arbres extrapolent également mal en régression: en dehors des régions observées, une feuille renvoie toujours une valeur apprise à partir de ses exemples d’entraînement. Un grand arbre peut ne pas être plus compréhensible qu’un autre modèle complexe.
D’un arbre à des ensembles
L’apprentissage ensembliste combine plusieurs modèles. Une forêt aléatoire entraîne de nombreux arbres sur des observations rééchantillonnées et des sous‑ensembles de caractéristiques, puis moyenne leurs prédictions. Le gradient boosting construit les arbres séquentiellement de sorte que chaque nouvel arbre corrige l’erreur résiduelle. Ces approches surpassent généralement un arbre unique, mais elles sacrifient une partie de l’interprétabilité et ajoutent un coût computationnel.
L’importance des caractéristiques d’un arbre ou d’un ensemble doit être interprétée avec prudence. L’importance basée sur l’impureté peut être biaisée, et l’importance d’une caractéristique ne prouve pas la causalité. L’importance par permutation, les outils de dépendance partielle et l’examen du domaine apportent un contexte supplémentaire.
Comment un arbre apprend les divisions et les prédictions
Un arbre de décision partitionne récursivement l’espace des caractéristiques. À chaque nœud, un algorithme d’entraînement évalue les seuils de caractéristiques candidats ou les partitions de catégories et sélectionne une division qui réduit le plus l’impureté, comme l’impureté de Gini ou l’entropie pour la classification et l’erreur quadratique pour la régression. Les feuilles stockent une distribution de classes ou une prédiction numérique basée sur les observations d’entraînement qui les atteignent. La division gourmande est pratiquement efficace mais ne garantit pas l’arbre globalement optimal, et différents échantillons ou critères de départage peuvent produire des structures différentes.
Les caractéristiques continues, ordinales, catégorielles et manquantes nécessitent une gestion explicite. L’encodage one‑hot peut créer de nombreuses divisions candidates; les méthodes catégorielles natives peuvent utiliser des statistiques ordonnées mais requièrent une implémentation à l’abri des fuites. Les arbres n’ont pas besoin de mise à l’échelle, mais ils peuvent favoriser les variables à forte cardinalité et isoler de petits groupes. La profondeur, la taille minimale des feuilles, la diminution minimale d’impureté et l’élagage coût‑complexité contrôlent la variance. Choisissez‑les avec des données de validation et évaluez la calibration, car une probabilité de feuille basée sur peu de cas peut être extrême et instable.
Interprétation, modes d’échec et utilisation en production
Un chemin du nœud racine à la feuille constitue une règle exacte pour une prédiction du modèle, mais ce n’est pas automatiquement une explication causale. Les variables corrélées peuvent se substituer les unes aux autres, de petites modifications des données peuvent modifier les divisions supérieures, et un chemin apparemment simple peut dépendre d’étiquettes biaisées. L’importance globale des caractéristiques basée sur l’impureté peut être trompeuse; l’importance par permutation, la dépendance partielle et les vérifications contre‑factuelles apportent du contexte mais comportent également des hypothèses. Rapportez l’incertitude et testez si une règle supposée tient sur des données indépendantes et des sous‑groupes pertinents.
Les arbres uniques sont utiles lorsque la transparence, la faible latence et une structure non linéaire modeste sont importantes, mais les ensembles offrent généralement une performance prédictive supérieure. Validez le comportement aux limites, les catégories rares, les valeurs manquantes et les entrées hors de la plage d’entraînement. Les règles exportées doivent reproduire exactement le prétraitement d’entraînement et la comparaison numérique. Surveillez l’occupation des feuilles, la distribution des sorties, les erreurs et les catégories émergentes. Un arbre qui dirige de nombreux nouveaux cas vers une région minuscule ou auparavant vide doit déclencher une révision même si le glissement agrégé reste faible. Conservez une solution de secours pour les schémas invalides et documentez chaque décision d’élagage ou de seuil.
Exemple pratique: un arbre de triage de prêt interprétable
Un prêteur utilise un arbre uniquement pour prioriser les demandes incomplètes en vue d’une révision manuelle, et non pour approuver ou refuser le crédit. L’objectif est un résultat de complétude documenté, et les caractéristiques disponibles lors de la saisie excluent les décisions ultérieures. La validation temporelle groupée compare un arbre peu profond élagué avec des règles et une régression logistique. La taille minimale des feuilles empêche les règles basées sur un petit nombre de demandeurs, tandis que la calibration et les erreurs spécifiques à chaque classe sont rapportées à travers les canaux et les groupes protégés pertinents.
Les évaluateurs voient le chemin exact et les valeurs sources mais peuvent corriger les données erronées et annuler le routage. L’organisation teste les proxys corrélés et les changements contre‑factuels, surveille l’occupation des feuilles et les valeurs manquantes, et considère un afflux soudain vers une petite feuille comme un incident de qualité des données. Les changements de politique créent une nouvelle version du modèle et une validation, et non une modification de division non documentée. Parce que l’usage affecte l’accès et la charge, les demandeurs disposent d’un canal humain et l’arbre n’est jamais présenté comme une explication causale de la solvabilité.
Preuves d’implémentation et préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement opérationnel, les entrées, les sorties, les dépendances, le propriétaire et les conséquences de chaque défaillance importante. Établissez une ligne de base reproductible et un ensemble d’évaluation versionné avant l’ajustement. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les changements de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype attrayant.
Avant le lancement, attribuez l’autorité pour la mise en production, les exceptions, les changements, les retours en arrière et la mise hors service. Utilisez un déploiement progressif, conservez une solution de secours sécurisée et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et un responsable de réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que la performance hors ligne persistera. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, un apprentissage des incidents, des procédures de suppression et de conservation, ainsi qu’un point clair où il doit être désactivé ou remplacé.
Références principales












