Fondamentaux de l’IA
Qu’est‑ce que les machines à vecteurs de support ?

 Ajouter Unite.AI à vos sources préférées sur Google
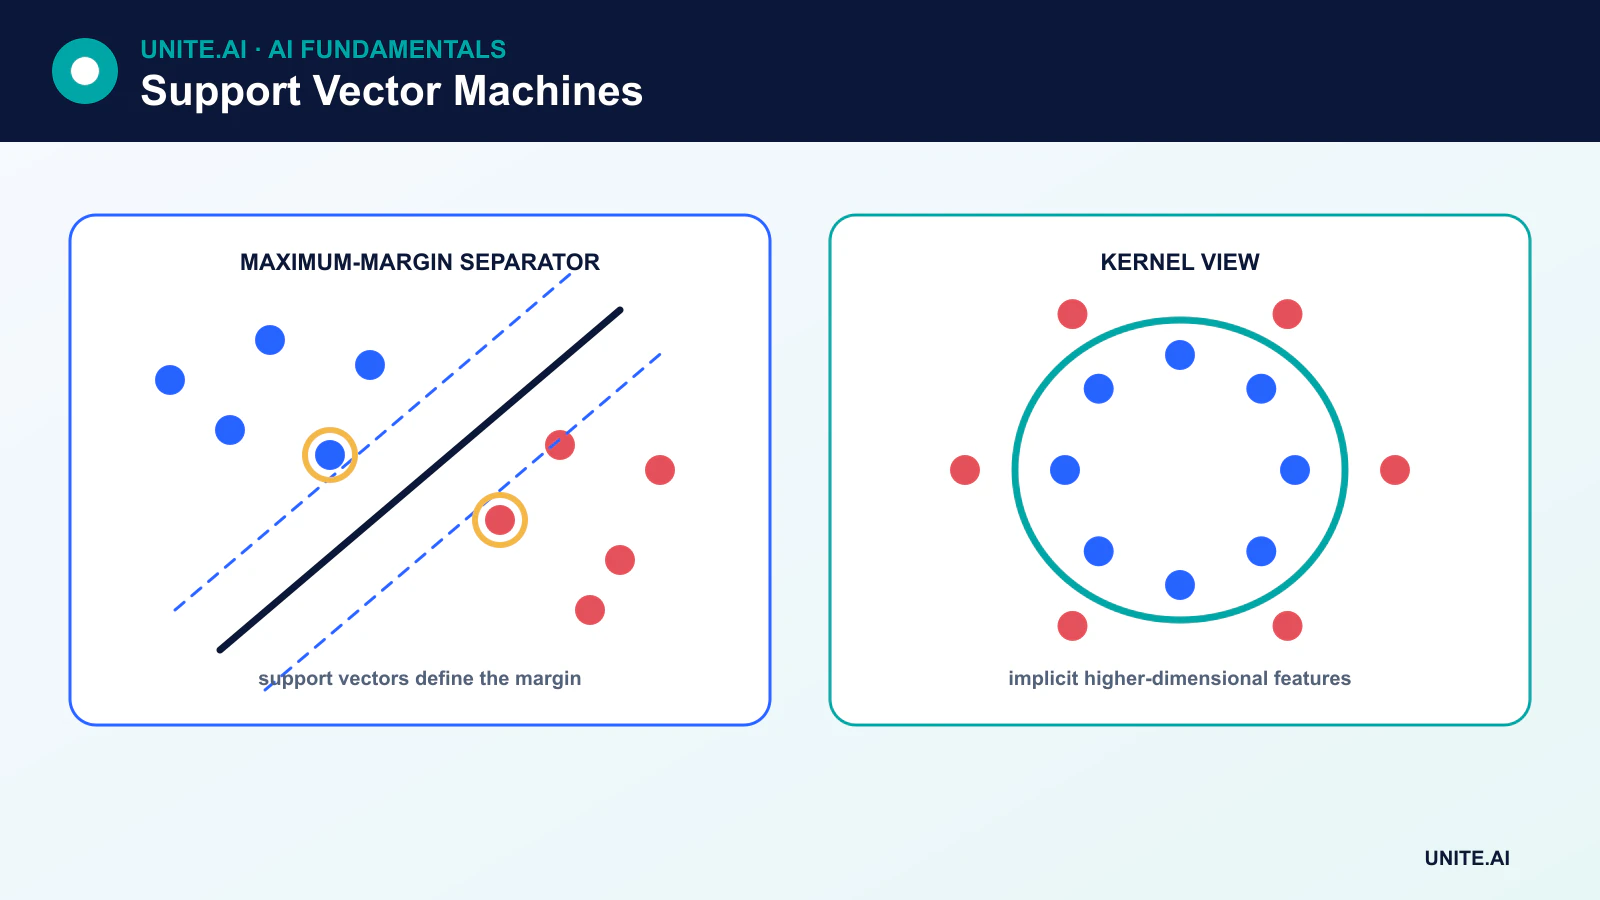
Une machine à vecteurs de support (SVM) est une méthode d’apprentissage supervisé qui trouve une frontière de décision avec la marge la plus large possible entre les classes. Les exemples d’entraînement qui déterminent cette frontière sont les vecteurs de support.
Les SVM peuvent réaliser une classification linéaire ou non linéaire, une régression et une détection de nouveauté. Ils sont particulièrement utiles pour des ensembles de données de petite à moyenne taille avec des caractéristiques informatives, y compris des données à haute dimensionnalité et clairsemées, mais leur coût d’entraînement peut devenir impraticable sur des ensembles de données très volumineux.
Points clés
- Un SVM maximise la marge minimale entre la frontière et les points d’entraînement les plus proches.
- Les vecteurs de support sont des points de données, et non des hyperplans supplémentaires.
- Le paramètre C équilibre la largeur de la marge avec les pénalités pour les violations.
- Les noyaux calculent la similarité dans un espace de caractéristiques implicite sans matérialiser explicitement chaque caractéristique transformée.
L’idée de marge maximale
Pour un classificateur binaire linéaire, la frontière de décision est un hyperplan :
w · x + b = 0
Le vecteur w détermine l’orientation et b le décalage. De nombreux hyperplans peuvent séparer les classes d’entraînement. Le SVM choisit celui qui maximise la distance aux exemples les plus proches de chaque côté. Ces exemples les plus proches sont les vecteurs de support et exercent la plus grande influence sur la frontière ajustée.
L’objectif n’est pas de maximiser la distance entre la frontière et chaque point individuellement. Il maximise la marge minimale tout en respectant ou en pénalisant les contraintes de classe.
Marges dures et souples
Un SVM à marge dure nécessite une séparation linéaire parfaite et est sensible aux valeurs aberrantes. Les jeux de données réels nécessitent généralement une marge souple, qui introduit des variables d’écart pour les observations situées à l’intérieur de la marge ou du mauvais côté de la frontière.
L’hyperparamètre C contrôle la pénalité pour ces violations :
- Un C plus grand pénalise les violations plus fortement et produit souvent une marge plus étroite qui suit les exemples d’entraînement de plus près.
- Un C plus petit autorise davantage de violations en échange d’une marge plus large et plus régularisée.
Le nombre de vecteurs de support résulte des données et de la solution ; augmenter C ne garantit pas un nombre particulier de vecteurs de support.
L’astuce du noyau
Certaines classes ne peuvent pas être séparées par un hyperplan droit dans l’espace de caractéristiques d’origine. Un noyau évalue un produit scalaire correspondant à un autre espace de caractéristiques. Cela permet au SVM d’ajuster une frontière non linéaire sans calculer explicitement chaque coordonnée transformée.
Les noyaux courants comprennent :
- Linéaire : efficace pour des caractéristiques clairsemées à haute dimensionnalité comme le texte.
- Polynomial : modélise les interactions jusqu’à un degré choisi.
- Fonction de base radiale (RBF) : crée des frontières locales flexibles basées sur la distance.
- Sigmoïde : ressemble à une activation neuronale mais est moins souvent le choix par défaut.
Pour un SVM RBF, gamma contrôle le degré de localisation de l’influence de chaque exemple d’entraînement sur la frontière. Un gamma élevé peut créer des régions très détaillées et entraîner un surapprentissage ; un gamma faible produit une influence plus lisse.
Classification multiclasse
L’objectif classique du SVM est binaire. Les bibliothèques l’étendent en utilisant des stratégies telles que un‑vs‑rest (un‑vs‑tous), qui entraîne un classificateur par classe, ou un‑vs‑un, qui entraîne des classificateurs pour chaque paire de classes et combine leurs décisions. Les SVM multiclasse ne tracent pas simplement une ligne de moins que le nombre de classes.
Régression à vecteur de support et SVM à une classe
La régression à vecteur de support (SVR) ajuste une fonction tout en ignorant les erreurs à l’intérieur d’un tube de largeur epsilon et en pénalisant les écarts plus importants. Un SVM à une classe estime une frontière autour des données typiques et peut prendre en charge la détection de nouveauté. Un point inhabituel n’est pas automatiquement une fraude ou une défaillance ; il est simplement inhabituel selon la représentation ajustée.
Exigences pratiques
Les SVM reposent sur les distances et les produits scalaires, de sorte que les caractéristiques numériques nécessitent généralement une mise à l’échelle. C, le noyau, gamma et les poids de classe doivent être choisis via une validation. Les estimations de probabilité ne sont pas inhérentes à la marge et nécessitent souvent une calibration, ce qui ajoute un coût et doit être évalué séparément.
L’entraînement d’un SVM à noyau peut évoluer entre un temps quadratique et cubique en fonction du nombre d’échantillons, selon les données et l’implémentation. Les variantes de SVM linéaire ou les modèles linéaires stochastiques conviennent mieux aux ensembles de données très volumineux. Pour les images brutes, l’audio ou le texte, des représentations apprises par deep learning peuvent être plus efficaces, tandis qu’un SVM peut toujours classer un embedding fixe.
Points forts et limites des SVM
Les SVM peuvent bien fonctionner avec de nombreuses caractéristiques, offrent un objectif régularisé clair et dépendent principalement des vecteurs de support lors de la prédiction. Les limites incluent la sensibilité à la mise à l’échelle et aux hyperparamètres, un entraînement potentiellement coûteux, une interprétabilité réduite avec les noyaux non linéaires, et les exigences de calibration des probabilités.
Marges, noyaux et objectif d’optimisation
Une machine à vecteurs de support recherche un hyperplan séparateur avec une grande marge entre les classes. Seuls les vecteurs de support situés sur la marge ou à l’intérieur de celle-ci déterminent la frontière. Les SVM à marge souple introduisent des variables d’écart pour les chevauchements et les points mal étiquetés ; le paramètre C échange une marge plus large contre les violations d’entraînement. Les entrées doivent généralement être mises à l’échelle car la distance et les produits scalaires pilotent la solution. Les poids de classe ou le rééchantillonnage aident lorsque les coûts d’erreur et la prévalence sont inégaux, mais les seuils et les probabilités nécessitent encore une validation indépendante.
L’astuce du noyau évalue la similarité comme si les entrées étaient projetées dans un espace de caractéristiques de dimension supérieure. Les noyaux linéaire, polynomial, à base radiale et spécialisés codent différentes hypothèses. Pour un noyau RBF, gamma contrôle la localisation de l’influence de chaque point sur la frontière : un gamma élevé peut créer des régions complexes et surapprendre, tandis qu’un gamma faible peut sous‑apprendre. Les matrices de noyau croissent de façon quadratique avec le nombre d’échantillons, rendant les SVM non linéaires coûteux sur de grands ensembles de données. Les solveurs linéaires ou les cartes de caractéristiques approximatives sont souvent préférables à grande échelle.
Utilisation multiclasse, calibration et limites opérationnelles
Les SVM binaires s’étendent au multiclasse via un‑vs‑rest, un‑vs‑un ou des formulations structurées. Les hyperparamètres doivent être réglés à l’intérieur d’une validation croisée, avec des découpages groupés ou temporels si nécessaire. Évaluez la précision et le rappel spécifiques à chaque classe, les distributions de marge, la calibration et les performances sous dérive. Les scores de décision bruts ne sont pas des probabilités ; le redimensionnement de Platt ou la calibration isotone utilisent des données séparées et peuvent se détériorer si la prévalence change. Comparez avec la régression logistique, les arbres et les méthodes modernes basées sur les représentations, avec un prétraitement et un réglage équivalents.
Le déploiement nécessite le même scaler, l’ordre des caractéristiques, les paramètres du noyau, les vecteurs de support et le mappage des classes. Le coût de prédiction d’un SVM à noyau augmente avec le nombre de vecteurs de support, il faut donc mesurer la latence et la mémoire sur des lots réalistes. Des entrées éloignées du support d’entraînement peuvent encore recevoir des étiquettes confiantes ; ajoutez des contrôles hors distribution ou une politique d’abstention le cas échéant. Examinez les erreurs pour détecter des proxys sensibles et des artefacts de jeu de données. Les SVM restent performants pour des problèmes de taille moyenne et à haute dimensionnalité, mais une marge géométrique maximale ne prouve pas une structure causale ou une sécurité.
Exemple pratique : un SVM pour le routage de documents rares
Une équipe d’opérations juridiques classe de courts dépôts dans des catégories de routage en utilisant des caractéristiques TF–IDF et un SVM linéaire. Elle sépare par affaire et par période pour éviter les fuites de modèles, ajuste les poids de classe en fonction du coût d’erreur revu, et règle C dans une validation imbriquée. Le modèle linéaire est comparé à la régression logistique et à un transformeur. La précision, le rappel, la calibration et la charge de travail des réviseurs par classe comptent davantage que la précision globale.
Les scores de décision sont calibrés sur des données séparées, et les documents à faible marge ou en langue non prise en charge sont dirigés vers la saisie manuelle. L’artefact de déploiement comprend le tokenizer, le vocabulaire, le pondération, le modèle, la calibration et la cartographie des étiquettes. La surveillance suit les nouveaux termes, la prévalence des catégories, les marges et les itinéraires corrigés. Les documents et les vecteurs de support sont protégés car les caractéristiques textuelles peuvent divulguer des informations confidentielles. Un noyau non linéaire est rejeté lorsque son faible gain de qualité ne peut justifier le coût de latence, de mémoire et d’interprétabilité.
Preuves de mise en œuvre et état de préparation opérationnelle
Une décision de production nécessite plus qu’une démonstration réussie. Définissez les utilisateurs visés, l’environnement d’exploitation, les entrées, les sorties, les dépendances, le responsable et les conséquences de chaque défaillance importante. Établissez une base de référence reproductible et un jeu d’évaluation versionné avant l’optimisation. Testez les cas ordinaires, les conditions limites, les entrées malformées ou manquantes, les dérives de distribution, les pannes de dépendances, les usages abusifs, ainsi que les groupes ou environnements les plus susceptibles d’être sous‑servis. Mesurez la qualité de la tâche conjointement avec la calibration ou l’incertitude, la latence, le débit, le coût des ressources, l’accessibilité, la confidentialité et la sécurité. Enregistrez chaque transformation et seuil afin qu’un évaluateur indépendant puisse reproduire le résultat et distinguer les preuves d’un prototype séduisant.
Avant le lancement, attribuez l’autorité pour la publication, les exceptions, les modifications, le retour en arrière et la mise hors service. Utilisez un déploiement progressif, conservez un repli sûr et vérifiez la surveillance avec des pannes injectées délibérément. La télémétrie opérationnelle doit révéler la qualité des entrées, le comportement des sorties, la version du modèle ou de la règle, l’état des dépendances, les interventions humaines et les résultats confirmés sans collecter de données sensibles inutiles. Définissez les seuils d’alerte et le responsable de la réponse, puis examinez les preuves du monde réel après le déploiement plutôt que de supposer que les performances hors ligne persisteront. Réévaluez chaque fois que les sources de données, les utilisateurs, les modèles, les fournisseurs, les politiques, le matériel ou les objectifs changent. Un système maintenu nécessite également une récupération documentée, l’apprentissage des incidents, les procédures de suppression et de conservation, et un point clair où il doit être désactivé ou remplacé.
Foire aux questions
Les SVM ne servent-ils qu’à la classification ?
Non. La régression à vecteur de support prédit des cibles continues, tandis qu’un SVM à une classe peut estimer une frontière de nouveauté. Chaque variante a un objectif différent et un ensemble d’hyperparamètres distinct.
Quand un SVM linéaire est-il un bon choix ?
Les SVM linéaires sont souvent efficaces pour des caractéristiques hautement dimensionnelles et clairsemées, y compris les représentations textuelles traditionnelles, où un noyau flexible ajouterait un coût sans avantage clair.
Références principales