
Fundamentos de la IA
¿Qué son las redes neuronales?

 Añade Unite.AI a tus fuentes preferidas en Google
Una red neuronal artificial es un modelo matemático parametrizado construido a partir de capas de operaciones conectadas. Durante el entrenamiento, la red ajusta sus parámetros de modo que las entradas se asignen a salidas útiles. Las redes neuronales pueden aproximar relaciones no lineales complejas y aprender representaciones directamente a partir de texto, imágenes, audio, series temporales y otros datos.
El nombre se inspira históricamente en las neuronas biológicas, pero las redes modernas son sistemas de ingeniería más que simulaciones realistas del cerebro. Términos como “neurona” y “aprendizaje” son abreviaturas útiles y no deben confundirse con evidencia de cognición similar a la humana.
Conclusiones clave
- Una neurona calcula una suma ponderada, añade un sesgo entrenable y aplica una función de activación.
- Una pasada hacia adelante genera predicciones; una función de pérdida mide el error; la retropropagación calcula los gradientes; un optimizador actualiza los parámetros.
- MLP, CNN, RNN y transformers organizan las conexiones de manera diferente.
- Más capas o más parámetros no garantizan automáticamente un modelo mejor o más fiable.
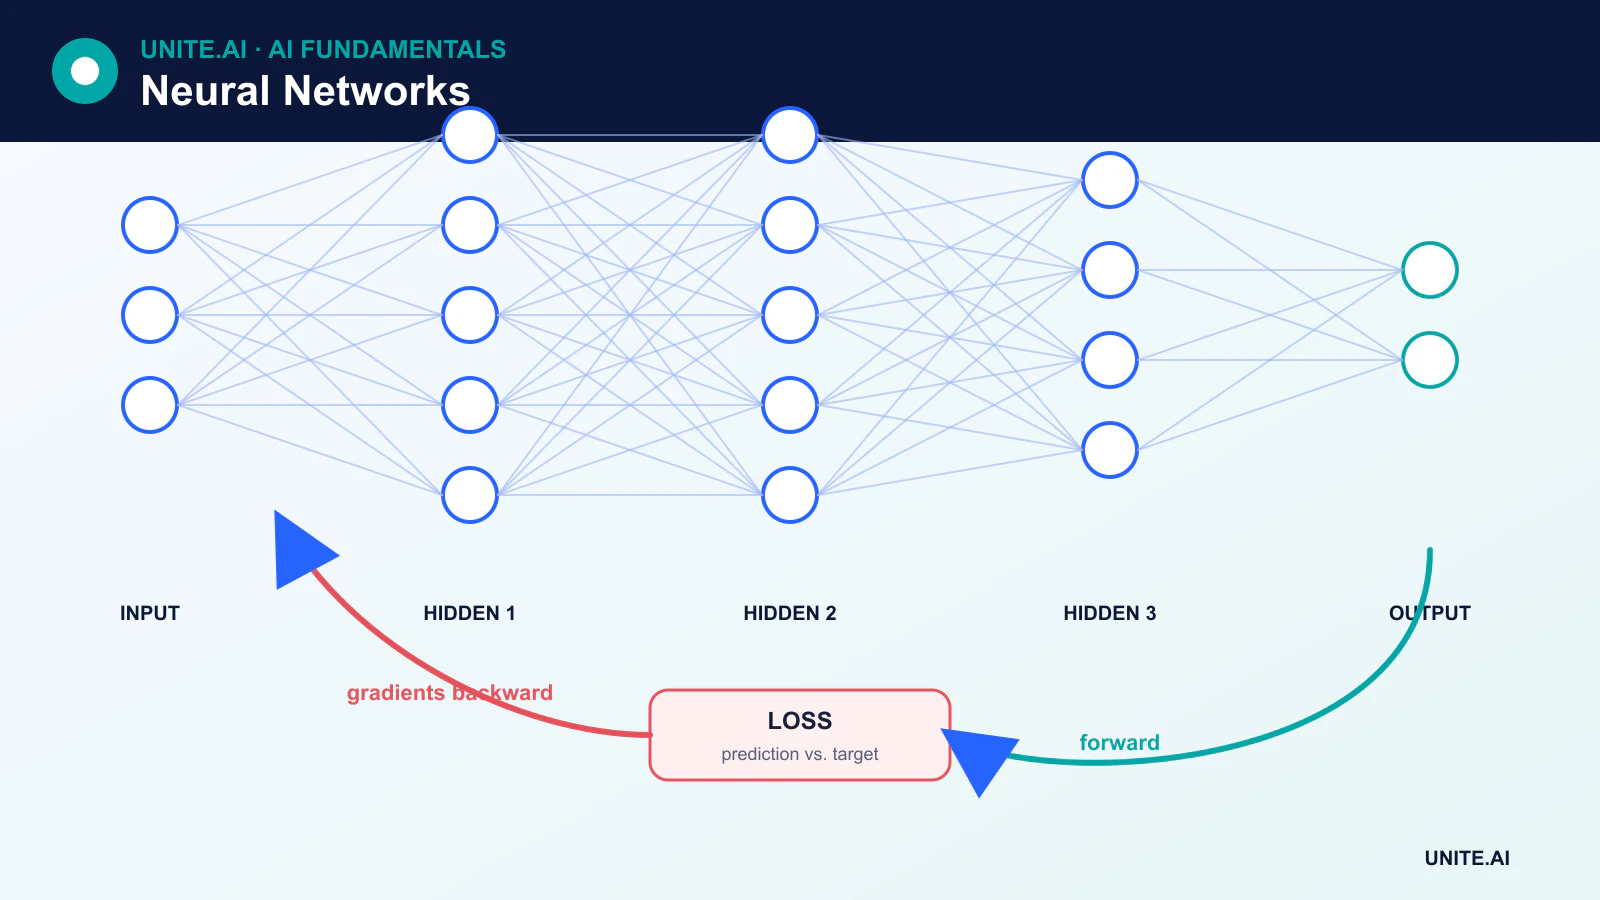
De una sola neurona artificial a una red
Para un vector de entrada x, una unidad básica calcula:
z = Wx + boutput = activation(z)
W contiene pesos entrenables y b es un sesgo entrenable. La función de activación introduce no linealidad. Los pesos no “pasan a través” de la activación por sí mismos; la activación se aplica a la suma ponderada y al sesgo.
Un perceptrón multicapa (MLP) apila capas densas. La capa de entrada representa las características, las capas ocultas las transforman y la capa de salida está diseñada para la tarea —por ejemplo, logits de clase o un valor de regresión.
Cómo aprenden las redes neuronales
- El modelo inicializa los parámetros entrenables.
- Una pasada hacia adelante procesa un lote y produce predicciones.
- Una función de pérdida compara las predicciones con el objetivo de entrenamiento.
- Retropropagación utiliza la regla de la cadena para calcular los gradientes.
- Un optimizador como descenso de gradiente estocástico o AdamW actualiza pesos y sesgos.
La retropropagación se volvió central en el entrenamiento de redes neuronales gracias a trabajos desarrollados y popularizados a lo largo de varias décadas; no fue creada por primera vez en la reciente era del deep learning. Los marcos modernos implementan diferenciación automática en modo inverso para que los practicantes no tengan que derivar manualmente cada gradiente.
Por qué importan las funciones de activación
Sin activaciones no lineales, múltiples capas lineales ordinarias colapsan en una sola transformación lineal. ReLU se usa ampliamente porque es simple y eficiente. GELU y SiLU son comunes en arquitecturas modernas. Sigmoid y softmax siguen siendo útiles para interpretaciones específicas de salida, pero sigmoid puede saturarse en capas ocultas y contribuir a la desaparición de gradientes.
Principales arquitecturas de redes neuronales
Redes neuronales convolucionales
CNNs aplican filtros aprendidos sobre vecindades locales y comparten parámetros entre posiciones. Estas propiedades las hacen eficientes para imágenes y otras señales tipo rejilla.
Redes recurrentes
RNNs, LSTMs y GRUs actualizan un estado oculto a lo largo de una secuencia. siguen siendo útiles para tareas de streaming y series temporales, aunque la recurrencia limita el procesamiento paralelo y puede presentar dificultades con dependencias largas.
Transformers
Transformers usan atención para crear representaciones dependientes del contexto. Las conexiones residuales, la normalización, la información de posición y los bloques feed‑forward son partes centrales de la arquitectura. Los transformers ahora sustentan muchos modelos grandes de lenguaje y multimodales.
Autoencoders y redes generativas
Autoencoders aprenden representaciones mediante reconstrucción. GANs, modelos de difusión y redes autorregresivas generan nuevas muestras usando diferentes objetivos y procedimientos de entrenamiento.
Componentes que hacen entrenables a las redes profundas
Los sistemas modernos usan más que capas y activaciones. Las conexiones residuales permiten que la información y los gradientes eviten bloques. La normalización estabiliza las activaciones. La regularización, el aumento de datos, dropout y decaimiento de pesos pueden reducir el sobreajuste. Las capas de embedding asignan elementos discretos como tokens a vectores. La atención permite que una representación dependa dinámicamente de otros elementos.
Fortalezas y limitaciones
Las redes neuronales pueden aprender características a partir de datos crudos de alta dimensión y escalar con más datos y cómputo. También pueden requerir grandes conjuntos de datos, hardware especializado y una afinación cuidadosa. Sus predicciones pueden estar mal calibradas, ser frágiles ante cambios de distribución, vulnerables a manipulaciones adversarias o difíciles de explicar.
La arquitectura debe ajustarse a la tarea y a las restricciones de despliegue. Para muchos problemas tabulares, un conjunto de árboles o un modelo lineal puede ser más rápido y más fácil de validar. Para aplicaciones de alto riesgo, el rendimiento del modelo debe evaluarse por subgrupos y modos de falla, no solo mediante un benchmark agregado.
Capas, activaciones y flujo de información
Una red neuronal compone funciones parametrizadas. Cada unidad forma una combinación ponderada de entradas, añade un sesgo y pasa el resultado por una activación como ReLU, sigmoid, tanh o GELU. Apilar capas permite características jerárquicas y fronteras de decisión no lineales. El ancho controla unidades por capa; la profundidad controla transformaciones sucesivas; la conectividad y el compartir pesos codifican la arquitectura. La salida de la red depende del preprocesamiento, los parámetros, la normalización y el modo de inferencia en conjunto. Una neurona es una operación matemática, no una neurona biológica literal ni un concepto independiente con significado propio.
La propagación hacia adelante calcula predicciones; una pérdida cuantifica el error; la retropropagación aplica la regla de la cadena a los gradientes; un optimizador actualiza los parámetros. La inicialización, la tasa de aprendizaje, las estadísticas por lote, los caminos residuales y la normalización influyen en si los gradientes desaparecen, explotan o permanecen útiles. La regularización incluye decaimiento de pesos, dropout, aumento de datos, parada temprana y restricciones arquitectónicas. Trace el comportamiento de entrenamiento y validación, inspeccione estadísticas de gradientes y activaciones, y compare ejecuciones repetidas. Una red grande puede memorizar datos de entrenamiento, mientras que una pequeña puede subajustar o no captar la estructura necesaria.
Selección de arquitectura, evaluación y despliegue
Los perceptrones multicapa procesan vectores fijos; las redes convolucionales explotan la estructura local; los modelos recurrentes y de espacio de estados procesan secuencias; los transformers usan atención; las redes de grafos intercambian información a lo largo de aristas. Los híbridos son comunes. Elija según sesgo inductivo, datos, tamaño de secuencia o imagen, latencia, memoria, interpretabilidad y hardware disponible. Evalúe contra una línea base lineal o de árbol y realice ablaciones para aprender qué complejidad importa. El recuento de parámetros por sí solo no predice calidad, coste de inferencia o requerimientos de datos.
El servicio requiere preprocesamiento congelado, un grafo exportado o compilado, validación numérica y pruebas de recursos bajo carga realista. La cuantización y la poda pueden reducir el tamaño pero alterar el comportamiento en clases raras. Monitoree entradas, salidas, calibración, latencia y resultados confirmados; pruebe datos adversarios y desplazados. Proteja modelos, dependencias y datos mediante artefactos firmados, control de acceso y revisión de la cadena de suministro. Las explicaciones a partir de activaciones individuales o mapas de saliencia requieren verificación causal y de comportamiento. Las redes neuronales son aproximadores de funciones flexibles, no garantías de comprensión, verdad o robustez.
Ejemplo práctico: un pronosticador de demanda neuronal
Un minorista predice la demanda semanal de artículos a partir de ventas, promociones, precios, festivos, disponibilidad y clima. La red se compara con líneas base estacionales ingenuas, lineales y de árbol usando divisiones temporales rodantes. Las promociones futuras se incluyen solo cuando se conocen realmente al momento del pronóstico, mientras que los desabastecimientos se modelan porque las ventas observadas pueden subestimar la demanda. La evaluación usa error absoluto ponderado, sesgo, cobertura de intervalos y resultados por velocidad del artículo y tienda.
La tubería de servicio versiona disponibilidad de características, modelo y horizonte y rechaza un pronóstico cuando los insumos requeridos están obsoletos. Los planificadores ven intervalos y pueden sobrescribir con razones registradas. El monitoreo detecta fuentes faltantes, cambios de error, sesgo y pronósticos inusuales; los resultados de negocio se separan de la precisión del pronóstico porque la política de pedidos también afecta el inventario. Una actualización del modelo se despliega en modo sombra durante varios ciclos, y el pronosticador anterior permanece disponible para retroceso durante interrupciones estacionales o de proveedores.
Evidencia de implementación y preparación operativa
Una decisión de producción requiere más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de afinar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, coste de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para liberación, excepciones, cambios, retroceso y retiro. Use un despliegue escalonado, preserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar calidad de entrada, comportamiento de salida, versión del modelo o regla, salud de dependencias, anulaciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿Todas las redes neuronales son deep learning?
No. Una red pequeña con una capa oculta es una red neuronal, mientras que deep learning generalmente se refiere a arquitecturas con múltiples etapas de procesamiento aprendidas. El límite es convencional más que un umbral científico estricto.
¿Las redes neuronales almacenan sus datos de entrenamiento?
Almacenan los parámetros aprendidos, no una copia buscable ordinaria del conjunto de datos. Sin embargo, los modelos grandes pueden memorizar y reproducir ejemplos de entrenamiento individuales, lo que genera riesgos de privacidad y derechos de autor que deben evaluarse.
Referencias principales












