
Fundamentos de la IA
¿Qué es la retropropagación?

 Añade Unite.AI a tus fuentes preferidas en Google
Backpropagation es el algoritmo utilizado para calcular cómo varía la pérdida de una red neuronal respecto a sus parámetros entrenables. Aplica la regla de la cadena del cálculo de forma inversa a través de las operaciones registradas durante una pasada hacia adelante.
La retropropagación calcula los gradientes; no decide, por sí misma, la actualización. Un optimizador como el descenso de gradiente estocástico o AdamW utiliza esos gradientes para modificar pesos, sesgos y otros parámetros entrenables.
Puntos clave
- La propagación hacia adelante construye valores intermedios y produce una predicción.
- La función de pérdida convierte la predicción y el objetivo en un objetivo de entrenamiento escalar.
- La retropropagación usa derivadas locales y la regla de la cadena para calcular eficientemente los gradientes de los parámetros.
- Los frameworks modernos implementan diferenciación automática en modo reverso sobre un grafo computacional.
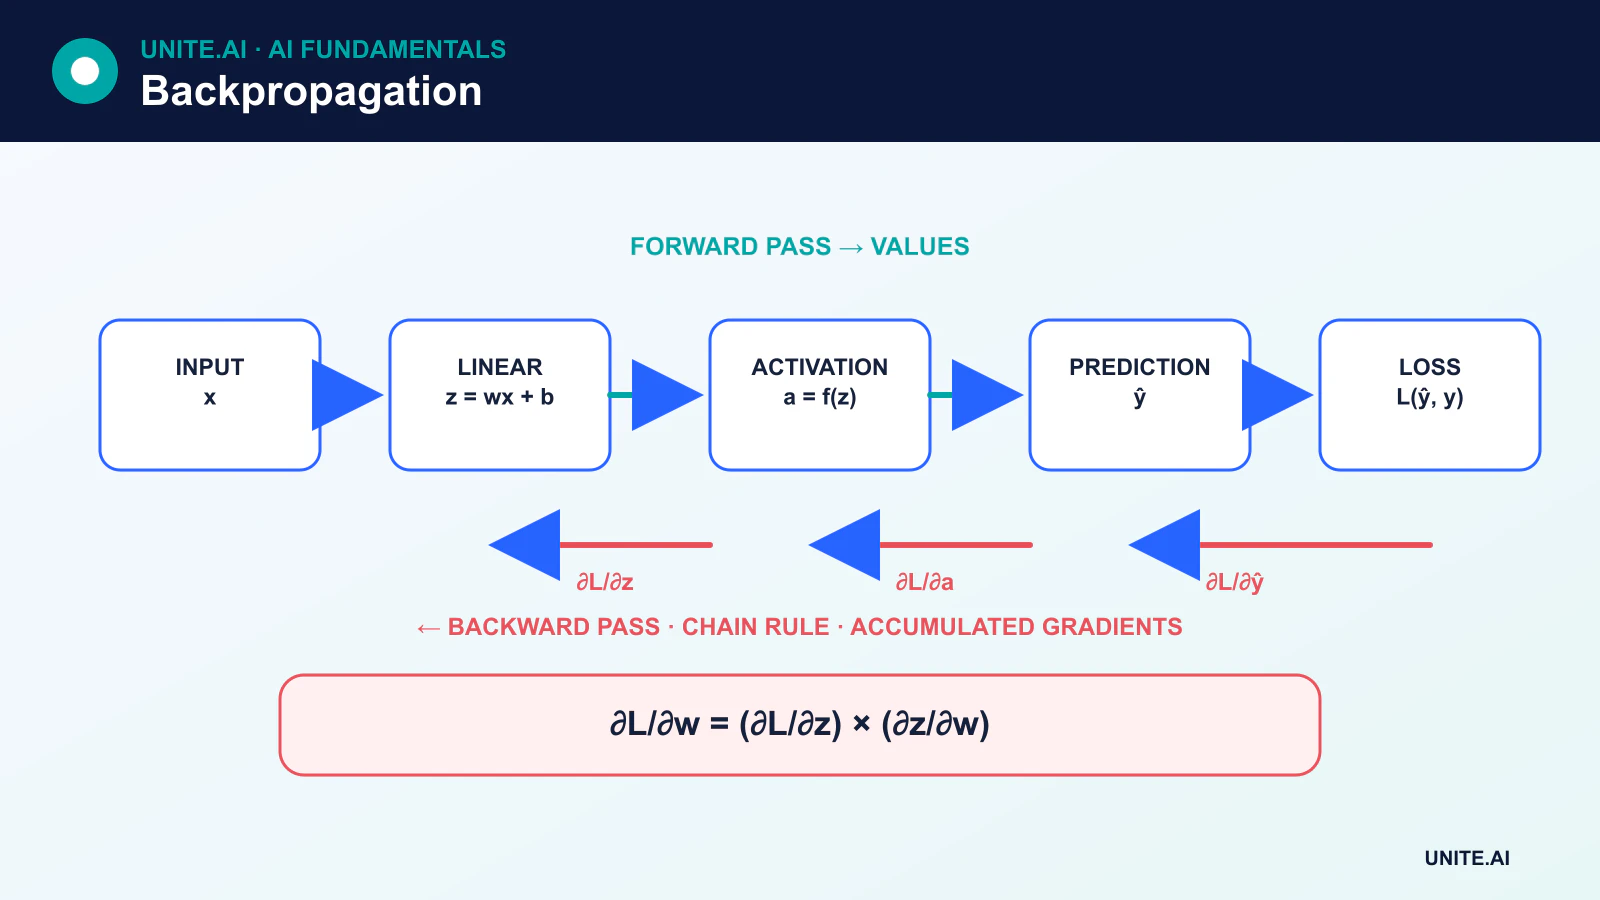
Propagación hacia adelante
Considere una unidad simple:
z = wx + bŷ = activation(z)
La entrada es x, mientras que w y b son parámetros entrenables de peso y sesgo. Los sesgos normalmente cambian durante el entrenamiento al igual que los pesos. Una red combina muchas de esas operaciones, además de normalización, atención, convoluciones, conexiones residuales u otros bloques diferenciables.
La propagación hacia adelante evalúa esas operaciones y produce una predicción. Una función de pérdida como la entropía cruzada o el error cuadrático medio mide el objetivo. La pérdida adecuada depende de la tarea y de la interpretación de la salida.
Regla de la cadena
Si la pérdida L depende de un valor intermedio z, y z depende del parámetro w, la regla de la cadena da:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Una red profunda contiene muchos caminos. La retropropagación recorre el grafo computacional en sentido inverso, acumulando contribuciones cuando un valor afecta la pérdida a través de más de un camino. El resultado es un gradiente para cada parámetro entrenable que participó en la computación hacia adelante.
Un pequeño ejemplo numérico
Supongamos ŷ = wx + b, con x = 2, w = 3 y b = 1. La predicción es 7. Si el objetivo es 5 y la pérdida es L = ½(ŷ - y)², entonces:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
El optimizador puede entonces mover w y b en la dirección del gradiente negativo. Esta fórmula es específica de la unidad lineal elegida y de la pérdida de error cuadrático; una regla universal de retropropagación es la regla de la cadena sobre el grafo real, no una ecuación “de error” fija.
Retropropagación versus descenso de gradiente
Gradient descent es un método de optimización. La retropropagación proporciona los gradientes que necesita. Un paso de entrenamiento suele seguir:
- Borrar o reiniciar los gradientes almacenados.
- Ejecutar la propagación hacia adelante.
- Calcular la pérdida.
- Ejecutar la propagación hacia atrás.
- Aplicar la actualización del optimizador.
Separar estos conceptos facilita la comprensión del momentum, AdamW, la acumulación de gradientes y el entrenamiento de precisión mixta.
Diferenciación automática
Frameworks como PyTorch registran operaciones y construyen un grafo durante la propagación hacia adelante. La diferenciación automática en modo reverso calcula entonces productos vector‑Jacobiano de forma eficiente desde las salidas hasta los parámetros. Esto es más general que codificar manualmente derivadas para una red fija y es fundamental para los frameworks modernos de deep learning.
Algunas operaciones no son diferenciables o tienen derivadas inestables. Los frameworks definen subgradientes o convenciones documentadas en ciertos casos, pero los practicantes deben comprender aún tensores desacoplados, operaciones in situ y precisión numérica.
Gradientes que desaparecen y explotan
La multiplicación repetida a través de muchas capas o pasos de tiempo puede hacer que los gradientes sean extremadamente pequeños o grandes. Los gradientes que desaparecen ralentizan el aprendizaje en capas anteriores; los gradientes que explotan desestabilizan las actualizaciones. Activaciones de la familia ReLU, una inicialización cuidadosa, conexiones residuales, normalización, recurrencia con compuertas y recorte de gradientes ayudan, pero ninguno es una solución universal.
Verificación de gradientes
La verificación de gradientes por diferencias finitas compara un gradiente analítico o automático con una aproximación numérica. Es lenta pero útil para depurar operaciones personalizadas. Monitorear las normas de los gradientes y detectar valores NaN o infinitos puede revelar inestabilidad durante el entrenamiento.
La regla de la cadena a través de un grafo computacional
La retropropagación calcula eficientemente los gradientes de una pérdida escalar respecto a cada parámetro diferenciable. Una pasada hacia adelante registra valores intermedios en un grafo computacional. Partiendo de la pérdida, la diferenciación automática en modo reverso aplica la regla de la cadena, multiplicando derivadas locales y acumulando contribuciones donde los caminos se encuentran. Para una capa y=f(x,w), la sensibilidad ascendente a y se combina con derivadas parciales para producir sensibilidades para x y w. La retropropagación calcula los gradientes; el optimizador decide cómo cambian los parámetros.
Una capa afín simple produce y=Wx+b. El gradiente para W es el producto externo del gradiente ascendente y la entrada, el gradiente para b suma los valores ascendentes, y el gradiente de la entrada se multiplica por la matriz de pesos transpuesta. Las activaciones añaden derivadas elemento a elemento. Convolución, normalización, atención y reutilización recurrente siguen el mismo principio de grafo pero requieren formas de tensor correctas, difusión, enmascarado y compartición de parámetros. Los frameworks liberan las activaciones guardadas después de la retropropagación a menos que se retengan, por lo que la memoria a menudo crece con el tamaño del lote, la profundidad y la longitud de la secuencia.
Fallos de gradiente, verificación y práctica de ingeniería
Los productos de muchas derivadas pueden desaparecer o explotar. Activaciones tipo ReLU, una inicialización cuidadosa, normalización, conexiones residuales, compuertas y recorte de gradientes abordan diferentes mecanismos. Activaciones saturadas y operaciones no diferenciables pueden bloquear señales útiles; la retropropagación truncada limita la historia de la secuencia; la precisión mixta puede producir subflujo sin escalado de pérdida. Los gradientes que explotan son un síntoma, por lo que el recorte debe acompañarse de una investigación de la tasa de aprendizaje, los datos, la arquitectura y los errores numéricos en lugar de ocultarlos.
Verifique operaciones personalizadas con verificaciones de gradientes por diferencias finitas en pequeñas entradas de doble precisión, evitando puntos no diferenciables. Inspeccione las normas de los gradientes, NaNs, parámetros inactivos y si los gradientes llegan a los módulos esperados. Borre deliberadamente los gradientes acumulados y distinga el comportamiento de entrenamiento del de evaluación para dropout y normalización. El checkpoint recomputa activaciones para ahorrar memoria; el entrenamiento distribuido debe agregar los gradientes de forma consistente. Una pérdida de entrenamiento decreciente muestra que existe una ruta de optimización, no que los gradientes sean conceptualmente correctos, que los datos estén libres de fugas o que el modelo generalice.
Ejemplo práctico: verificación de una capa neuronal personalizada
Un ingeniero implementa una capa espectral diferenciable para una red de audio. Una pequeña prueba de doble precisión compara los gradientes automáticos con diferencias finitas centrales a través de entradas y parámetros, excluyendo los puntos donde la operación es intencionalmente no diferenciable. La forma, difusión, relleno y conversión de complejo a real reciben casos separados. La prueba verifica los gradientes acumulados cuando un parámetro se reutiliza y confirma que los fotogramas de audio enmascarados no producen gradiente.
Durante el entrenamiento, los paneles rastrean normas de gradientes y activaciones, NaNs, parámetros inactivos y escalado de pérdida. Un lote deliberadamente corrupto confirma que la validación detecta salidas no finitas antes de una actualización del optimizador. La precisión mixta y las implementaciones exportadas se comparan con la referencia. Las pruebas de reanudación de checkpoints incluyen el estado del optimizador y el orden aleatorio. La capa no se acepta simplemente porque la pérdida total disminuya; los gradientes unitarios, la estabilidad numérica y la generalización posterior deben proporcionar evidencia coherente.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, fallos de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Utilice un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, intervenciones humanas y resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que deba desactivarse o reemplazarse.
Preguntas frecuentes
¿La retropropagación actualiza los pesos?
La retropropagación calcula los gradientes. El optimizador aplica una actualización usando esos gradientes, su tasa de aprendizaje y, posiblemente, estado como momentum o momentos adaptativos.
¿Es la retropropagación biológicamente realista?
La retropropagación estándar es un algoritmo de ingeniería y no se acepta como un modelo detallado del aprendizaje en cerebros biológicos. La analogía neuronal histórica no debe considerarse equivalente biológicamente.
Referencias principales












