
Fundamentos de la IA
¿Qué es el descenso de gradiente?

 Añade Unite.AI a tus fuentes preferidas en Google
Gradient descent es un método de optimización que ajusta los parámetros del modelo para reducir una función objetivo. En el entrenamiento de redes neuronales, ese objetivo suele ser una pérdida calculada sobre los ejemplos. El gradiente apunta en la dirección del mayor aumento local, por lo que el descenso de gradiente da un paso en la dirección opuesta.
El gradiente describe la sensibilidad local; su magnitud no es una medida directa de la rapidez con que un modelo está “aprendiendo”. El progreso real también depende de la tasa de aprendizaje, la curvatura, el ruido, la parametrización, el estado del optimizador y los datos.
Conclusiones clave
- Backpropagation calcula los gradientes, mientras que el descenso de gradiente los usa para actualizar los parámetros.
- La optimización por mini‑lotes es el enfoque práctico estándar para el aprendizaje profundo.
- La tasa de aprendizaje controla la escala de la actualización y puede seguir un programa en lugar de reducirse después de cada paso.
- Momentum, AdamW, recorte y normalización abordan diferentes problemas de optimización.
La regla de actualización básica
Para el vector de parámetros θ, la tasa de aprendizaje η y la pérdida L:
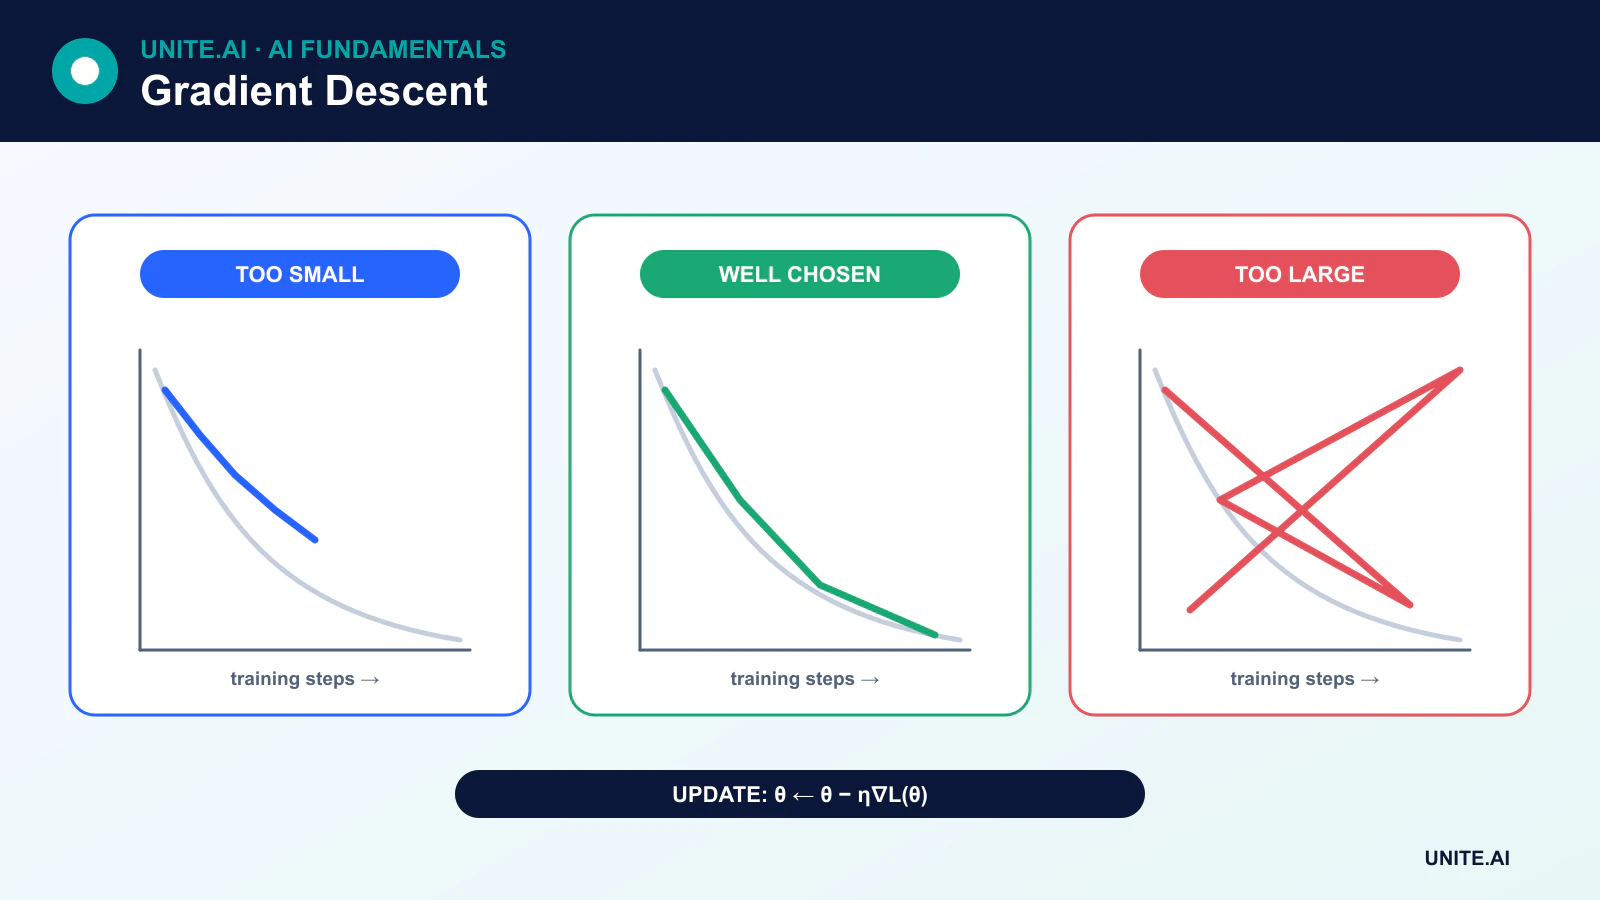
θ ← θ - η∇L(θ)
El gradiente ∇L(θ) contiene una derivada parcial por parámetro. Restarlo mueve localmente cuesta abajo. Un punto estacionario tiene gradiente cero, pero puede ser un mínimo, máximo, punto de silla o una región plana. Las superficies de pérdida del aprendizaje profundo son no convexas, por lo que el entrenamiento no garantiza encontrar un mínimo global único o una pérdida cero.
Métodos por lotes, estocásticos y mini‑lotes
Descenso de gradiente por lotes
El descenso de gradiente por lotes calcula un gradiente usando todo el conjunto de entrenamiento para cada actualización. La estimación es estable pero puede ser costosa en tiempo y memoria, y una actualización puede subutilizar los aceleradores modernos.
Descenso de gradiente estocástico
El descenso de gradiente estocástico estricto utiliza un ejemplo seleccionado aleatoriamente por actualización. Sus gradientes son ruidosos, lo que puede ayudar a explorar la superficie de pérdida, pero las operaciones con un solo ejemplo pueden ser ineficientes en hardware paralelo.
Descenso de gradiente por mini‑lotes
El entrenamiento por mini‑lotes estima el gradiente a partir de un subconjunto de ejemplos. Equilibra el ruido estadístico con operaciones matriciales eficientes y es el enfoque habitual en deep learning. El tamaño del lote afecta la memoria, el rendimiento, el ruido del gradiente, la normalización y, a veces, la generalización.
Cómo elegir una tasa de aprendizaje
Una tasa demasiado alta puede sobrepasar regiones útiles o causar divergencia. Una tasa demasiado baja puede hacer que el entrenamiento sea imprácticamente lento o se estanque en regiones planas. La escala óptima depende del optimizador, el tamaño del lote, el modelo, la inicialización y el objetivo.
Los programas pueden calentar gradualmente, decaer en hitos, seguir una curva cosenoidal o responder al progreso de validación. La tasa no tiene que reducirse monotonamente después de cada actualización. Los reinicios cálidos y los programas cíclicos aumentan deliberadamente la tasa durante partes del entrenamiento.
Momentum
Momentum mantiene un promedio móvil exponencial de los gradientes pasados. Puede acelerar el progreso a lo largo de direcciones consistentes y reducir la oscilación en direcciones empinadas y estrechas. El momentum al estilo Nesterov evalúa o aproxima el gradiente después de mirar hacia adelante a lo largo de la dirección del momentum.
Optimizadores adaptativos
RMSProp escala las actualizaciones usando un promedio móvil de los gradientes al cuadrado. Adam combina momentos de primer orden similares al momentum con escalado de segundo momento. AdamW desacopla la desintegración de pesos (weight decay) de la actualización adaptativa del gradiente y se usa ampliamente para transformers.
Los optimizadores adaptativos a menudo facilitan el entrenamiento inicial, pero no son automáticamente superiores para cada modelo o objetivo de generalización final. Las comparaciones de optimizadores requieren programas coincidentes y una afinación cuidadosa.
Recorte y acumulación de gradientes
El recorte de gradientes limita la norma o los valores de un gradiente para reducir el impacto de gradientes explosivos, especialmente en entrenamientos recurrentes o inestables. La acumulación de gradientes suma los gradientes de varios lotes pequeños antes de una actualización, aproximando un lote efectivo mayor cuando la memoria es limitada.
Monitorización de la optimización
Supervisa la pérdida de entrenamiento y validación, métricas de la tarea, la tasa de aprendizaje, normas de gradiente, normas de parámetros y errores numéricos. Una caída de la pérdida de entrenamiento con empeoramiento del rendimiento de validación indica sobreajuste, no un éxito de optimización que deba continuar automáticamente.
La optimización minimiza el objetivo que se le da. Una pérdida baja no prueba que los datos, la métrica o el comportamiento en el mundo real sean adecuados. Fugas, etiquetas deficientes y un objetivo desalineado pueden producir un modelo bien optimizado pero perjudicial.
Geometría de la optimización y reglas de actualización
El descenso de gradiente actualiza los parámetros en dirección opuesta al gradiente de una pérdida. El descenso por lotes completos usa todos los ejemplos de entrenamiento en cada paso; el descenso estocástico usa uno; los métodos por mini‑lotes estiman el gradiente a partir de un subconjunto y dominan el aprendizaje profundo. La tasa de aprendizaje determina la escala del paso. Una tasa demasiado pequeña desperdicia cómputo o se estanca; una demasiado grande oscila o diverge. Momentum acumula una dirección móvil, mientras que los métodos adaptativos como Adam escalan las coordenadas usando momentos del gradiente. Sus diferentes sesgos implícitos pueden producir modelos con pérdidas de entrenamiento similares pero distinta generalización.
Las superficies de pérdida en redes neuronales contienen regiones planas y agudas, puntos de silla, simetrías y direcciones mal condicionadas. El escalado de características, la normalización, la inicialización, las conexiones residuales y el preacondicionamiento cambian la geometría vista por el optimizador. Los programas pueden calentar, decaer, ciclar o reaccionar a mesetas. El weight decay es distinto de simplemente añadir una penalización L2 en algunos optimizadores adaptativos. El tamaño del lote afecta el ruido, la memoria, el paralelismo y el régimen de la tasa de aprendizaje, por lo que las comparaciones de optimizadores requieren presupuestos de entrenamiento coincidentes y una afinación cuidadosa.
Diagnóstico, reproducibilidad y detención
Supervisa la pérdida de entrenamiento y validación, métricas de la tarea, normas de gradiente y parámetros, tasa de aprendizaje, rendimiento y advertencias numéricas. La divergencia puede provenir de lotes corruptos, etiquetas inválidas, precisión mixta inestable o una reducción de pérdida incorrecta. Las mesetas pueden indicar capacidad insuficiente, activaciones saturadas, características deficientes, regularización excesiva o un problema de programa. El sobreajuste requiere datos, aumento, regularización o detención temprana, no una afirmación de que el optimizador falló. Inspecciona errores representativos y compara una línea base simple antes de aumentar la complejidad del entrenamiento.
La reproducibilidad requiere semillas, orden de datos, código, configuración, versiones de hardware y bibliotecas, aunque algunos núcleos de aceleradores siguen siendo no determinísticos. Guarda puntos de control con el estado del optimizador y del programador para que el entrenamiento pueda reanudarse de forma consistente. Selecciona un punto de control según criterios de validación fijados previamente y reserva un conjunto de pruebas sin tocar. En entrenamiento distribuido, confirma el tamaño de lote efectivo, el promedio de gradientes y el manejo de trabajadores fallidos. La optimización minimiza el objetivo elegido sobre los datos disponibles; no garantiza probabilidades calibradas, razonamiento causal, equidad, seguridad o utilidad en el mundo real.
Ejemplo práctico: ajustar un optimizador para un modelo de lenguaje
Un equipo fija el tokenizador, el orden de los datos, el modelo, el lote efectivo y el presupuesto de tokens de entrenamiento, luego compara SGD con momentum y AdamW a través de programas de tasa de aprendizaje defendibles. Se registran el calentamiento, la decaída, el weight decay, el recorte y la precisión. Cada candidato ejecuta varias semillas, y la validación usa una fracción de tiempo reservada más evaluaciones de tareas. El rendimiento y la energía se informan junto con la pérdida para que un optimizador ligeramente mejor no se seleccione a un costo desproporcionado.
Los diagnósticos revelan si la inestabilidad se origina en una partición de datos, un tamaño de paso excesivo, subdesbordamiento o la arquitectura del modelo. Los puntos de control conservan el estado del optimizador y del programador y se reanudan en una prueba. La elección final se basa en la calidad y robustez de la validación, no en la pérdida de entrenamiento más baja. Un conjunto de pruebas sellado se ejecuta una vez después de la selección. La inferencia en producción se calibra y monitoriza por separado porque el éxito del optimizador durante el preentrenamiento no garantiza un comportamiento seguro o veraz.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Define los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establece una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Prueba casos ordinarios, condiciones límite, entradas malformadas o ausentes, cambios de distribución, fallos de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mide la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registra cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigna autoridad para la liberación, excepciones, cambios, retroceso y retiro. Utiliza un despliegue por etapas, conserva una alternativa segura y verifica la monitorización con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Define umbrales de alerta y un responsable de respuesta, luego revisa la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalúa siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿El descenso de gradiente siempre alcanza el mínimo global?
No. Para objetivos convexos, condiciones apropiadas brindan garantías fuertes. Los objetivos de redes profundas son no convexos, y los optimizadores prácticos suelen buscar una solución útil en lugar de demostrar que encontraron el mínimo global único.
¿Por qué un gradiente cero puede ser engañoso?
Un gradiente cero o muy pequeño puede indicar un mínimo, máximo, punto de silla, saturación o una meseta plana. Los diagnósticos de entrenamiento deben considerar el historial de pérdida, la curvatura, la escala de los parámetros y el rendimiento de validación.
Referencias principales












