
Fundamentos de la IA
¿Cómo funciona la clasificación de texto?

 Añade Unite.AI a tus fuentes preferidas en Google
La clasificación de texto asigna una o más etiquetas a un documento, mensaje o fragmento de texto. Los ejemplos incluyen detección de spam, enrutamiento de intención, análisis de sentimiento, etiquetado de temas, moderación y priorización de tickets de soporte.
Un clasificador en producción es más que un modelo. Depende de una taxonomía de etiquetas precisa, anotaciones representativas, particiones seguras contra filtraciones, una regla de decisión calibrada y monitoreo del lenguaje cambiante y la prevalencia de clases.
Conclusiones clave
- Definir etiquetas y casos ambiguos antes de seleccionar una arquitectura.
- Los enfoques simples de bolsa de palabras siguen siendo valiosos; los codificadores preentrenados añaden contexto y aprendizaje por transferencia.
- La exactitud puede ocultar un bajo rendimiento en clases minoritarias, por lo que se deben usar métricas conscientes de la clase y análisis de errores.
- La calibración de probabilidades, la abstención y la revisión humana convierten las puntuaciones en decisiones más seguras.
Definir la taxonomía y la política de anotación
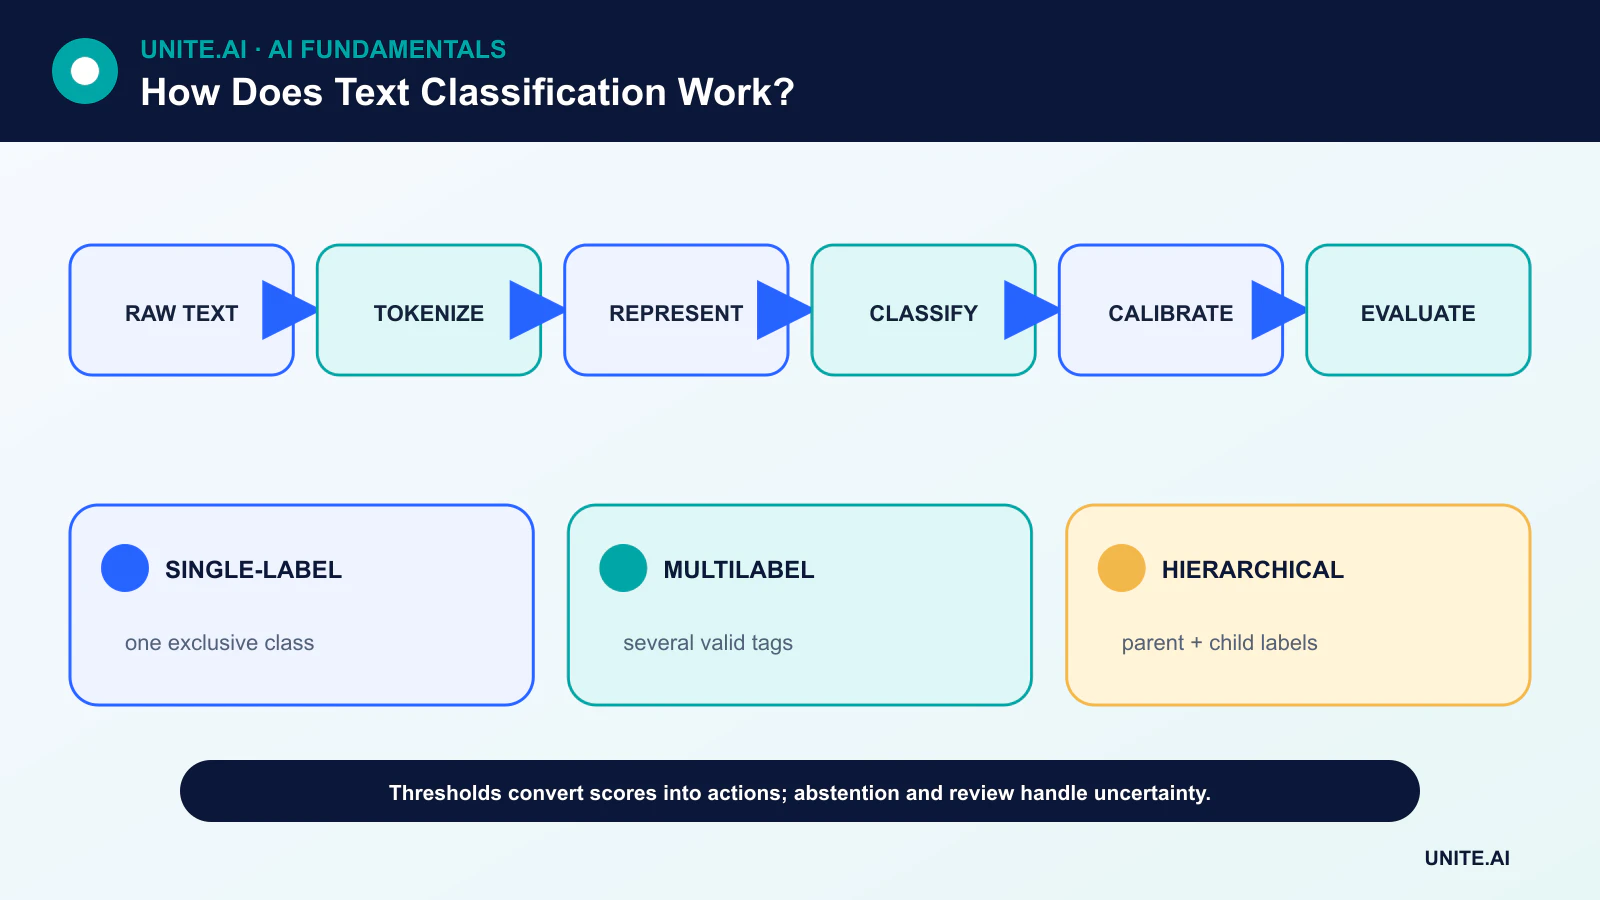
Una tarea de etiqueta única elige una clase mutuamente excluyente. Una tarea multilabel puede asignar varias etiquetas independientes. Las taxonomías jerárquicas contienen etiquetas padre e hijo. Estos son problemas de aprendizaje diferentes y requieren salidas y métricas distintas.
Los anotadores necesitan definiciones, ejemplos positivos y negativos, reglas para contextos faltantes y una vía de escalamiento. Las estadísticas de acuerdo pueden revelar una tarea poco clara, pero el desacuerdo también puede representar ambigüedad genuina que el sistema debe preservar.
Representar texto
Las canalizaciones tradicionales usan recuentos de tokens, n‑gramas y TF‑IDF con clasificadores lineales o máquinas de vectores de soporte. Entrenan rápidamente, revelan términos influyentes y proporcionan una base sólida.
Los sistemas neuronales asignan tokens a incrustaciones. Los codificadores transformer preentrenados utilizan atención para producir representaciones contextuales y pueden ajustarse finamente con ejemplos etiquetados. Los clasificadores con prompts o de cero disparos pueden reducir el etiquetado inicial, pero la redacción de sus etiquetas, la versión del modelo y la calibración deben evaluarse en el dominio real.
Entrenamiento sin fuga
El conjunto de datos se separa en datos de entrenamiento, validación y prueba final. Los documentos casi duplicados, mensajes de la misma conversación o plantillas de la misma fuente deben permanecer en una misma partición. Para usos dependientes del tiempo, una división cronológica representa mejor el despliegue.
El desequilibrio de clases puede abordarse mediante ponderación, remuestreo, selección de umbrales o datos adicionales. Los ejemplos sintéticos no deben reemplazar la revisión de fallos reales de clases minoritarias y pueden introducir artefactos que el modelo aprende con demasiada facilidad.
Métricas y decisiones calibradas
Una matriz de confusión muestra qué etiquetas se confunden. La precisión mide cuántos positivos predichos son correctos; el recall mide cuántos verdaderos positivos se encuentran. Los promedios macro ponderan las clases por igual, mientras que los micro ponderan los ejemplos individuales.
Una puntuación softmax cruda no es automáticamente una probabilidad fiable. La calibración compara la confianza con la exactitud observada. Los equipos pueden establecer umbrales específicos por clase, abstenerse cuando la confianza es baja y dirigir casos sensibles a un revisor.
Despliegue, uso multilingüe y deriva
El texto cambia con productos, eventos, jerga y comportamientos adversarios. El monitoreo debe rastrear el idioma de entrada, longitud, patrones fuera del vocabulario, tasas de clase, confianza y resultados retardados. Reentrenar requiere datos versionados y una suite de regresión con ejemplos importantes.
El rendimiento multilingüe debe probarse por idioma y dialecto. Traducir todo a un solo idioma puede alterar el sentimiento o las entidades; un codificador multilingüe aún puede desempeñarse de forma desigual porque su preentrenamiento y etiquetas no son igualmente representativos.
Representaciones y familias de clasificadores
La clasificación de texto asigna un documento, oración o secuencia de tokens a una o más etiquetas. Definir si las etiquetas son mutuamente excluyentes, multilabel, jerárquicas, ordenadas o de conjunto abierto. Las canalizaciones tradicionales tokenizan el texto, construyen características de bolsa de palabras o TF‑IDF, y entrenan regresión logística, Naïve Bayes o un SVM lineal. Los sistemas neuronales aprenden incrustaciones con convolución, recurrencia o transformers. Los modelos de lenguaje con prompts pueden clasificar sin entrenamiento específico de la tarea, pero las restricciones de salida, el costo, la deriva y la evidencia aún requieren evaluación frente a bases más simples.
El preprocesamiento depende de la representación. Convertir a minúsculas o eliminar puntuación puede destruir señales para nombres, sentimiento, código o idioma; la lematización puede fusionar significados distintos. Los tokenizadores de transformers operan sobre subpalabras y tienen límites de longitud, por lo que la estrategia de truncamiento es importante. Los documentos extensos pueden requerir fragmentación y agregación. Conserve el texto original y la versión de transformación, y divida por autor, conversación, fuente o tiempo para evitar que duplicados cercanos y plantillas recurrentes crucen el entrenamiento y la prueba.
Etiquetas, métricas y análisis de errores
Una guía de anotación debe definir el alcance, ejemplos, casos ambiguos y una opción de desconocido o abstención. Medir el acuerdo y adjudicar los desacuerdos en lugar de ocultarlos con voto mayoritario. Para clases desequilibradas, la exactitud es insuficiente; informe precisión, recall, F1, confusión, calibración y carga de trabajo específica por umbral y clase. Las tareas multilabel requieren métricas micro, macro y a nivel de etiqueta. Evalúe idiomas, dialectos, dominios, longitud de mensajes y tiempo. Una división aleatoria puede sobreestimar la calidad cuando el vocabulario o las plantillas cambian.
El análisis de errores debe separar fallos de representación, contexto insuficiente, ambigüedad de etiquetas, vocabulario raro, negación, sarcasmo y pistas espurias. Use pruebas contrafactuales que cambien nombres, marcadores dialectales o metadatos irrelevantes mientras preservan el significado. Inspeccione errores de alta confianza y casos rechazados. Un modelo puede aprender que un canal de cliente o una firma predice una etiqueta en lugar de interpretar el contenido. Elimine la filtración y revise los datos antes de simplemente aumentar la capacidad del modelo.
Diseño de producción
Ofrezca un tokenizador y modelo fijos con validación de esquema, límites de longitud, procesamiento por lotes y una alternativa para idiomas no compatibles o baja confianza. Monitoree la distribución de entradas, tasas de etiquetas, calibración, latencia y resultados revisados. Proteja el texto porque puede contener instrucciones personales, confidenciales o adversarias. Para moderación automatizada, elegibilidad o enrutamiento, proporcione apelación y mida errores disparados. Versione etiquetas y umbrales según la política empresarial. La clasificación de texto es fiable solo dentro de su sistema de etiquetas definido y la distribución de datos; las explicaciones fluidas del modelo no prueban que una clasificación sea correcta.
Ejemplo práctico: clasificación de solicitudes de soporte entrantes
Un equipo de soporte define etiquetas de enrutamiento mutuamente excluyentes más indicadores de urgencia, multilingüe y desconocido. Los anotadores etiquetan mensajes desidentificados con pautas para problemas mixtos y miden el acuerdo. Una línea base logística TF‑IDF, un codificador ajustado y un modelo con prompts utilizan el mismo conjunto de prueba basado en tiempo. Los informes de evaluación presentan precisión y recall por clase, falsos negativos urgentes, calibración, validez del esquema, latencia y costo, con plantillas casi duplicadas agrupadas para evitar filtraciones.
El clasificador desplegado valida el idioma y la longitud, se abstiene ante evidencia débil y permite que los agentes corrijan los enrutamientos. Los prompts y mensajes se tratan como no confiables; no hay acceso a herramientas. El monitoreo rastrea la prevalencia de etiquetas, confianza, correcciones, tiempo de respuesta y temas emergentes. Un cambio de política o producto actualiza la taxonomía y los datos de reentrenamiento mediante revisión. El sistema mejora la ubicación en la cola, pero nunca infiere la emoción o el derecho del cliente más allá de las etiquetas validadas.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas malformadas o ausentes, desplazamiento de distribución, fallos de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retrocesos y retiro. Utilice un despliegue escalonado, conserve una alternativa segura y verifique el monitoreo con fallos inyectados deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Es el análisis de sentimiento una tarea de clasificación de texto?
Generalmente sí, pero el sentimiento puede ser multilabel, basado en aspectos o continuo en lugar de una única etiqueta positiva/neutral/negativa.
¿Cuándo debe abstenerse un clasificador de texto?
Cuando la confianza es baja, el texto está fuera del alcance, falta el contexto necesario o el costo de una acción automática incorrecta supera el costo de la revisión.
Referencias principales












