
Fundamentos de la IA
¿Qué es el reconocimiento de voz conversacional (CSR)?

 Añade Unite.AI a tus fuentes preferidas en Google
El reconocimiento de voz conversacional (CSR) amplía el reconocimiento automático de voz más allá de la transcripción aislada mediante el uso del contexto del diálogo, señales de toma de turnos, información del hablante y procesamiento de baja latencia. El objetivo es respaldar una interacción en tiempo real en la que las palabras, el ritmo, las interrupciones y los turnos anteriores son relevantes.
El CSR es una etiqueta emergente de producto e investigación, no una clase de modelo estandarizada única. Un sistema sólido combina ASR en streaming con detección de final de frase, gestión de hablantes, modelado de lenguaje contextual, estado del diálogo y una política de respuesta, y luego evalúa la experiencia de extremo a extremo.
Conclusiones clave
- El reconocimiento en streaming genera hipótesis provisionales y las revisa a medida que llega más audio.
- La detección de final de frase y la predicción de turnos son independientes de la precisión de la transcripción.
- El historial de la conversación y las palabras clave pueden mejorar el reconocimiento, pero también propagar errores anteriores.
- Evalúe la latencia, interrupciones, hablantes, acentos, ruido, privacidad y la finalización de la tarea, no solo la tasa de error de palabras.
Del ASR al diálogo en vivo
El ASR tradicional convierte el audio en texto. Un sistema conversacional debe decidir cuándo escuchar, cuándo se completa un turno, si el habla está dirigida al sistema y cómo recuperarse cuando su transcripción o respuesta es incorrecta.
Los modelos de streaming procesan los fotogramas de forma incremental y generan transcripciones parciales. La baja latencia mejora la capacidad de respuesta, pero un compromiso prematuro puede aumentar revisiones o errores. La aplicación necesita una política para distinguir texto estable del provisional.
Toma de turnos, superposición y hablantes
La duración del silencio por sí sola es una señal de final débil. La finalización léxica, la prosodia, el ritmo, la mirada y el estado del diálogo pueden ayudar a predecir si una persona mantiene o cede la palabra. La interrupción permite al usuario interrumpir el habla sintetizada sin perder el contexto.
Las voces superpuestas y la diarización siguen siendo difíciles. Los sistemas deben preservar la incertidumbre del hablante, evitar atribuir una declaración a la persona equivocada y ofrecer una vía de corrección, especialmente para registros utilizados en atención médica, finanzas o trabajo legal.
Reconocimiento contextual
Los turnos anteriores pueden desambiguar nombres y referencias; las listas de palabras clave pueden sesgar el reconocimiento hacia términos del dominio. Los modelos de habla y lenguaje pueden codificar el contexto de audio y texto en un marco compartido de prompts o de atención.
El contexto también puede reforzar una transcripción anterior errónea o filtrar información entre sesiones. Limite el historial al propósito actual, separe los metadatos confiables del habla del usuario y utilice el contexto de transformer con reglas explícitas de retención y acceso.
Evaluación y despliegue responsable
Informe la tasa de error de palabras en streaming, la latencia del primer token y de la finalización, la tasa de revisiones, los errores de detección de final, el éxito de la interrupción, la atribución de hablantes y la finalización de la tarea. Pruebe micrófonos reales, ruido, acentos, cambio de código, discapacidades y habla cargada emocionalmente.
Los datos de voz pueden identificar o revelar información sensible. Aplique consentimiento, minimización, cifrado, límites de retención y revisión humana. Conecte las respuestas generadas a los controles de seguridad del chatbot, porque una transcripción precisa no hace que una respuesta sea correcta o autorizada.
De la entrada acústica al estado conversacional
Un sistema de voz conversacional captura audio, aplica acondicionamiento de señal, detecta el habla, reconoce palabras o unidades semánticas, identifica a los hablantes cuando es necesario y actualiza el estado del diálogo. Los sistemas de streaming generan hipótesis parciales antes de que finalice una emisión. Esas hipótesis pueden cambiar, por lo que los componentes posteriores deben distinguir los resultados tentativos de los finales.
La detección de actividad de voz y la detección de final deciden cuándo comienza el habla y cuándo el usuario ha terminado. Los umbrales fijos de silencio fallan con hablantes lentos, ruido de fondo y pausas de reflexión. Los modelos de toma de turnos pueden usar palabras, prosodia, mirada y contexto del diálogo, pero deben equilibrar una respuesta rápida con no interrumpir al hablante.
La diarización responde quién habló y cuándo; el reconocimiento de hablante estima la identidad; la separación de fuentes aísla voces superpuestas. Estas son tareas diferentes con riesgos distintos. En reuniones, atención médica y servicio al cliente, atribuir las palabras correctas a la persona correcta puede ser tan importante como la tasa de error de palabras de la transcripción.
Contexto, superposición, emoción y recuperación de la interacción
El contexto conversacional resuelve pronombres, elipsis, correcciones, términos del dominio y referencias a turnos anteriores. Un sistema puede combinar evidencia acústica con el historial del diálogo y conocimientos recuperados, pero el contexto previo también puede sesgar el reconocimiento hacia una expectativa incorrecta. Preserve la evidencia de audio y la confianza para que el contexto no sobrescriba silenciosamente la incertidumbre.
El diálogo natural incluye canales de retroalimentación, interrupciones, inicios falsos, risas, cambio de código y habla simultánea. Un agente receptivo necesita manejo de interrupción: detener o disminuir su salida, capturar el nuevo habla del usuario, decidir si la interrupción cambia la intención y recuperarse sin duplicar o perder una acción.
La prosodia y las señales paralenguas pueden indicar énfasis o incertidumbre, pero inferir emoción, salud o intención a partir de la voz es propenso a errores y depende culturalmente. Use tales estimaciones de forma conservadora, divulgue su uso cuando corresponda y no tome decisiones importantes basándose en una etiqueta de emoción no validada.
Evaluación, privacidad y diseño de producción
La tasa de error de palabras sigue siendo útil, pero la evaluación conversacional también debe medir la atribución de hablantes, la precisión de entidades, el éxito de tareas semánticas, la estabilidad de hipótesis parciales, la latencia de detección de final, el éxito de interrupciones, la recuperación y la tasa de corrección del usuario. Segmente por acento, idioma, dispositivo, ruido, superposición, estilo de habla y condiciones de red.
La arquitectura de streaming necesita buffers limitados, retropresión, reconexión, números de secuencia y finalización explícita. Mantenga los presupuestos de latencia del modelo y del diálogo separados, rastree cada etapa y pruebe redes degradadas. Cuando un sistema desencadena acciones, confirme la intención de alto impacto y haga que los reintentos sean idempotentes para que el audio repetido o las reconexiones no dupliquen transacciones.
El habla contiene información de identidad, contenido, entorno y de terceros. Minimice la retención, cifre el transporte y el almacenamiento, controle el acceso, defina la eliminación y distinga el audio de las transcripciones y embeddings derivados. Proporcione indicadores visibles de grabación y alternativas cuando no haya consentimiento. Un modelo local puede reducir la transferencia pero aún requiere permiso y controles de ciclo de vida.
Ejemplo práctico: un agente de voz que maneja interrupciones y correcciones
Un llamante dice: “Reserve el martes—no, el miércoles por la tarde”, mientras el agente comienza a responder después de “martes”. El reconocimiento en streaming genera transcripciones parciales cambiantes, la detección de final identifica el habla continua y la interrupción detiene la salida. El estado del diálogo marca la fecha anterior como reemplazada en lugar de crear dos solicitudes. La confirmación de entidad se centra en la fecha y hora corregidas, mientras el sistema conserva la confianza y la evidencia para la interpretación final.
La arquitectura separa la captura de audio, la detección de habla, el reconocimiento en streaming, la gestión de hablantes, la política de diálogo, la ejecución de herramientas y la síntesis. Los números de secuencia y la finalización evitan que resultados parciales tardíos sobrescriban la transcripción final. La herramienta de reserva acepta una solicitud estructurada, verifica la autorización y disponibilidad, y utiliza una clave de idempotencia. Una reserva consecuente se lee y confirma antes de ejecutarse; una reconexión no puede repetirla silenciosamente.
Las pruebas combinan precisión de palabras y de entidades con latencia de detección, éxito de interrupción, manejo de correcciones, atribución de hablantes, finalización de tareas y tasa de acciones duplicadas. Los escenarios abarcan ruido, superposición, acentos, cambio de código, habla lenta, dispositivos de asistencia, redes débiles y ataques sintéticos. La retención de audio se minimiza y se divulga, los datos de terceros se manejan explícitamente y los usuarios pueden cambiar a texto o a un humano. La inteligencia conversacional se mide por la recuperación segura y el resultado, no solo por la precisión de la transcripción.
Lista de verificación para la implementación práctica
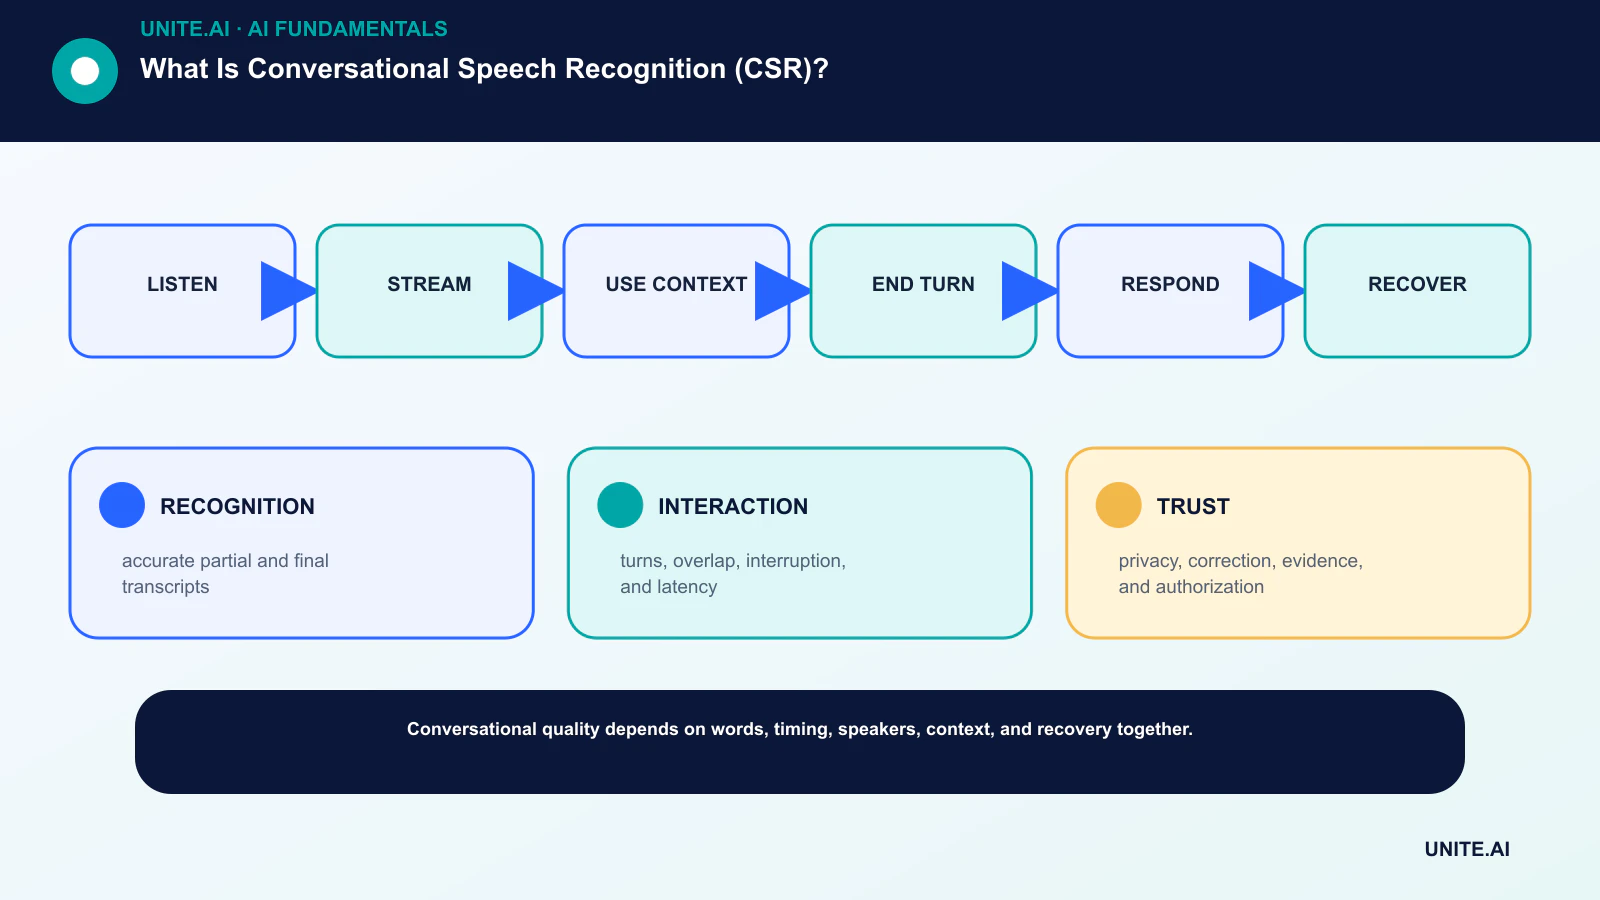
Convierta el concepto en un flujo de trabajo delimitado y verificable: escuchar → transmitir → usar contexto → terminar turno → responder → recuperarse. Asigne un responsable, documente los datos y dependencias, establezca una línea base sencilla, defina criterios de aceptación y de detención, pruebe fallas representativas y establezca monitoreo, retroceso y revisión antes de ampliar el alcance. Registre versiones y suposiciones para que otro equipo pueda reproducir el resultado y comprender qué cambió.
Antes del lanzamiento, realice una revisión de preparación documentada con las personas que construyen, operan, aseguran y se ven afectadas por el sistema. Pruebe casos normales, condiciones límite, fallas de dependencias y usos indebidos; preserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar el lanzamiento, cambiar un umbral, sobrescribir una salida o detener la operación. Revise la decisión cuando lleguen datos del mundo real, ya que un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- RECONOCIMIENTO: transcripciones parciales y finales precisas.
- INTERACCIÓN: turnos, superposición, interrupción y latencia.
- CONFIANZA: privacidad, corrección, evidencia y autorización.
Preguntas frecuentes
¿El CSR es diferente del ASR?
El ASR es el componente de conversión de voz a texto. El CSR utiliza el ASR más el contexto del diálogo, el ritmo, la gestión de hablantes y de finales, y políticas de interacción para conversaciones en tiempo real.
¿Una tasa de error de palabras más baja garantiza un agente de voz mejor?
No. Un sistema puede transcribir con precisión y, sin embargo, interrumpir a los usuarios, responder con lentitud, atribuir erróneamente a los hablantes o realizar la acción equivocada. Se requieren métricas de interacción de extremo a extremo.
Referencias principales












