
Fundamentos de la IA
¿Qué es el teorema de Bayes?

 Añade Unite.AI a tus fuentes preferidas en Google
El teorema de Bayes describe cómo actualizar la probabilidad de una hipótesis después de observar evidencia. Conecta la probabilidad de la evidencia dada una hipótesis con la probabilidad de la hipótesis dada esa evidencia.
Esta distinción es fundamental para el razonamiento estadístico y el aprendizaje automático. Una prueba puede ser muy precisa cuando una condición está presente, mientras que un resultado positivo aún tiene una probabilidad modesta de indicar la condición si ésta es rara.
Conclusiones clave
- El posterior combina una creencia previa con la verosimilitud de la evidencia observada.
- El término de evidencia normaliza las hipótesis posibles.
- Las tasas base pueden dominar evidencia aparentemente fuerte.
- Naive Bayes asume que las características son condicionalmente independientes dado la clase, no independientes en todas las circunstancias.
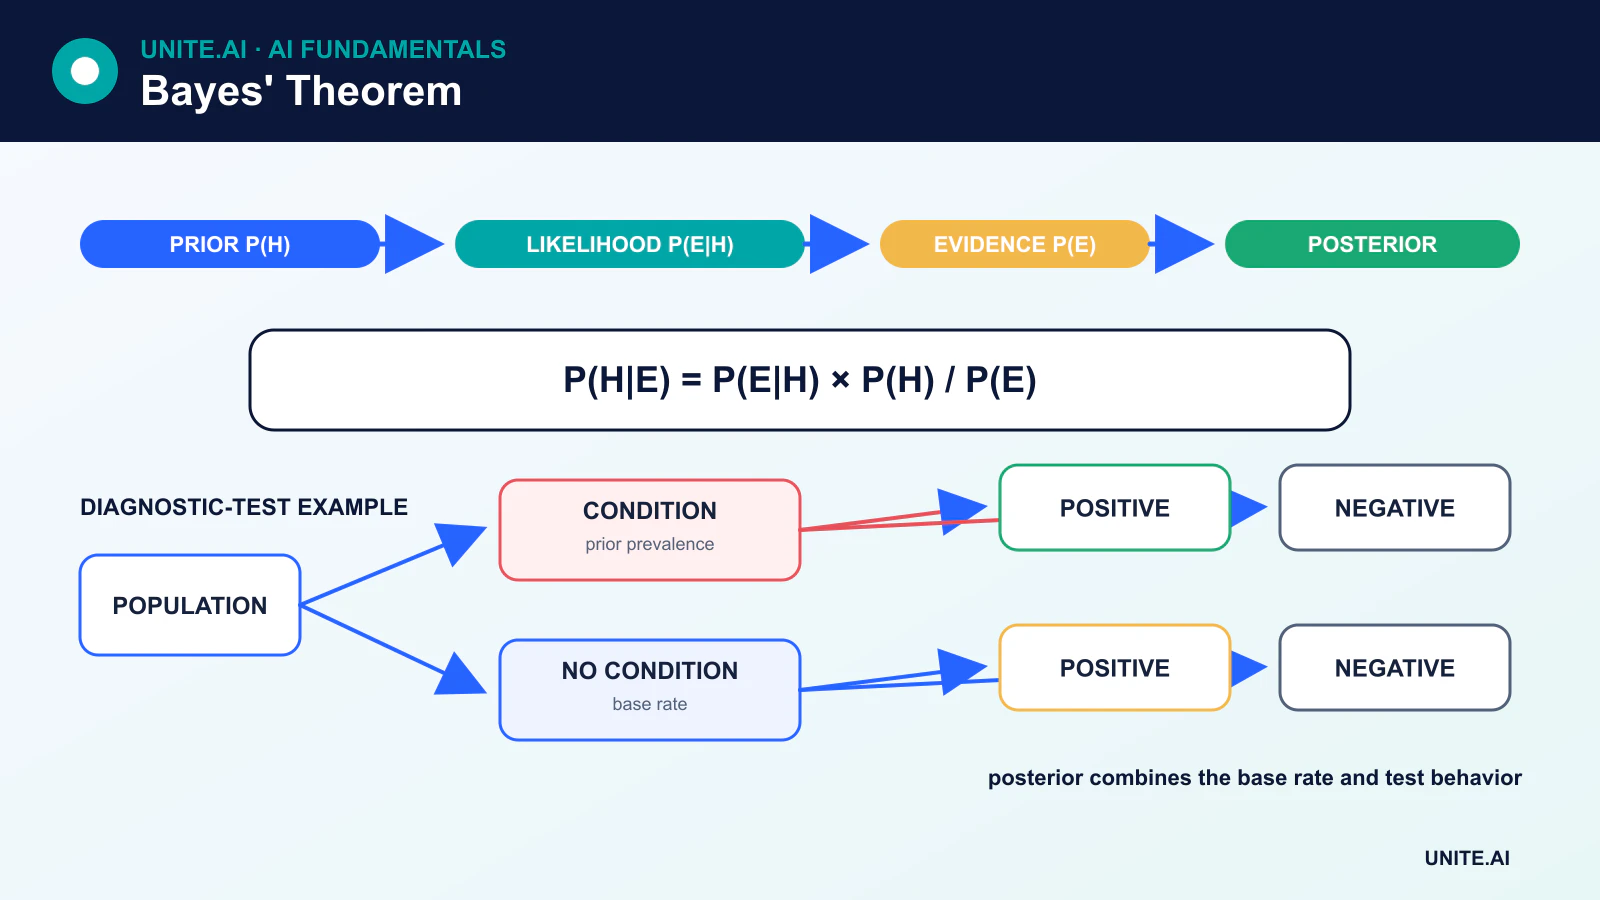
La fórmula
P(A|B) = P(B|A)P(A) / P(B)
- P(A) es la probabilidad a priori de la hipótesis A.
- P(B|A) es la verosimilitud de observar la evidencia B si A es verdadera.
- P(B) es la probabilidad total de la evidencia.
- P(A|B) es la probabilidad posterior de A después de observar B.
El teorema se deduce de dos expresiones equivalentes para la probabilidad conjunta: P(A ∩ B) = P(B|A)P(A) y P(A ∩ B) = P(A|B)P(B).
Ejemplo numérico de tasa base
Supongamos que una condición afecta al 1 % de una población. Una prueba tiene una sensibilidad del 90 % y una tasa de falsos positivos del 5 %. Consideremos 1 000 personas:
- Aproximadamente 10 tienen la condición; la prueba detecta correctamente 9.
- Aproximadamente 990 no la tienen; una tasa de falsos positivos del 5 % marca alrededor de 50.
- Por lo tanto hay alrededor de 59 resultados positivos, de los cuales 9 son verdaderos positivos.
La probabilidad de la condición tras un resultado positivo es aproximadamente 9 / 59 ≈ 15 %, no 90 %. La sensibilidad de la prueba responde P(positivo | condición); el usuario suele querer P(condición | positivo). El teorema de Bayes las conecta mediante la tasa base.
Actualización bayesiana
A medida que llega nueva evidencia, un posterior puede convertirse en el a priori para la siguiente actualización. Un modelo bayesiano completo especifica hipótesis posibles, distribuciones a priori, una verosimilitud y la cantidad a inferir. La incertidumbre se representa con una distribución posterior en lugar de solo una estimación puntual.
El a priori debe documentarse y probarse su sensibilidad. Un a priori débilmente informativo puede regularizar valores poco plausibles, mientras que un a priori fuerte mal elegido puede dominar datos limitados.
Clasificadores Naive Bayes
Naive Bayes predice una clase y a partir de características x₁ … xₙ usando el teorema de Bayes y la suposición:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Se asume que las características son condicionalmente independientes una vez conocida la clase. Esto suele ser poco realista, pero el clasificador puede funcionar bien cuando las puntuaciones de clase resultantes siguen siendo útiles.
Variantes comunes
- Naive Bayes multinomial modela características tipo recuento y es común en la clasificación de documentos.
- Naive Bayes Bernoulli modela la presencia binaria de características.
- Naive Bayes gaussiano modela cada característica continua con una distribución gaussiana condicional a la clase.
- Naive Bayes categórico modela categorías discretas.
Suavizado y estabilidad numérica
Si un valor de característica nunca aparece con una clase durante el entrenamiento, una estimación de probabilidad sin suavizar puede volverse cero y eliminar todo el producto. El suavizado aditivo o al estilo de Laplace evita esto. Las implementaciones calculan probabilidades logarítmicas de modo que multiplicar muchos valores pequeños se convierta en sumar valores logarítmicos estables.
Probabilidades, puntuaciones y calibración
Las salidas de probabilidad de Naive Bayes pueden estar mal calibradas porque las características correlacionadas se cuentan efectivamente más de una vez. Un clasificador puede ordenar bien las clases mientras sobrestima la confianza. La calibración debe evaluarse con datos de validación cuando las probabilidades guían decisiones.
Bayes más allá de Naive Bayes
La inferencia bayesiana soporta modelos jerárquicos, pruebas A/B, estimación de parámetros científicos, pronósticos, toma de decisiones consciente de la incertidumbre y modelos gráficos probabilísticos. Métodos aproximados como Monte Carlo por cadenas de Markov y la inferencia variacional se utilizan cuando un posterior no puede calcularse en forma cerrada.
Errores comunes de razonamiento
- Confundir
P(A|B)conP(B|A). - Ignorar una tasa base rara o común.
- Tratar un a priori como objetivo o dejarlo sin documentar.
- Asumir que una alta verosimilitud implica automáticamente un posterior alto.
- Interpretar una asociación predictiva como causalidad.
Probabilidad condicional, probabilidades y evidencia
El teorema de Bayes relaciona la probabilidad de una hipótesis después de la evidencia con su probabilidad a priori, la verosimilitud de observar esa evidencia bajo la hipótesis y la probabilidad total de la evidencia. En forma de probabilidades, las probabilidades posteriores son iguales a las probabilidades a priori multiplicadas por una razón de verosimilitud. Esto separa lo que se creía antes de una prueba de cuán fuertemente la prueba distingue hipótesis. Una prueba que parece muy precisa aún puede producir muchos falsos positivos cuando la condición es rara porque la tasa base influye en el posterior.
La verosimilitud es una función de la hipótesis para datos observados fijos y no debe confundirse con la probabilidad de la hipótesis. La normalización de la evidencia suma o integra entre hipótesis competidoras. Las suposiciones de independencia condicional pueden simplificar el cálculo, como en Naive Bayes, pero deben verificarse respecto a sus consecuencias. Múltiples piezas de evidencia no pueden multiplicarse como independientes cuando comparten causas o duplican información. La dirección causal también importa: P(evidencia|hipótesis) no es generalmente P(hipótesis|evidencia), el clásico error de probabilidad inversa.
Elecciones de modelado, cálculo y uso en decisiones
El análisis bayesiano especifica un a priori, una verosimilitud y una distribución predictiva posterior. Los a priori pueden codificar conocimientos establecidos, regularizar muestras pequeñas o ser débilmente informativos; deben justificarse y probarse mediante análisis de sensibilidad. Los modelos conjugados proporcionan actualizaciones analíticas, mientras que Monte Carlo por cadenas de Markov, la inferencia variacional y los métodos secuenciales aproximan posteriors complejos. Diagnostique convergencia, tamaño efectivo de muestra, error de aproximación y plausibilidad predictiva a priori en lugar de reportar un número posterior sin verificaciones computacionales.
Una probabilidad posterior informa pero no elige por sí sola una acción. Las decisiones requieren pérdidas, beneficios, restricciones y alternativas disponibles. Evalúe los modelos probabilísticos con calibración, reglas de puntuación adecuadas y verificaciones predictivas posteriores en datos nuevos. Actualice solo con evidencia recopilada bajo un proceso modelado; el sesgo de selección y el desplazamiento de datos pueden invalidar la verosimilitud. Comuníquese intervalos creíbles y supuestos sin tratarlos como rangos de frecuencia garantizados. El teorema de Bayes es álgebra de probabilidad exacta, mientras que la calidad de una conclusión bayesiana depende del modelo y la evidencia suministrada.
Ejemplo práctico: interpretación de una prueba diagnóstica
Una prueba tiene una sensibilidad del 95 % y una especificidad del 90 %, pero la condición afecta solo al 1 % de la población examinada. Para 10 000 personas, se esperan aproximadamente 95 verdaderos positivos y 990 falsos positivos, lo que produce un valor predictivo positivo inferior al 9 %. El teorema de Bayes hace explícito el efecto de la tasa base. El cálculo indica la población, el umbral de la prueba y la incertidumbre en lugar de promocionar la sensibilidad como la probabilidad de que un resultado positivo sea correcto. Esta distinción también es fundamental para una ciencia de datos cuidadosa.
Los clínicos actualizan la probabilidad con evidencia adicional solo cuando se modela la dependencia entre pruebas. Un umbral de decisión incorpora el daño de una enfermedad no detectada, el riesgo de pruebas confirmatorias, el costo y la preferencia del paciente. La calibración se verifica en la población local, y los cambios en la prevalencia desencadenan una revisión. El posterior respalda la discusión y los pasos siguientes; no sustituye al diagnóstico confirmatorio. Los informes usan frecuencias naturales y análisis de sensibilidad para que pacientes y profesionales puedan observar cómo cambia la conclusión bajo supuestos plausibles.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes de ajustar. Pruebe casos ordinarios, condiciones límite, entradas mal formadas o ausentes, desplazamiento de distribución, interrupción de dependencias, uso indebido y los grupos o entornos más propensos a quedar desatendidos. Mida la calidad de la tarea junto con la calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la liberación, excepciones, cambios, retroceso y retiro. Utilice un despliegue por etapas, preserve una alternativa segura y verifique la monitorización con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de la entrada, el comportamiento de la salida, la versión del modelo o regla, la salud de las dependencias, las intervenciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita recuperación documentada, aprendizaje de incidentes, procedimientos de eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿Cuál es la diferencia entre una verosimilitud y una probabilidad?
Con los parámetros fijados, un modelo asigna probabilidad a los datos posibles. Con los datos observados fijados, la misma expresión puede verse como una función de verosimilitud sobre los valores de parámetros posibles. La fórmula numérica puede coincidir mientras que la interpretación difiere.
¿Es Naive Bayes una inferencia bayesiana completa?
Utiliza el teorema de Bayes para la clasificación bajo un modelo de fuerte independencia condicional. La inferencia bayesiana más amplia coloca distribuciones sobre cantidades desconocidas y razona con una distribución posterior.
Referencias principales












