
Interviews
Zaid Al Hamani, CEO und Gründer von Boost Security – Interview-Serie

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
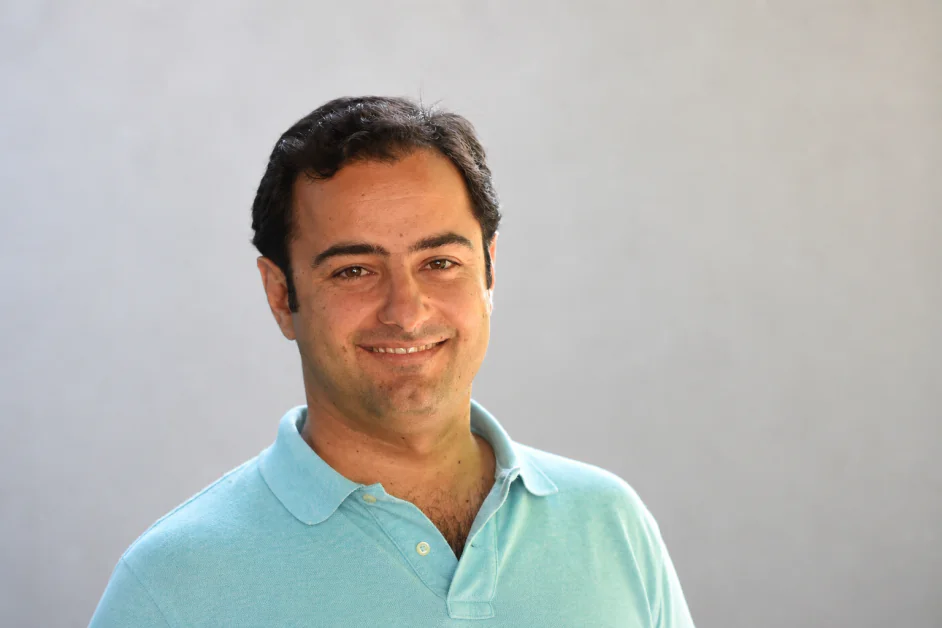
Zaid Al Hamani, CEO und Gründer von Boost Security, ist ein Cyber-Sicherheits- und DevSecOps-Experte mit über zwei Jahrzehnten Erfahrung im Aufbau und Skalieren globaler Technologie-Operationen. Seit der Gründung von Boost Security im Jahr 2020 konzentriert er sich auf die Modernisierung der Art und Weise, wie Organisationen die Software-Entwicklung sichern, und baut auf vorherigen Rollen wie VP of Application Security bei Trend Micro und Co-Founder/CEO von IMMUNIO auf. Zuvor hatte er leitende Positionen bei Canonical inne, wo er Produkte, Ingenieurwesen und globale Support-Initiativen leitete, und bei SITA, wo er große, kritische IT-Operationen managte. Seine Karriere spiegelt eine starke Erfolgsbilanz im Aufbau von Teams, Optimieren von Systemen und Förderung moderner Sicherheitspraktiken wider.
Boost Security ist ein Cyber-Sicherheits-Unternehmen, das sich auf die Sicherung der modernen Software-Lieferkette durch eine developer-orientierte DevSecOps-Plattform konzentriert. Die Technologie integriert sich direkt in CI/CD-Pipelines, um Schwachstellen automatisch zu erkennen, zu priorisieren und zu beheben, wodurch der manuelle Aufwand reduziert und die Entwicklungsgeschwindigkeit erhalten bleibt. Durch die Vereinigung von Anwendungs- und Lieferketten-Sicherheit in einem System bietet die Plattform eine vollständige Sichtbarkeit über Code, Abhängigkeiten und Infrastruktur, was Organisationen hilft, ihre Widerstandsfähigkeit in komplexen, cloud-nativen Umgebungen zu stärken.
Sie haben zuvor die Anwendungssicherheit bei Trend Micro geleitet und IMMUNIO mitgegründet. Was hat Sie dazu veranlasst, Boost Security zu gründen, und welche Lücke im Markt konnten Sie frühzeitig identifizieren?
IMMUN.IO war eines der ersten RASP-Unternehmen, das gegründet wurde – und unsere Erfahrung bis zu diesem Punkt war, dass WAFs als Laufzeit-Sicherheitstechnologie unmaintainable und nicht sehr effektiv waren. Wir haben uns eine Lösung vorgestellt, bei der WAFs durch eine genauere, einfacher zu maintainende Lösung ersetzt werden könnten – indem die Anwendung instrumentiert wird.
Das war im Jahr 2012, als DevOps noch in den Anfängen steckte und die meisten Teams nicht agil waren und Kubernetes noch nicht existierte.
Trend Micro erwarb IMMUN.IO im Jahr 2017. Zu diesem Zeitpunkt gab es bereits mehr DevOps-Praktiken: CI/CD-Pipelines, agile Entwicklungsmethoden, schnellere Iterationen und Release-Zyklen, Cloud usw. Software-Entwicklungsteams waren besser darin, Software zu erstellen und zu liefern. Die Sicherheit war jedoch immer noch gebrochen:
- Scans sind zu langsam oder die Ergebnisse kommen zu spät
- Die Ergebnisse sind zu komplex für Entwickler, um sie umzusetzen
- Es gibt eine generell unannehmbar hohe Falsch-Positiv-Rate
- Viele neue Arten von Artefakten werden nicht gescannt: Infrastruktur als Code, Container, APIs usw.
Die Erstellung von Software war einfacher. Die Erstellung von sicherer Software war jedoch immer noch schwierig.
Das war das ursprüngliche Problem, das wir zu lösen versuchten. DevSecOps im realen Leben funktionieren lassen; kann man ein Software-Entwicklungsteam dazu bringen, Sicherheit leicht in den SDLC zu integrieren, um mit den neuen Geschwindigkeitsstandards Schritt zu halten? Kann man die Abdeckung breit machen – wo eine Plattform alles ist, was man benötigt? Kann man es so machen, dass Entwickler nicht nur die Technologie annehmen, sondern auch die Vorteile sehen? Kann man es so skaliert machen, dass man keine Armeen von Sicherheitsfachleuten benötigt, um mit der Menge an Code zu halten…
Wir halfen Unternehmen, Sicherheit in den SDLC während der DevOps-Ära zu injizieren. Das war von 1 auf 10. Wir sind jetzt in der Ära des agentischen Codings – wo Agenten enormen Code schreiben – aber es ist im Grunde das gleiche Problem – Geschwindigkeit und Volumen des Codes sind von 10 auf 100 gestiegen; und wir zielen darauf ab, die gleiche Traektorie fortzusetzen.
Sie haben argumentiert, dass der Software-Entwicklungs-Lebenszyklus (SDLC) grundlegend nach oben verschoben wurde. Was war der Moment, in dem Sie erkannten, dass traditionelle DevSecOps-Ansätze nicht mehr ausreichten?
Es war, als ich sah, wie Angreifer tatsächlich hereinkamen. Wir sahen immer wieder das gleiche Muster: Eine offene GitHub-Actions-Workflow, die niemand seit der Fork des Repositorys überprüft hatte, ein Token mit Produktions-Cloud-Zugriff, der in einem Runner-Config eingebettet war, ein legitimer CI-Job, der von einem Angreifer gehijackt wurde, um Payloads zu deployen. Diese wurden als “living off the pipeline”-Angriffe bekannt, weil der Angreifer die eigene Automation gegen uns verwendet, mit den Credentials, die unser Sicherheitsteam bereits genehmigt hatte.
Der DevSecOps-Stack, den wir über ein Jahrzehnt aufgebaut hatten, hatte keine Antwort darauf. SAST-Scans scannen die Anwendungs-Quelle. SCA-Scans scannen die Anwendungs-Abhängigkeiten. Beide nehmen an, dass die Pipeline, die sie ausführt, vertrauenswürdig ist. Währenddessen ist die Pipeline selbst eine YAML-Datei mit Shell-Befehlen, Netzwerkzugriff und sensitiven Credentials, und fast niemand überprüft sie.
Wenn das der Weg des geringsten Widerstands wird, können Sie sauberen Code ausliefern und den Angreifern trotzdem Ihre Cloud übergeben.
Wie sollten Unternehmen den SDLC in einer Welt umdenken, in der AI-Agenten Code kontinuierlich generieren, anstatt dass Entwickler ihn Schritt für Schritt schreiben?
Wir müssen alle aufhören, über den SDLC als eine Sequenz von Checkpoints nachzudenken. AI-Agenten haben die Zeit zwischen “jemand hat dies geschrieben” und “dies ist in Produktion” von Wochen auf Minuten reduziert. Das alte Modell nahm an, dass es einen menschlichen Rhythmus zwischen Code-Review, SAST, SCA und Deploy gibt, aber wir sind darüber hinaus.
Sicherheit muss dort leben, wo der Agent operiert: auf dem Entwickler-Rechner, innerhalb des Prompt-Kontexts, in den Verbindungen des Agents zu MCP-Servern und externen Modellen. Wenn der Code die Pipeline erreicht, haben Sie bereits die Chance verpasst, ihn zu formen. Der Agent hat bereits die Abhängigkeit gezogen. Das Modell hat bereits die Credential gesehen. Die Kontrollen müssen nach oben verlagert werden, dorthin, wo die Arbeit tatsächlich stattfindet.
Viele Organisationen behandeln AI-Coding-Tools immer noch als einfache Produktivitäts-Schichten. Warum glauben Sie, dass sie eine völlig neue Angriffsfläche darstellen und nicht nur eine Erweiterung bestehender Workflows?
Die Behandlung eines AI-Coding-Tools als Produktivitäts-Schicht ist wie die Behandlung eines Junior-Entwicklers mit Root-Zugriff als Produktivitäts-Schicht. Die Bezeichnung ist technisch korrekt, aber sie gibt Ihnen keinen nützlichen Rahmen, um über das zu nachzudenken, was schiefgehen kann.
Ein Coding-Agent liest Ihre Dateisysteme, scrappt Umgebungsvariablen für Kontext, fetcht Abhängigkeiten von öffentlichen Registries, öffnet ausgehende Verbindungen zu Remote-Modell-Providern und MCP-Servern und führt Shell-Befehle aus. Jede dieser Aktionen erforderte früher einen Menschen im Loop. Jetzt geschehen sie in Millisekunden, mit den gleichen Privilegien wie der Entwickler, der den Agenten gestartet hat.
Diese Kombination von Vertrauensgrenzen, die früher getrennt waren: die Autorität des Entwicklers, was ein externes Tool fetchen kann und was untrusted Code ausführen kann. Das schafft neue Möglichkeiten für Angreifer und Blindspots, die Verteidiger nicht einmal sehen können, geschweige denn verteidigen können.
Boost Security betrachtet den Entwickler-Laptop als die neue Kontroll-Ebene. Welche Risiken bestehen auf dem Endpoint, die Sicherheitsteams derzeit übersehen?
Das größte Risiko ist das Inventar. Die meisten Sicherheitsteams können nicht sagen, welche AI-Agenten auf welchen Laptops laufen, welche MCP-Server diese Agenten ansprechen oder welche IDE-Erweiterungen gerade Repository-Inhalte scannen. EDR hat keine Sichtbarkeit in die Agent-Schicht; SIEM kann nicht sehen, was diese Agenten lokal tun. Es ist ein Shadow-IT-Problem mit Code-Execution-Privilegien.
Darunter liegt das Credential-Chaos. Wir haben ein Open-Source-Tool namens Bagel teilweise entwickelt, um dies greifbar zu machen. Ein typischer Entwickler-Laptop hält GitHub-Tokens mit Schreibzugriff auf Produktions-Repositorys, Cloud-Credentials, die Infrastruktur spinnen können, npm- oder PyPI-Tokens, die zu Millionen von Benutzern publishen können, und AI-Service-Schlüssel, die Angreifer weiterverkaufen. Keines davon ist so gehärtet wie ein CI-Runner. Die gleiche Maschine, die diese Credentials hält, browsed auch das Web und installiert willkürliche VS-Code-Erweiterungen.
Kombinieren Sie beide, und Sie haben die tatsächliche Angriffsfläche. Eine untrusted-Erweiterung, die mit Entwickler-Privilegien in einer Umgebung voller Cloud-Schlüssel läuft, ist das höchste-Risiko-Ziel im modernen Unternehmen. Die meisten Teams haben noch nicht einmal angefangen, danach zu suchen.
Sie haben den “Kontext-Falle”-Effekt hervorgehoben, bei dem AI-Agenten lokale Dateien, Umgebungsvariablen und Konfigurationen zugreifen können. Wie weit verbreitet ist das Risiko von Datenlecks durch Prompts, und warum ist es so schwierig, es zu erkennen?
So weit verbreitet, dass wir es als den Standardzustand jeder unverwalteten Entwicklerumgebung betrachten. Jeder Coding-Agent, den wir untersucht haben, greift lokalen Kontext aggressiv an. Sie lesen Dotfiles, Umgebungsvariablen, kürzlich geöffnete Dateien, manchmal ganze Verzeichnisbäume, und schicken diesen Kontext zu einem Remote-Modell. Die Tools sind so konzipiert, dass sie auf diese Weise funktionieren; aggressives Kontext-Grabbing ist das, was sie nützlich macht.
Das Erkennungsproblem beginnt, weil der Datenverkehr von einem Leck identisch mit normalem Produkt-Usage aussieht. Es ist TLS zu api.openai.com oder api.anthropic.com. Es kommt von einer genehmigten Geschäftsanwendung. Standard-DLP sieht einen Entwickler, der das AI-Tool verwendet, das das Unternehmen gerade lizenziert hat. Es sieht nicht, dass eine der Zeichenfolgen in diesem Prompt ein AWS-Geheimnis-Schlüssel ist, den der Agent aus einer halb vergessenen .env-Datei in einem Schwester-Verzeichnis gezogen hat.
Man kann es nur erkennen, indem man Prompts vor ihrem Verlassen des Laptops untersucht, was genau der Ort ist, an dem fast kein Sicherheits-Stack derzeit positioniert ist.
Sie erwähnen maschinelle Lieferketten-Angriffe. Können Sie ein realistisches Szenario durchgehen, in dem ein AI-Agent eine Schwachstelle einführt, bevor traditionelle Sicherheits-Tools sie identifizieren können?
Hier ist eines, das wir wiederholt gesehen haben. Ein Entwickler bittet einen Agenten, ein Feature hinzuzufügen, das eine HTTP-Retry-Bibliothek benötigt. Der Agent schlägt einen Paket-Namen vor. Das Paket klingt plausibel, existiert aber tatsächlich nicht auf npm. Innerhalb einer Stunde registriert ein Angreifer es, füllt es mit funktionierender Retry-Logik plus einem kleinen Post-Install-Script, das ~/.aws/credentials liest und den Inhalt an einen Webhook postet. Der Agent führt npm install aus, ohne zu überprüfen, weil Agenten nicht überprüfen. Die Credential ist weg, bevor der Entwickler den Code sogar ausführt.
Der Angriff selbst ist nicht technisch anspruchsvoll, aber traditionelle Lieferketten-Sicherheit basiert auf bekannten Schwachstellen in bekannten Paketen: CVEs, SBOMs, Lizenz-Scans. Dieses Framework hat nichts zu sagen über ein Paket, das nicht existierte, als der Scan zuletzt ausgeführt wurde, speziell erstellt wurde, um einer AI-Halluzination zu entsprechen, und vor jedem Threat-Feed-Update injiziert wird.
Das Fenster von der Veröffentlichung bis zur Kompromittierung wird jetzt in Minuten gemessen. Alles, was nachträglich überprüft wird, überprüft zu spät.
Sind halluzinierte Abhängigkeiten zu einem der größten Risiken in der AI-getriebenen Entwicklung geworden, und welche praktischen Schritte können Organisationen unternehmen, um sich davor zu schützen?
Sie sind bereits eines der größten. Angreifer überwachen aktiv beliebte AI-Tools auf Halluzinationen und registrieren die vorgeschlagenen Paket-Namen innerhalb von Minuten. Forscher vor ein paar Jahren, als es zum ersten Mal passierte, nannten es Slopsquatting, und der Name blieb haften. Sobald ein Abhängigkeits-Name häufig genug halluziniert wird, ist das Sitzen darauf ein passiver Lieferketten-Angriff mit nahezu null Aufwand.
Die praktischen Verteidigungen sehen anders aus als das, was die meisten Teams derzeit haben. Beginnen Sie bei der Aufnahme. Blockieren Sie typosquattede und neu registrierte Pakete im Moment, in dem npm install oder pip install ausgeführt wird, auf dem Entwickler-Rechner, bevor etwas auf die Festplatte gelangt. Postmortem-Erkennung in CI hilft nicht, wenn ein Post-Install-Script bereits eine Credential exfiltrated hat. Dann geben Sie dem Agenten Schutzvorkehrungen, um innerhalb zu operieren. Injizieren Sie Ihre genehmigte Abhängigkeitsliste direkt in den Kontext des Agents, damit das Modell sieht, was erlaubt ist, bevor es eine Vorschlagung generiert. Entwickler zu bitten, “sichere Prompts” zu schreiben, ist keine Strategie. Wenn Sie strategisch werden, bedeutet dies, dass Sicherheit die Grenze setzt, der Agent sie erbt. Und beginnen Sie mit der Verfolgung einer AI-Bill-of-Materials. Die meisten Teams können nicht sagen, welche Agenten, Modelle und Pakete welche Repositorys berühren. Man kann nicht verteidigen, was man nicht inventarisiert.
Sie haben gesagt, dass Sicherheit nicht mehr bei CI/CD beginnen kann. Wie sieht eine moderne Sicherheits-Pipeline aus, wenn der Schutz früher im Entwicklungsprozess beginnen muss?
Wenn Sicherheit bei CI/CD beginnt, haben Sie die gesamte pre-commit-Phase einer Umgebung überlassen, die Sie nicht kontrollieren. Der Agent hat bereits Kontext aufgenommen, Ihre Credential kann bereits in jemand anderem’s Logfiles sein. Sie scannen eine Leiche.
Eine moderne Pipeline beginnt auf dem Laptop. Das bedeutet, die Agenten und Erweiterungen zu inventarisieren, die darauf laufen, zu validieren, welche MCP-Server und Modelle sie ansprechen dürfen, zu sanitisieren, was das Gerät verlässt, und böswillige Pakete zu blockieren, bevor sie installiert werden. Von dort aus folgt die Richtlinie der Arbeit in die IDE. Wir injizieren Sicherheitsstandards direkt in den Kontext-Fenster des Agents, damit generierter Code von Anfang an innerhalb der Schutzvorkehrungen bleibt. Die Pipeline selbst verschwindet nicht. Ihre Rolle wird zur Verifizierung: Bestätigung, dass die upstream-Kontrollen gehalten wurden.
Die Pipeline selbst verschwindet nicht. Ihre Rolle wird zur Verifizierung: Bestätigung, dass die upstream-Kontrollen gehalten wurden.
Was sind die kritischsten Änderungen, die Organisationen heute vornehmen müssen, um sicherzustellen, dass ihre Entwicklungs-Umgebungen in den nächsten Jahren sicher bleiben?
Der größte Fehler ist, nur das zu sichern, was committet wird. Das interessante Risiko liegt jetzt in den acht Stunden vor einem Commit. Unbekannte Dramen können auf dem Laptop, im Prompt oder im Paket-Install ablaufen. Wenn Ihre Tools bei der PR beginnen, schützen Sie die falsche Hälfte des Workflows.
Eng damit verbunden: Hören Sie auf, Coding-Agenten als Produktivitäts-Software zu behandeln. Sie sind nicht-menschliche Benutzer mit Shell-Zugriff, Repository-Schreibberechtigungen und ausgehenden Netzwerk-Verbindungen. Regeln Sie sie wie Sie jede andere privilegierte Identität regeln, mit einem Inventar, genehmigten Fähigkeiten und Audit-Logs.
Der letzte Schritt ist kulturell schwieriger. Die meisten aktuellen “AI-Sicherheits”-Tools liefern Ergebnisse und leiten sie an Menschen weiter. Menschen können nicht mit der Geschwindigkeit von Agenten triagieren. Was immer Sie adoptieren, muss Probleme automatisch innerhalb des Workflows mit nachvollziehbarer Argumentation lösen, oder es wird zu einem weiteren Dashboard, das niemand liest.
Vielen Dank für das großartige Interview. Leser, die mehr erfahren möchten, sollten Boost Security besuchen.


