
Vordenker
Drei Techniken zum Erhalt der Privatsphäre in der maschinellen Lernen, die das wichtigste Problem dieses Jahrzehnts lösen

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Von Amogh Tarcar, Forscher für maschinelles Lernen und KI, Persistent Systems. (PERSISTENT.BO )
Die Datenprivatsphäre wird, laut Experten aus verschiedenen Bereichen, das wichtigste Problem dieses Jahrzehnts sein. Dies gilt insbesondere für das maschinelle Lernen (ML), bei dem Algorithmen mit großen Mengen an Daten gefüttert werden.
Traditionell haben ML-Modellierungstechniken auf der Zentralisierung von Daten aus verschiedenen Quellen in einem einzigen Rechenzentrum basiert. Schließlich sind ML-Modelle am leistungsfähigsten, wenn sie Zugang zu großen Mengen an Daten haben. Es gibt jedoch eine Vielzahl von Datenschutzproblemen, die mit dieser Technik verbunden sind. Die Aggregation von diversen Daten aus verschiedenen Quellen ist heute aufgrund von regulatorischen Bedenken wie HIPAA, DSGVO und CCPA weniger machbar. Darüber hinaus erhöht die Zentralisierung von Daten den Umfang und die Größe von Datenmissbrauch und Sicherheitsbedrohungen in Form von Datenlecks.
Um diese Herausforderungen zu überwinden, wurden mehrere Säulen des Datenschutzes in der maschinellen Lernen (PPML) entwickelt, mit spezifischen Techniken, die das Datenschutzrisiko reduzieren und sicherstellen, dass die Daten vernünftigerweise sicher bleiben. Hier sind einige der wichtigsten:
1. Federated Learning
Federated Learning ist eine ML-Trainingsmethode, die das Datenaggregationsproblem auf den Kopf stellt. Anstatt Daten zu aggregieren, um ein einzelnes ML-Modell zu erstellen, aggregiert das federale Lernen die ML-Modelle selbst. Dies stellt sicher, dass die Daten nie ihre Quellposition verlassen und es mehreren Parteien ermöglicht, zusammenzuarbeiten und ein gemeinsames ML-Modell ohne direktes Teilen von sensiblen Daten zu erstellen.
Es funktioniert wie folgt. Sie beginnen mit einem Basis-ML-Modell, das dann mit jedem Clientknoten geteilt wird. Diese Knoten führen dann lokale Trainings auf diesem Modell mit ihren eigenen Daten durch. Modellaktualisierungen werden regelmäßig an den Koordinierungsknoten gesendet, der diese Aktualisierungen verarbeitet und sie zusammenfügt, um ein neues globales Modell zu erhalten. Auf diese Weise erhalten Sie die Erkenntnisse aus verschiedenen Datensätzen, ohne diese Datensätze teilen zu müssen.

Quelle: Persistent Systems
Im Kontext des Gesundheitswesens ist dies ein unglaublich leistungsfähiges und datenschutzorientiertes Werkzeug, um Patientendaten sicher zu halten, während Forschern die Weisheit der Menge gegeben wird. Durch die Nichtaggregation von Daten schafft das federale Lernen eine zusätzliche Sicherheitsebene. Die Modelle und Modellaktualisierungen selbst stellen jedoch immer noch ein Sicherheitsrisiko dar, wenn sie verletzlich bleiben.
2. Differenzieller Datenschutz
ML-Modelle sind oft Ziel von Mitgliedschaftsinferenzangriffen. Angenommen, Sie teilen Ihre Gesundheitsdaten mit einem Krankenhaus, um bei der Entwicklung eines Krebsimpfstoffs zu helfen. Das Krankenhaus hält Ihre Daten sicher, verwendet jedoch das federale Lernen, um ein öffentlich verfügbares ML-Modell zu trainieren. Einige Monate später verwenden Hacker eine Mitgliedschaftsinferenz, um zu bestimmen, ob Ihre Daten für die Modelltrainierung verwendet wurden oder nicht. Sie geben dann Erkenntnisse an eine Versicherungsgesellschaft weiter, die, basierend auf Ihrem Krebsrisiko, Ihre Prämien erhöhen könnte.
Der differenzielle Datenschutz stellt sicher, dass Angriffe auf ML-Modelle nicht in der Lage sind, bestimmte Datenpunkte zu identifizieren, die während der Trainierung verwendet wurden, und damit das Risiko des Offenlegens sensibler Trainingsdaten im maschinellen Lernen verringert. Dies geschieht durch die Anwendung von “statistischem Rauschen”, um die Daten oder die ML-Modellparameter während der Trainierung zu stören, was es schwierig macht, Angriffe durchzuführen und zu bestimmen, ob die Daten einer bestimmten Person für die Modelltrainierung verwendet wurden.
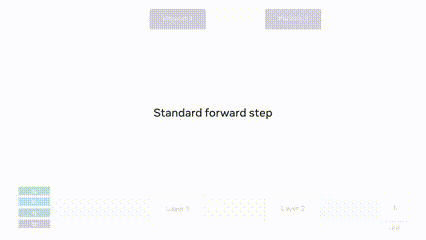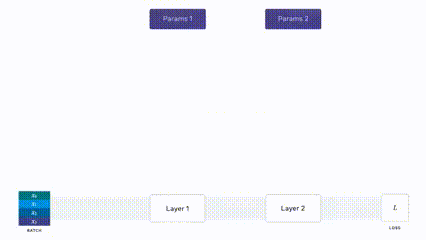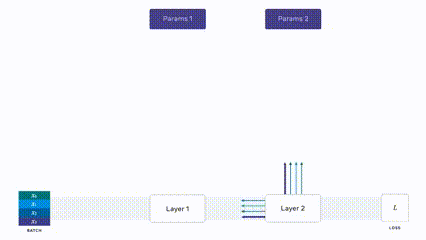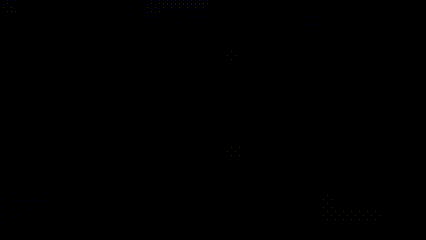
Beispielsweise hat Facebook kürzlich Opacus veröffentlicht, eine Bibliothek mit hoher Geschwindigkeit für die Trainierung von PyTorch-Modellen mit einem differenziellen Datenschutz basierten ML-Trainingsalgorithmus namens Differentially Private Stochastic Gradient Descent (DP-SGD). Das folgende GIF zeigt, wie es Rauschen verwendet, um Daten zu maskieren.
Quelle: Facebooks Opacus-Blog
Dieses Rauschen wird durch einen Parameter namens Epsilon gesteuert. Wenn der Epsilon-Wert niedrig ist, hat das Modell perfekten Datenschutz, aber schlechte Nützlichkeit und Genauigkeit. Umgekehrt, wenn Sie einen hohen Epsilon-Wert haben, verringert sich der Datenschutz, während die Genauigkeit steigt. Der Trick besteht darin, ein Gleichgewicht zu finden, um sowohl Datenschutz als auch Nützlichkeit zu optimieren.
3. Homomorphe Verschlüsselung
Die Standardverschlüsselung ist traditionell mit dem maschinellen Lernen unvereinbar, da die Daten nach der Verschlüsselung nicht mehr vom ML-Algorithmus verstanden werden können. Die homomorphe Verschlüsselung ist jedoch ein spezielles Verschlüsselungsschema, das es uns ermöglicht, bestimmte Arten von Berechnungen durchzuführen.

Quelle: OpenMined
Die Macht dieser Technik liegt darin, dass die Trainierung in einem vollständig verschlüsselten Raum stattfinden kann. Sie schützt nicht nur die Datenbesitzer, sondern auch die Modellbesitzer. Der Modellbesitzer kann Inferenz auf verschlüsselten Daten durchführen, ohne sie jemals zu sehen oder zu missbrauchen.
Wenn diese Technik auf das federale Lernen angewendet wird, kann die Fusion von Modellaktualisierungen sicher stattfinden, da sie in einem vollständig verschlüsselten Umfeld stattfindet, was das Risiko von Mitgliedschaftsinferenzangriffen erheblich reduziert.
Das Jahrzehnt des Datenschutzes
Wenn wir 2021 betreten, ist der Datenschutz in der maschinellen Lernen ein aufstrebendes Feld mit bemerkenswerter Forschung. Wenn das letzte Jahrzehnt darum ging, Daten aus den Silos zu befreien, wird dieses Jahrzehnt darum gehen, ML-Modelle aus den Silos zu befreien, während der Datenschutz der zugrunde liegenden Daten durch das federale Lernen, den differenziellen Datenschutz und die homomorphe Verschlüsselung gewährleistet wird. Diese Techniken bieten eine vielversprechende neue Möglichkeit, maschinelle Lernlösungen auf eine datenschutzorientierte Weise voranzutreiben.


