
Interviews
Nikunj Bajaj, Mitgründer und CEO von TrueFoundry – Interviewreihe

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
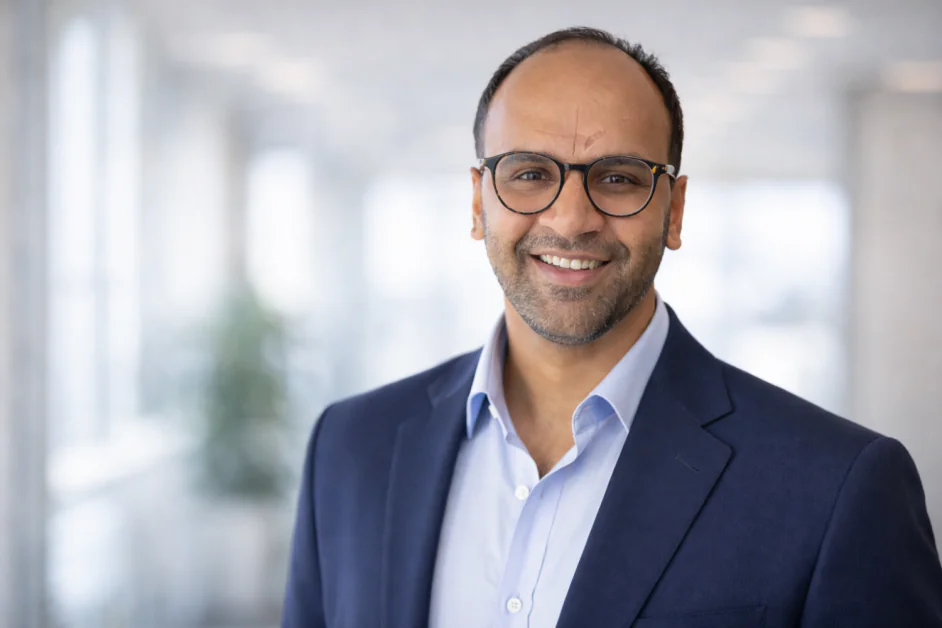
Vor der Gründung von TrueFoundry haben Sie in der Forschung zum maschinellen Lernen, an KI im Produktivbetrieb bei Facebook (META ) und an großen Empfehlungssystemen gearbeitet. Welche Erfahrungen haben Sie am unmittelbarsten dazu bewogen, ein Unternehmen für KI-Infrastruktur im Unternehmenseinsatz zu gründen, und welches Problem wurde Ihrer Ansicht nach damals noch nicht gelöst?
Bei Meta betrachteten wir maschinelles Lernen als Spezialfall von Software und generative KI als Spezialfall des maschinellen Lernens. Daraus ergab sich ein vertikaler Technologie-Stack mit Software unten, maschinellem Lernen in der Mitte und generativer KI oben. In dieser Struktur folgen die Modelle, die ich als Entwickler für maschinelles Lernen baue, demselben Bereitstellungsmuster wie die übrige Software. Das macht die Skalierung der Systeme sehr einfach.
Die meisten Unternehmen setzten jedoch parallele Stacks ein, also getrennte Stacks für Software, maschinelles Lernen und generative KI. Mit diesen parallelen Stacks wird die Skalierung komplexer, weil Übergaben zwischen dem Bereich des maschinellen Lernens und der Softwarewelt erforderlich sind.
Unser Team hat immer an der Schnittstelle zwischen der Entwicklung von Modellen für maschinelles Lernen und der entsprechenden Infrastruktur gearbeitet. Durch diese besondere Perspektive erkannten wir, dass wir ähnliche vertikale Stacks in Unternehmen einführen und an deren spezifische Anforderungen anpassen konnten. Gegen Ende 2021 hatten wir außerdem die Hypothese, dass maschinelles Lernen auf einen Wendepunkt zusteuerte. Sobald dieser erreicht wäre, würden mehr Unternehmen einen vertikal integrierten Stack benötigen, um diese Systeme effektiv bereitzustellen und zu skalieren. Das führte letztlich zur Gründung von TrueFoundry, und unsere Hypothese erwies sich als richtig. Die Einführung von KI beschleunigte sich nach dem Start von ChatGPT Ende 2022.
Was hat sich daran geändert, wie Organisationen über Zuverlässigkeit und Ausfälle nachdenken sollten, während KI-Systeme vom Experimentieren in den täglichen Betrieb übergehen?
Bei generativer KI steht erheblich mehr auf dem Spiel als bei traditionellen Systemen des maschinellen Lernens. Wenn diese Systeme in den Produktivbetrieb übergehen, müssen Organisationen mit deutlich mehr Mehrdeutigkeit und Nichtdeterminismus umgehen, weil LLMs von Natur aus stochastisch sind. Darauf aufbauende Agentensysteme bringen zusätzliche Mehrdeutigkeit mit sich.
Außerdem sind Ausfälle nicht mehr binär. Systeme funktionieren nicht einfach nur oder fallen aus; viele Probleme zeigen sich als Teilausfälle oder unbemerkte Verschlechterungen. Im Laufe der Zeit können Systeme mit höherer Latenz, geringerer Qualität oder fehlerhaftem Verhalten reagieren. In vielen Fällen sind solche Verschlechterungen schwerer zu erkennen und manchmal sogar schädlicher als ein vollständiger Ausfall.
Organisationen müssen Zuverlässigkeit nicht nur anhand der Betriebszeit bewerten, sondern auch anhand der Leistungsverschlechterung im Zeitverlauf.
TrueFailover wurde eingeführt während einer Welle viel beachteter Unterbrechungen bei Cloud- und KI-Diensten. Welche jüngsten Ereignisse zeigten deutlich, dass KI-Zuverlässigkeit von einer wünschenswerten Zusatzeigenschaft zu einer grundlegenden Architekturanforderung geworden war?
Einer unserer Kunden im Gesundheitswesen verarbeitet rezeptbezogene Patientenanfragen in Echtzeit, bei denen eine rechtzeitige Bearbeitung entscheidend ist. Er war von einer Betriebsunterbrechung betroffen, die durch einen Modellausfall verursacht wurde. Seine Workflows erwirtschaften Tausende Dollar Umsatz pro Sekunde, und die Unterbrechung beeinträchtigte einige dieser kritischen Abläufe. Der Kunde gehörte zu den frühen Nutzern von TrueFailover, sodass wir ihm bei der schnellen Wiederherstellung helfen und die Auswirkungen begrenzen konnten.
Solche Vorfälle werfen eine wichtige Frage auf: Wenn bei generativen KI-Systemen immer mehr auf dem Spiel steht, warum laufen Wiederherstellungsprozesse dann noch überwiegend manuell ab? Das bestärkte die Idee, dass Systeme in der Annahme gebaut werden sollten, dass Ausfälle eintreten, und so ausgelegt sein müssen, dass sie sich automatisch korrigieren. Zuverlässigkeit muss auch in den KI-Stack selbst eingebaut werden — mithilfe von KI-Gateways, die zentrales Routing, Beobachtbarkeit, Schutzmechanismen und intelligentes Umschalten zwischen Modellen verschiedener Anbieter ermöglichen.
Viele KI-Ausfälle werden noch immer als kleine technische Schwierigkeiten dargestellt. Wo zeigen sich Ihrer Ansicht nach die tatsächlichen wirtschaftlichen und menschlichen Kosten zuerst, wenn KI-Systeme ausfallen?
KI im Unternehmenseinsatz hat sich so weit entwickelt, dass diese Schwierigkeiten nicht mehr nur interne Workflows betreffen. Heute wirken sich Ausfälle und Verschlechterungen direkt und unmittelbar auf die öffentliche Wahrnehmung und die Gewinne aus, weil die Anwendungen im Produktivbetrieb inzwischen Kunden bedienen. Dieser Übergang von internen Tests zu öffentlich genutzten Anwendungen, bei denen viel auf dem Spiel steht, erklärt den wachsenden Bedarf an Aufmerksamkeit und Aufsicht durch die Unternehmensführung.
Je tiefer KI-Systeme in betriebliche Workflows eingebettet sind, desto weniger sind Ausfälle nur technische Probleme. Sie haben zunehmend direkte Folgen für das Geschäft, die Kunden und den Ruf des Unternehmens.
Wie schnell können KI-Ausfallzeiten in geschäftskritischen Umgebungen wie Apotheken, dem Gesundheitswesen oder dem Kundensupport zu betrieblichen Risiken oder Reputationsrisiken führen?
In geschäftskritischen Umgebungen eskaliert die Situation fast sofort, weil diese Systeme zeitkritische Echtzeit-Workflows unterstützen. Selbst eine kurze Unterbrechung kann kritische Prozesse stoppen, die Leistungserbringung verzögern oder nachgelagerte Systeme unterbrechen, die von diesen Ergebnissen abhängen. Dadurch entstehen kaskadenartige betriebliche Auswirkungen im gesamten Unternehmen.
In Bereichen wie dem Gesundheitswesen reichen die Folgen über die Betriebsunterbrechung hinaus und betreffen auch das Kundenerlebnis und die Ergebnisse der Dienstleistungen. Wenn ein Patient seine verschriebenen Medikamente nicht rechtzeitig erhalten kann, kann das reale Folgen haben. Das ist nicht nur ein Problem für den Patienten, sondern kann auch dem Ruf einer Apotheke oder eines Gesundheitsdienstleisters schaden. In geschäftskritischen Umgebungen, in denen Vertrauen eine Rolle spielt, ist es von höchster Bedeutung, dass Systeme online bleiben. Deshalb erkennen Organisationen zunehmend, dass KI-Systeme in der Annahme entworfen werden müssen, dass Ausfälle auftreten, und dass Wiederherstellungsmechanismen automatisch aktiviert werden müssen, um das Risiko zu minimieren.
Sie haben gesagt, dass viele Teams ihre Architektur eher auf Fähigkeiten als auf Kontinuität ausrichten. Warum hatte Resilienz Ihrer Ansicht nach bei der Gestaltung von KI-Systemen bisher eine geringere Priorität?
Das liegt weitgehend an den Anreizen innerhalb der Organisationen. Neue Fähigkeiten sind sichtbar und begeistern. Sie eröffnen Demos, Funktionen und Produktmöglichkeiten, die die Führung sofort erkennen kann.
Kontinuität ist definitionsgemäß unsichtbar, wenn alles gut funktioniert. Deshalb belohnen Anreizsysteme tendenziell die Einführung neuer Funktionen stärker als die Sicherstellung, dass nichts ausfällt. In der Folge investieren Organisationen oft unverhältnismäßig viel in die Entwicklung von Fähigkeiten im Vergleich zur technischen Absicherung der Resilienz.
Welche neuen Schwachstellen entstehen im KI-Stack durch die zunehmende Abhängigkeit von externen Modellen und APIs, deren Bedeutung Führungskräfte möglicherweise noch nicht vollständig erkennen?
LLMs sind grundsätzlich gemeinsam genutzte Ressourcen, und Unternehmen besitzen sie nicht so, wie sie herkömmliche Infrastruktur besitzen. Außerdem laufen wichtige geschäftskritische Systeme in Unternehmen auf externen Systemen, die sich noch nicht vollständig über längere Zeit bewährt haben. LLMs selbst entwickeln sich schnell weiter. Das bedeutet, dass ein Modellanbieter nicht für Aspekte wie Latenz oder eine leichte Verschlechterung der Modellleistung verantwortlich gemacht werden kann, weil er seine Forschung sehr schnell in weiteren Iterationen vorantreibt.
Da LLMs gemeinsam genutzte Ressourcen sind, kann die Latenz sprunghaft ansteigen, wenn ein anderer Nutzer eine bestimmte Aktion ausführt. Die grundlegende Natur von LLMs bringt viele solche Fehlerquellen mit sich, und Unternehmen haben in dieser neuen Welt einfach keine vollständige Kontrolle. Ohne vollständige Kontrolle kann ein Unternehmen am besten ausreichende Systemredundanz schaffen, um ein resilientes System zu entwerfen.
Ohne uns auf bestimmte Produkte zu konzentrieren: Wie sollten Organisationen ihre KI-Architektur neu denken, um Ausfälle vorauszusetzen, statt Unterbrechungen als seltene Randfälle zu behandeln?
Organisationen sollten zu den Grundprinzipien des Entwurfs verteilter Systeme zurückkehren. Softwaresysteme wurden in der Annahme gebaut, dass Netzwerkkomponenten und Maschinen ausfallen und eine ganze Region außer Betrieb geraten könnte.
Bei KI-Systemen sollte es nicht anders sein. Wir sollten davon ausgehen, dass Modellanbieter Latenzprobleme, Verschlechterungen oder Ausfälle erleben, und Redundanz vorsehen, damit Anwendungen in unterschiedlichen Ausfallszenarien resilient bleiben.
Erwarten Sie, dass KI-Resilienz bei der Auswahl von Plattformen und Anbietern entscheidend wird, ähnlich wie Betriebszeit und Redundanz die Entscheidungen über Cloudinfrastruktur geprägt haben?
Wenn mehr KI-Systeme in den Produktivbetrieb gehen, wird Resilienz zur Mindestanforderung. Kann ein Anbieter keine Diagramme und Kennzahlen zur Betriebszeit und zur allgemeinen Resilienz vorlegen, wird er nicht einmal in Betracht gezogen. Sobald Resilienz eine grundlegende Erwartung an alle Anbieter ist, verlagern sich die entscheidenden Kriterien auf Nutzererlebnis, Leistungsoptimierung, Beobachtbarkeit und übergeordnete Produktfähigkeiten. Mit der Zeit werden Komponenten wie ein KI-Gateway und automatische Failover-Funktionen zu zentralen Grundbausteinen der KI-Infrastruktur in Unternehmen.
Was bedeutet künftig wirklich „produktionsreife“ KI in einer Welt, in der KI durchgehend verfügbar und nicht nur gelegentlich nützlich sein soll?
Produktionsreife KI-Systeme sollten beobachtbar, steuerbar und wiederherstellbar sein. Alle drei Anforderungen müssen erfüllt sein.
Damit KI im Produktivbetrieb beobachtbar ist, benötigen Teams tiefe Einblicke in Modellverhalten, Latenz, Fehlerquoten, Tokenverbrauch, Drift und Ausfallmuster. Ohne ausgeprägte Beobachtbarkeit ist es sehr schwierig, Verschlechterungen zu erkennen, bevor Nutzer sie bemerken.
Zur Steuerbarkeit von Systemen gehören die Regulierung des Datenverkehrs, die Begrenzung der Anfragerate, Schutzmechanismen, die Durchsetzung von Richtlinien und intelligentes Routing zwischen Modellen und Anbietern. Hier wird ein KI-Gateway grundlegend: Es fungiert als zentrale Steuerungsebene, die Schutzmechanismen durchsetzt, konsistente Governance gewährleistet und einen dynamischen Modellwechsel ermöglicht, wenn Leistung oder Zuverlässigkeit nachlassen.
Schließlich sollten Systeme für die Wiederherstellbarkeit in der Annahme gebaut werden, dass Komponenten teilweise oder vollständig funktionsunfähig sein können — sei es durch Anbieterausfälle, verschlechterte Modellqualität, Begrenzungen der Anfragerate oder unerwartete Eingaben böswilliger Akteure. Automatisches Failover und Selbstheilungsmechanismen sollten in die Architektur integriert sein, statt von manuellen Abläufen abzuhängen, die erst nach einem Problem ausgelöst werden.
In diese Richtung arbeiten wir bei TrueFoundry. Anbieter, die Produktionsreife auf diese Weise definieren und Beobachtbarkeit, zentrale Steuerung und automatisierte Wiederherstellung verbinden, werden langfristig das Vertrauen ihrer Kunden gewinnen und weiterhin neue Probleme lösen können, sobald sie entstehen.
Vielen Dank für das großartige Interview. Leser, die mehr erfahren möchten, können TrueFoundry besuchen.


