
Interviews
Dr. Mathilde Pavis, Leiterin des Rechtsbereichs, OpenOrigins – Interviewreihe

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
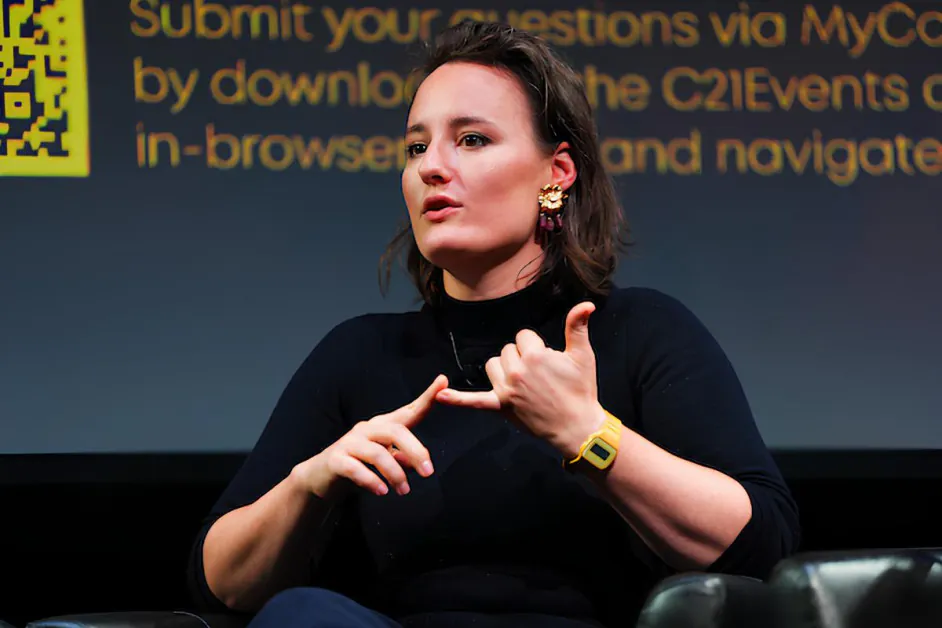
Dr. Mathilde Pavis, Leiterin des Rechtsbereichs bei OpenOrigins, ist eine führende Expertin für die Regulierung von künstlicher Intelligenz und digitale Medien, spezialisiert auf Deepfakes, synthetische Medien und Content-Provenienz. Sie berät Unternehmen, Regierungen und Gewerkschaften in Fragen der Einhaltung von Vorschriften, Lizenzen und Risiken im Bereich der generativen künstlichen Intelligenz und hat mit Microsoft (MSFT ) und ElevenLabs an der Strategie und Politik für künstliche Intelligenz gearbeitet. Sie hat auch die UNESCO in Fragen der künstlichen Intelligenz und des geistigen Eigentums beraten und trägt regelmäßig Expertenbeweise bei, um britischen Politikern zu helfen.
OpenOrigins entwickelt Technologien, um Fehlinformationen und Deepfakes zu bekämpfen, indem sie verifizierbare, unveränderliche Aufzeichnungen digitaler Inhalte erstellt. Die Plattform konzentriert sich auf die Herstellung klarer Provenienz, sodass Medien, Ersteller und Plattformen nachweisen können, wann und wie Inhalte erstellt, bearbeitet und verbreitet wurden – eine immer kritischere Fähigkeit, da synthetische Medien fortschrittlicher und schwerer zu erkennen sind.
Sie haben Regierungen, globale Institutionen wie die UNESCO und Unternehmen wie Microsoft und ElevenLabs in Fragen der Regulierung von künstlicher Intelligenz beraten. Was hat Sie dazu geführt, sich speziell auf Deepfakes, digitale Replikate und synthetische Medien zu konzentrieren, und wie hat diese Reise Ihre Entscheidung beeinflusst, Replique zu gründen?
Meine Arbeit an Deepfakes begann nicht mit der Technologie – sie begann mit einem viel älteren juristischen Rätsel. Als ich 2013 mit meiner Promotion zum Thema geistiges Eigentum begann, war ich erstaunt, wie viel weniger Schutz die Ausführenden im Vergleich zu Autoren, Komponisten oder Filmemachern erhalten. In der Praxis bedeutet dies, dass Ihre Worte oder Ihre Musik besser geschützt sind als Ihre Stimme, Ihr Gesicht und Ihr Körper. Diese Ungleichheit fühlte sich seltsam an und trieb mich dazu, eine tiefere Frage zu stellen: Wie schätzen wir kulturell und rechtlich die Arbeit eines Menschen ein, dessen Beitrag sein Gesicht, seine Stimme und sein Körper auf dem Bildschirm ist?
Diese Frage führte mich zu den Rechten der Ausführenden und Daten. Zu diesem Zeitpunkt galt dieses Gebiet als Nische mit geringer kommerzieller Relevanz. Man riet mir, in lukrativere Bereiche wie Patente oder traditionelles Urheberrecht zu wechseln. Die Annahme war, dass Fragen im Zusammenhang mit der Ähnlichkeit oder Stimme einer Person in erster Linie durch Branchennormen oder “Gentlemen’s Agreements in Hollywood” geregelt würden. Aber für mich signalisierte dieser Mangel an formalem Schutz eine Lücke, kein totes Ende für meine Forschung, also blieb ich dabei.
Was sich geändert hat, ist, dass heute fast jeder ein Ausführender ist. Unser Leben wird durch Kameras vermittelt – auf Smartphones, Laptops, Videokonferenzen und sozialen Plattformen. Ob für die Arbeit oder den persönlichen Gebrauch, Menschen nehmen und teilen ständig Versionen von sich selbst auf. Die rechtlichen Fragen, die einst hauptsächlich für Schauspieler oder Musiker galten, gelten jetzt für jeden, der ein Smartphone besitzt.
Deepfakes haben diese Probleme nicht geschaffen – sie haben sie bloßgestellt und beschleunigt. Die Forschung, die ich von 2013 an betrieben habe, wurde plötzlich dringend. Um 2017 und 2018 herum begannen Entwicklungen in neuronalen Netzen – insbesondere aus Orten wie dem MIT und der UC Berkeley – zu zeigen, wie überzeugend das Gesicht, die Stimme und der Körper einer Person digital manipuliert werden können. Innerhalb eines Jahres wurde diese Fähigkeit weithin als “Deepfakes” bekannt und gewann zunächst in tief schädlichen Formen, insbesondere durch nicht einvernehmliche sexuelle Inhalte, die sich gegen Frauen und Kinder richteten, an Popularität.
Erst später traten die kommerziellen Auswirkungen in den Vordergrund, als die kreativen Branchen synthetische Medien zu übernehmen begannen. Das ist der Zeitpunkt, an dem die vertraglichen und wirtschaftlichen Fragen, an denen ich gearbeitet hatte, in den Vordergrund traten. Fast über Nacht wurde das, was als weitgehend theoretisches oder doktrinäres Rechtsgebiet galt, zu einem hochgradig praktischen, kommerziell bedeutenden und sozial dringenden Feld.
Im Kern hat sich die rechtliche Herausforderung nicht geändert: Menschen möchten Aspekte von sich selbst teilen, aber gleichzeitig eine sinnvolle Kontrolle behalten. Bestehende Rahmenbedingungen kämpfen mit dieser Nuancen. Sie neigen dazu, Einzelpersonen entweder als vollständig privat oder vollständig öffentlich zu behandeln – entweder geschützt oder als Freiwild. Aber die meisten Menschen existieren irgendwo dazwischen. Diese Spannung ist nun nicht nur für professionelle Ausführende, sondern für jeden, der am digitalen Leben teilnimmt, zentral.
Ich wurde als jemand bekannt, der in diesem Bereich forscht und arbeitet, was mich dazu führte, mit Regierungen zusammenzuarbeiten, die daran interessiert sind, Menschen vor Deepfakes zu schützen, und mit Unternehmen, die digitale Klon-Produkte sicher zu verwenden wünschen, wie z.B. ElevenLabs. Bei Replique bringe ich alles, was ich gelernt habe, zu Menschen und Unternehmen, die digitale Klon- oder Replik-Technologie verantwortungsvoll und sicher nutzen möchten. Ich habe im Wesentlichen meine “blauen Himmel”-Forschung in ein Beratungsunternehmen umgewandelt, das spezialisierte Rechtsberatung für die kreativen Branchen anbietet.
Als Leiterin des Rechtsbereichs bei OpenOrigins, einem Unternehmen, das sich auf die Herstellung unveränderlicher Aufzeichnungen der Inhaltsprovenienz zur Bekämpfung von Deepfakes konzentriert, wie sehen Sie die Provenienz-basierten Systeme im Wettbewerb mit oder als Ersatz für herkömmliche Deepfake-Erkennungsansätze?
Der Vergleich von Deepfake-Erkennungstools kann schnell zu einem Vergleich von Äpfeln und Orangen werden, da ihre Wirksamkeit von Kontext und Zweck abhängt. Aus politischer Sicht benötigen wir eine Reihe von komplementären Tools – es gibt keine einzige “beste” Lösung, und Open Origins ist ein Teil dieses umfassenderen Ökosystems. Wo die Technologie von OpenOrigins als Deepfake-Erkennungslösung hervorsticht, ist in Situationen, in denen ein Inhaltscreator oder eine Informationsorganisation die Authentizität des Inhalts, den sie mit Partnern, Publikum oder der Öffentlichkeit teilt, nachweisen muss.
Durch die Bereitstellung verifizierbarer Provenienz und “Quittungen” bei der Erstellung bietet es eine starke Form der Prävention, indem es nachweist, dass der Inhalt kein Deepfake ist. Diese Herangehensweise ist jedoch weniger nützlich für den täglichen Internetnutzer, der den Inhalt, den er online trifft, schnell bewerten möchte. In solchen Fällen hängt die Erkennung mehr von wahrscheinlichen und inhaltsanalytischen Methoden als von provenienzbasierter Verifizierung ab. Wir benötigen unterschiedliche Tools für unterschiedliche Bedürfnisse, und wir müssen akzeptieren, dass es keinen silbernen Pfeil gegen Deepfakes gibt.
Aus rechtlicher Sicht, was ist derzeit die größte Lücke in der Art und Weise, wie Rechtsordnungen mit Zustimmung und Eigentum in künstlich generierten oder künstlich replizierten Inhalten umgehen?
Oof, wie viel Zeit haben Sie? Die Antworten hängen davon ab, was wir unter künstlich generierten oder replizierten Inhalten verstehen. Die Probleme variieren, ob Sie ein künstlich generiertes Bild eines Hauses oder einer Katze oder eine digitale Replikation des Gesichts oder der Stimme einer Person betrachten. Lassen Sie uns bei dem Thema Deepfakes und digitaler Replikation bleiben und Ihre Frage im Kontext der “digitalen Klonung” beantworten.
Bei der Zustimmung ist das Kernproblem, dass die meisten Verträge – ob Arbeitsverträge oder Plattformbedingungen – breite, vage Klauseln enthalten, die umfassende Rechte über Benutzerinhalte gewähren. Diese können als eine Art “Hintertür-Zustimmung” interpretiert werden, bei der die Zustimmung zu den Bedingungen als Zustimmung zu Nutzungszwecken wie Klonen angesehen wird, obwohl die meisten Menschen diese Interpretation stark bestreiten würden. Dies schafft eine erhebliche Lücke zwischen rechtlicher Interpretation und Nutzererwartung, die derzeit den Unternehmen zugute kommt, während die Regulierung hinterherhinkt.
Bei dem Eigentum gibt es keine klare rechtliche Antwort darauf, wer ein digitales Klonen besitzt, da bestehende Rahmenbedingungen wie Datenschutz, Urheberrecht und Persönlichkeitsrechte nicht für diese Technologie konzipiert wurden. Heute werden die meisten Menschen gescannt und geklont, wenn sie auf der Arbeit sind, auf Anfrage und mit der Finanzierung eines Arbeitgebers oder Kunden. Und diese Entitäten erwarten in der Regel einen hohen Grad an Kontrolle über dieses Asset, was verständlich, aber oft problematisch ist, da dieses Asset eine digitale Nachbildung Ihres Gesichts oder Ihrer Stimme ist und Sie Dinge sagen oder tun kann, die Sie nie gesagt oder getan haben.
Die Frage “Wem gehört Ihr Klon?” ist sehr wichtig, aber noch nicht im Recht beantwortet.
Sie haben eng an Sprachklon-Technologien gearbeitet. Was sind die am meisten missverstandenen rechtlichen Risiken, wenn es um synthetische Stimmen geht, sowohl für Unternehmen als auch für Einzelpersonen?
Das am meisten missverstandene Problem im Rechtsrahmen ist das Gleichgewicht zwischen dem kommerziellen Interesse eines Unternehmens an der Finanzierung und Ausbeutung eines digitalen Klons und dem Recht des Einzelnen auf Privatsphäre und digitale Würde. Diese Spannung liegt über mehrere Rechtsregime (hauptsächlich geistiges Eigentum, Datenschutz und Privatsphäre), die nie dafür konzipiert wurden, zusammenzuarbeiten, und interpretieren Klonen auf grundlegend unterschiedliche Weise. Als Ergebnis ist es komplex und oft unklar, dies in praktikable, unternehmensfreundliche Praktiken zu übersetzen. Unternehmen übersehen daher entweder wichtige Risiken oder entstehen erhebliche Kosten, um sie ordnungsgemäß zu bewältigen. Dies führt zu einem perversen Ergebnis, bei dem verantwortungsvolle Einhaltung der Vorschriften der schwierigere und teurere Weg ist, anstatt der Standard.
Wie sollten Unternehmen über die Architektur der Zustimmung in künstlichen Intelligenz-Systemen nachdenken, insbesondere wenn es um Ähnlichkeit, Identität und Trainingsdaten geht?
Unternehmen sollten ihre Systeme um drei Kernfähigkeiten herum entwerfen. Erstens müssen sie informierte, kontextuelle Zustimmung bei der Onboarding erhalten. Zweitens müssen sie es den Benutzern leicht machen, diese Zustimmung zurückzuziehen und einige oder alle ihrer Daten zu löschen, was technisch herausfordernd und oft übersehen wird, aber für die Einhaltung von Gesetzen wie der UK- und EU-Datenschutz-Grundverordnung und ähnlichen Regimen in den USA unerlässlich ist. Die Aufrechterhaltung der Zustimmung über die Zeit bedeutet den Aufbau von Systemen, in denen der Widerruf reibungslos und mit dem Geschäftsmodell abgestimmt ist.
Die Zustimmung muss granular sein. Und drittens sollten Benutzer in der Lage sein, Berechtigungen auf der Ebene einzelner Dateien zu verwalten, ihre Ähnlichkeitsdaten zu aktualisieren und zu verstehen, wie sie verwendet werden. Dazu ist Transparenz und Kontrolle erforderlich – Werkzeuge, die es Benutzern ermöglichen, zu überwachen, zu überprüfen und zu moderieren, wie ihre digitalen Klone eingesetzt werden. Diese Flexibilität ist noch selten, aber sie liegt zunehmend im Wettbewerbsvorteil.
Aus Ihrer Erfahrung als Beraterin für Start-ups und Regierungen, wo liegt die größte Diskrepanz zwischen der Art und Weise, wie künstliche Intelligenz aufgebaut wird, und der Art und Weise, wie sie reguliert wird?
Die Diskrepanz zwischen der Art und Weise, wie künstliche Intelligenz aufgebaut wird, und der Art und Weise, wie sie reguliert wird, liegt in den grundlegend verschiedenen Missionen. Regierungen regulieren im öffentlichen Interesse, während künstliche Intelligenz-Unternehmen (oft von Risikokapitalgebern unterstützt) in erster Linie von Wachstum, Umsatz und Gewinn getrieben werden. Diese Prioritäten stehen nicht immer im Widerspruch, aber sie ziehen oft in unterschiedliche Richtungen, wobei die Regulierung als Einschränkung und nicht als Unterstützung angesehen wird.
Dies schafft eine strukturelle Spannung: Regulierer und Innovatoren arbeiten mit unterschiedlichen Anreizen, Werten und sogar Sprachen. Dies macht die Ausrichtung in der Praxis schwierig, auch wenn sie nicht unmöglich ist. Wir sehen eine neue Welle von Technologieunternehmen, die sich enger an öffentliche Ziele ausrichten, aber sie bleiben die Ausnahme und nicht die Regel – insbesondere unter denen, die erfolgreich skaliert werden.
OpenOrigins konzentriert sich auf die Verifizierung von Inhalten bei der Erstellung mithilfe von kryptographischer Provenienz. Wie kritisch ist dieser originale Ansatz im Vergleich zu Sicherheitsmaßnahmen nach der Verteilung?
Dies führt zurück zu meiner vorherigen Antwort. Die Authentifizierung von Inhalten bei der Erstellung, also “upstream”, ist viel effektiver als der Versuch, sie bei der Verteilung oder sogar beim Verbrauch zu verifizieren, also “downstream”. Die Authentifizierung von Inhalten bei der Erstellung ist wie die Rückverfolgung von Lebensmitteln vom Moment ihrer Produktion auf der Farm, anstatt zu versuchen, es aus dem fertigen Gericht zu erraten. Wenn Sie wissen, wo das Huhn aufgezogen wurde, wie es gehandhabt wurde und wie es durch die Lieferkette ging, können Sie dem, was Sie essen, vertrauen. Wenn Sie stattdessen versuchen, all dies nur durch das Betrachten des fertigen Gerichts zu erraten, verlassen Sie sich auf Vermutungen. Es ist dasselbe mit der Unterscheidung zwischen menschlich erstellten und künstlich generierten Inhalten im Internet: Provenienz an der Quelle bietet verifizierbare Sicherheit, während die Erkennung nach der Verteilung inhärent unsicherer und reaktiv ist.
Welche Rolle sehen Sie für Standards wie C2PA in der Zukunft der Medien, und sind sie ausreichend, um das Vertrauen im Internet wiederherzustellen?
C2PA ist eine willkommene Initiative, und in vielen Aspekten unterstützt es die gleiche Bewegung für Inhaltsauthentizität wie OpenOrigins. Sie sind ein wichtiger Teil des Ökosystems für Inhaltsicherheit und -authentizität. Wie bei jedem Sicherheitstool gibt es keinen silbernen Pfeil.
Für Ersteller und Talente in Branchen wie Film, Musik und Gaming, welche praktischen Schritte sollten sie heute unternehmen, um sich vor nicht autorisierter digitaler Replikation zu schützen?
Künstler heute stehen vor zwei unterschiedlichen Risiken: der Replikation ihrer Arbeit (wie Musik, Bilder oder Schriften) und der Replikation ihrer Ähnlichkeit, einschließlich ihres Gesichts, ihrer Stimme und ihres Körpers. Mit minimalem Input können künstliche Intelligenz-Systeme beide mit hoher Treue reproduzieren. In praktischen Begriffen beginnt der Schutz damit, bewusst zu sein, was man online teilt, und zu erkennen, dass jeder veröffentlichte Inhalt abgerufen und für Trainingsdatensätze verwendet werden kann, oft ohne klare Zustimmung oder Sichtbarkeit.
Dieses Risiko ist nun eine Grundrealität des Online-Betriebs. Aber das unmittelbarere und kontrollierbarere Risiko liegt oft in Verträgen. Vereinbarungen, die Künstler mit ihren Mitarbeitern, Vertriebspartnern oder Plattformen treffen, können Klauseln enthalten, die die Verwendung von künstlicher Intelligenz, Wiederverwendung oder Wiederverkauf von Inhalten für Trainingszwecke erlauben – oft ohne bedeutende Beteiligung an den Erlösen.
Für Künstler macht dies die sorgfältige Prüfung von Verträgen kritisch. Das Verständnis, wie Ihre Arbeit und Ihre Ähnlichkeit verwendet, lizenziert oder wiederverwendet werden können, ist jetzt ebenso wichtig wie der kreative Prozess selbst. Viel der aktuellen Debatte (über Gewerkschaften, Branchenverbände und Plattformen) konzentriert sich auf die Korrektur dieser Ungleichheit und die Sicherstellung, dass Ersteller sowohl Kontrolle als auch faire Entlohnung behalten.
Also zwei wichtige Ratschläge: Seien Sie vorsichtig, was Sie online teilen, und lesen Sie Ihre Verträge und suchen Sie nach künstlichen Intelligenz-Klauseln, bevor Sie unterzeichnen.
Ausblick auf die nächsten drei bis fünf Jahre, glauben Sie, dass wir einen Punkt erreichen werden, an dem jeder digitale Inhalt verifizierbare Provenienz tragen muss, oder wird das Vertrauen weiterhin fragmentiert über Plattformen und Rechtsordnungen bleiben?
Ich würde gerne “ja” sagen, aber realistisch gesehen, nein – nicht innerhalb von fünf Jahren. In der Technologiebranche fühlt sich fünf Jahre lang; in Bezug auf die Änderung von Nutzerverhalten und -gewohnheiten ist es sehr kurz. Die meisten Verbraucher werden ihre Entscheidungen wahrscheinlich nicht auf der Grundlage treffen, ob der Inhalt authentifizierte Provenienz hat. Plattformen folgen in der Regel der Nutzernachfrage und optimieren für Engagement anstatt für Provenienz.
Dies könnte sich ändern, wenn die Regulierung eingreift. Wir sehen bereits erste Schritte in Orten wie Kalifornien, wo Kennzeichnungs- und Moderationsanforderungen entstehen, aber die Skalierung auf globaler Ebene wird Zeit beanspruchen – wahrscheinlich eher zehn Jahre als fünf.
Ein weiterer Bereich der Veränderung ist branchenspezifisch: Branchen wie Journalismus, Finanzen, Versicherungen und Gesundheitswesen könnten beginnen, Provenienz und Authentifizierung zu erfordern, da Vertrauen für ihre Betriebe grundlegend ist.
Zuletzt werden die Verbraucher vielleicht nicht um Provenienz-Informationen bemüht sein, aber sie werden wahrscheinlich um die Qualität des Inhalts und der Informationen bemüht sein. Wenn künstlich generierte Inhalte zu homogen oder “langweilig” werden, könnten die Zuhörer beginnen, menschlich erstellte Inhalte ausdrücklich zu schätzen. Dies könnte zu einer Segmentierung des Marktes führen, bei der einige Plattformen Skalierbarkeit und künstlich generierte Inhalte priorisieren und andere für Authentizität, Provenienz und hochwertige, von Menschen geführte Materialien kuratieren – aber diese Verschiebung bleibt ungewiss.
Vielen Dank für Ihre großartigen Antworten. Leser, die mehr erfahren möchten, sollten OpenOrigins besuchen.


