
Andersons Blickwinkel
Neuronales Rendering: Wie niedrig kann man in Bezug auf die Eingabe gehen?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen

Gestern hat eine außergewöhnliche neue Arbeit im Bereich der neuronalen Bildsynthese die Aufmerksamkeit und die Vorstellungskraft des Internets auf sich gezogen, als Intel (INTC ) -Forscher eine neue Methode zur Verbesserung der Realistik von synthetischen Bildern vorstellten.
Das System, wie es in einem Video von Intel demonstriert wird, greift direkt in die Bildpipeline des Videospiels Grand Theft Auto V ein und verbessert die Bilder durch einen Bildsynthese-Algorithmus, der auf einem konvolutionellen neuronalen Netzwerk (CNN) trainiert wurde, unter Verwendung von realen Bildern aus dem Mapillary-Dataset, und ersetzt die weniger realistische Beleuchtung und Texturierung des GTA-Spiel-Engines.
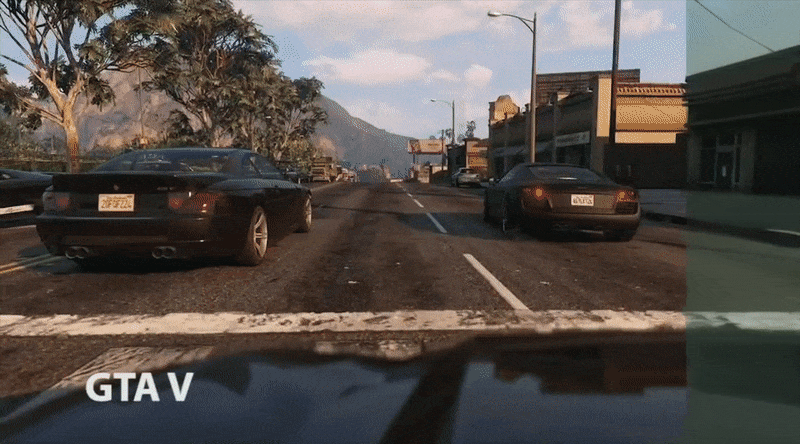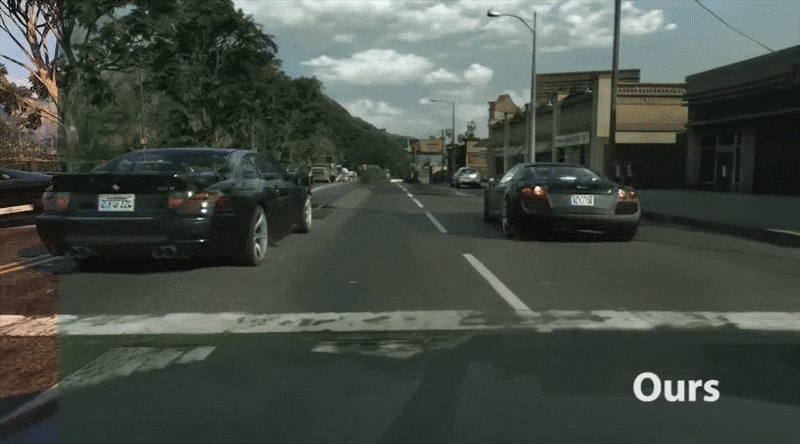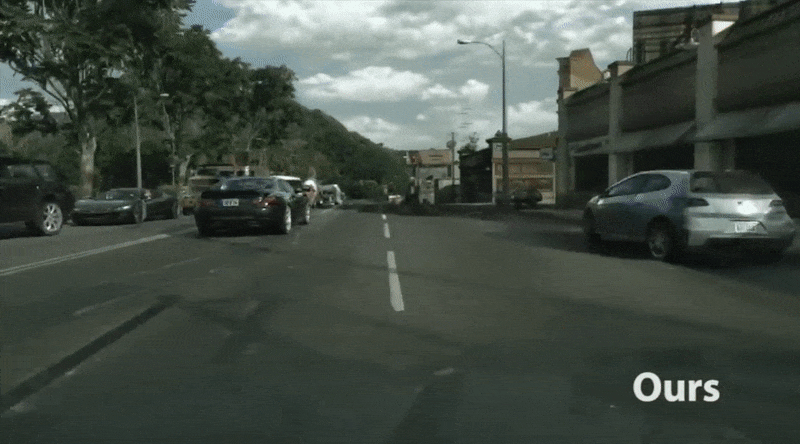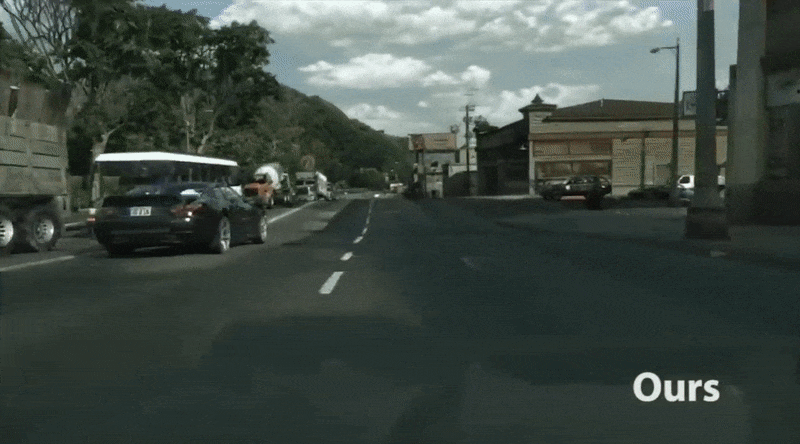
Kommentatoren in verschiedenen Communities wie Reddit und Hacker News äußern sich nicht nur darüber, dass neuronales Rendering dieser Art die weniger fotorealistischen Ausgaben traditioneller Spiel-Engines und VFX-Ebenen CGI ersetzen könnte, sondern auch, dass dieser Prozess mit viel grundlegenderer Eingabe als im Intel-GTA5-Demo demonstriert wurde, durchgeführt werden könnte – effektiv “Puppen”-Proxy-Eingaben mit extrem realistischen Ausgaben zu erstellen.
Paarierte Datensätze
Das Prinzip wurde von einer neuen Generation von GAN- und Encoder/Decoder-Systemen in den letzten drei Jahren exemplifiziert, wie z.B. NVIDIA’s GauGAN, das fotorealistische Landschaftsbilder aus groben Skizzen erzeugt.

Effektiv dreht sich dieses Prinzip die konventionelle Verwendung von semantischer Segmentierung in Computer-Vision von einer passiven Methode, die es maschinellen Systemen ermöglicht, beobachtete Objekte zu identifizieren und zu isolieren, in eine kreative Eingabe, bei der der Benutzer eine falsche semantische Segmentierungskarte “malt” und das System Bilder erzeugt, die konsistent mit den Beziehungen sind, die es aus der Klassifizierung und Segmentierung eines bestimmten Bereichs wie Landschaften versteht.

Ein maschinelles Lernframework wendet semantische Segmentierung auf verschiedene Außenszenen an, wodurch die architektonische Paradigma ermöglicht wird, interaktive Systeme zu entwickeln, bei denen der Benutzer eine semantische Segmentierungskarte “malt” und das System die Karte mit geeigneten Bildern aus einem bereichsspezifischen Dataset wie dem Mapillary-Street-View-Set, das in Intels GTA5-Neural-Rendering-Demo verwendet wird, füllt. Quelle: http://ais.informatik.uni-freiburg.de/publications/papers/valada17icra.pdf
Paarierte Datensatz-Bildsynthese-Systeme funktionieren, indem sie semantische Labels auf zwei Datensätzen korrelieren: einem reichen und vollständigen Bildsatz, der entweder aus realen Bildern (wie dem Mapillary-Set, das zur Verbesserung von GTA5 in Intels Demo verwendet wird) oder aus synthetischen Bildern wie CGI-Bildern generiert wird.

Paarierte Datensatz-Beispiele für ein Bildsynthese-System, das darauf ausgelegt ist, neuronale gerenderte Charaktere aus ungeschickten Skizzen zu erstellen. Quelle: https://www.youtube.com/watch?v=miLIwQ7yPkA
Außenumgebungen sind relativ unkompliziert, wenn man paarierte Datensatz-Transformationen dieser Art erstellt, da Vorsprünge normalerweise sehr begrenzt sind, die Topographie einen begrenzten Variationsbereich hat, der umfassend in einem Datensatz erfasst werden kann, und man nicht mit der Erstellung künstlicher Menschen oder der Bewältigung des Uncanny Valley konfrontiert ist.
Umkehrung von Segmentierungskarten
Google hat eine animierte Version des GauGAN-Schemas entwickelt, genannt Infinite Nature, die in der Lage ist, kontinuierliche und nie endende fiktive Landschaften zu “halluzinieren”, indem sie falsche semantische Karten in fotorealistische Bilder durch NVIDIA’s SPADE-Infill-System übersetzt:
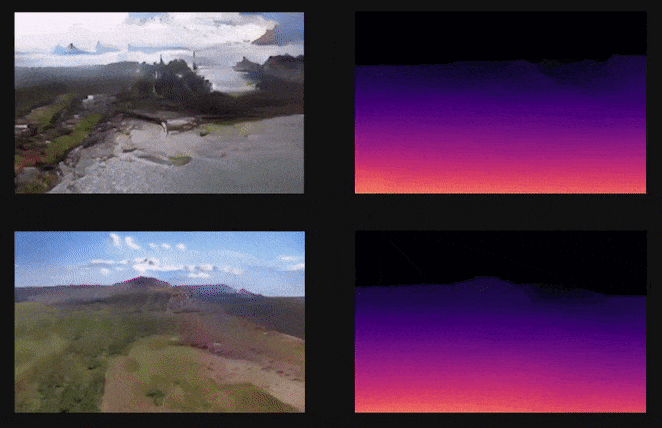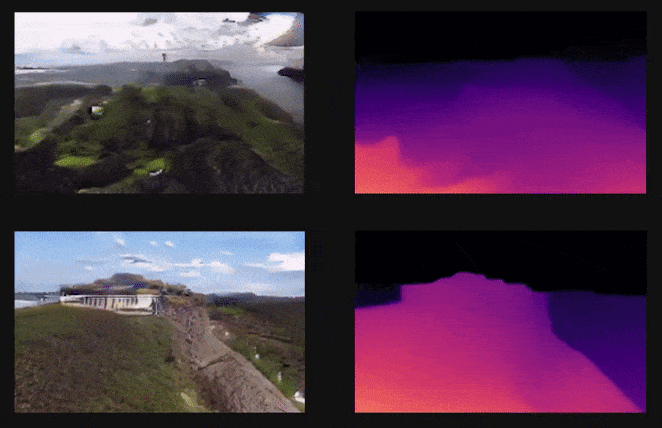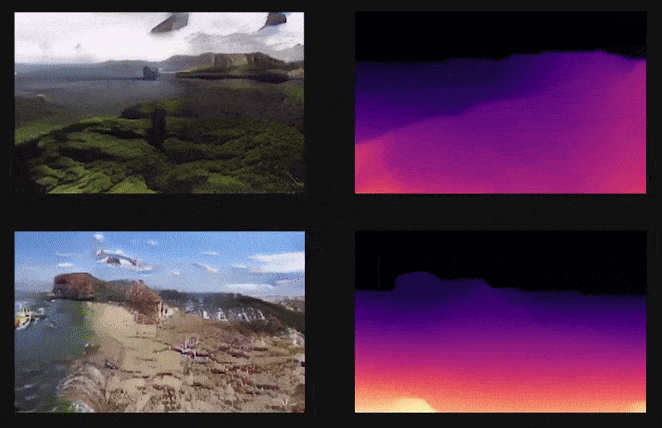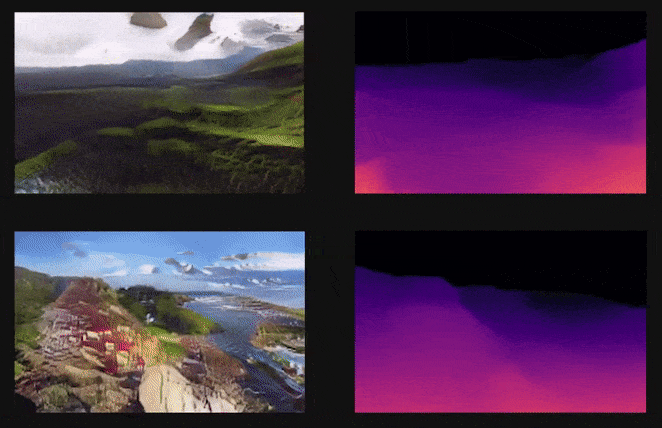
Quelle: https://www.youtube.com/watch?v=oXUf6anNAtc
Unlimited Nature verwendet jedoch ein einzelnes Bild als Ausgangspunkt und verwendet SPADE nur, um die fehlenden Abschnitte in aufeinanderfolgenden Frames zu malen, während SPADE selbst Bildtransforms direkt aus Segmentierungskarten erstellt.

Quelle: https://nvlabs.github.io/SPADE/
Es ist diese Fähigkeit, die die Bewunderer des Intel-Bildverbesserungssystems zu begeistern scheint – die Möglichkeit, sehr hochwertige fotorealistische Bilder, sogar in Echtzeit (schließlich), aus extrem grober Eingabe abzuleiten.
Ersetzen von Texturen und Beleuchtung durch neuronales Rendering
Im Fall der GTA5-Eingabe haben sich einige gefragt, ob die computeraufwändigen prozeduralen und Bitmap-Texturen und Beleuchtungen aus dem Spiel-Engine-Ausgang wirklich notwendig sind, oder ob es möglich wäre, low-resolution, wireframe-ebene Eingabe in fotorealistische Video zu transformieren, die die Schattierung-, Textur- und Beleuchtungsfähigkeiten von Spiel-Engines übertrifft, und hyperrealistische Szenen aus “Platzhalter”-Proxy-Eingabe zu erstellen.
Es mag offensichtlich erscheinen, dass spielgenerierte Aspekte wie Reflexionen, Texturen und andere Arten von Umgebungsdetails wesentliche Informationsquellen für ein neuronales Rendering-System der von Intel demonstrierten Art sind. Doch es ist bereits einige Jahre her, seit NVIDIA’s UNIT (UNsupervised Image-to-image Translation Networks) demonstrierte, dass nur der Bereich wichtig ist und dass sogar umfassende Aspekte wie “Nacht oder Tag” im Wesentlichen Fragen sind, die durch Stil-Transfer behandelt werden:
In Bezug auf die erforderliche Eingabe könnte dies das Spiel-Engine-System nur noch dazu zwingen, Basis-Geometrie und Physik-Simulationen zu generieren, da das neuronale Rendering-System alle anderen Aspekte durch die Synthese der gewünschten Bilder aus dem erfassten Datensatz, unter Verwendung von semantischen Karten als Interpretationsschicht, übermalen kann.

Intels System verbessert ein vollständig fertiggestelltes und gerendertes Bild von GTA5, indem es Segmentierung und ausgewertete Tiefenmaps hinzufügt – zwei Aspekte, die potenziell direkt von einem heruntergestuftem Spiel-Engine-System bereitgestellt werden könnten. Quelle: https://www.youtube.com/watch?v=P1IcaBn3ej0
Intels neuronales Rendering-Ansatz beinhaltet die Analyse von vollständig gerenderten Bildern aus den GTA5-Puffern, und das neuronale System hat die zusätzliche Last, sowohl die Tiefenmaps als auch die Segmentierungskarten zu erstellen. Da Tiefenmaps implizit in traditionellen 3D-Pipelines verfügbar sind (und weniger anspruchsvoll zu generieren sind als Textur, Ray-Tracing oder globale Beleuchtung), könnte es eine bessere Verwendung von Ressourcen sein, die Tiefenmaps vom Spiel-Engine-System generieren zu lassen.
Heruntergestuftes Eingabe-Format für ein neuronales Rendering-System
Die aktuelle Implementierung des Intel-Bildverbesserungsnetzwerks beinhaltet möglicherweise viele redundante Rechenzyklen, da das Spiel-Engine-System computeraufwändige Textur- und Beleuchtungseffekte erzeugt, die das neuronale Rendering-System nicht wirklich benötigt. Das System wurde offensichtlich auf diese Weise entworfen, nicht weil dies notwendigerweise ein optimaler Ansatz ist, sondern weil es einfacher ist, ein neuronales Rendering-System an eine bestehende Pipeline anzupassen, als einen neuen Spiel-Engine zu erstellen, der auf ein neuronales Rendering-System ausgerichtet ist.
Die wirtschaftlichste Verwendung von Ressourcen in einem Spiel-System dieser Art könnte die vollständige Übernahme der GPU durch das neuronale Rendering-System sein, wobei die heruntergestufte Proxy-Eingabe vom CPU gehandhabt wird.
Darüber hinaus könnte das Spiel-Engine-System leicht repräsentative Segmentierungskarten selbst erstellen, indem es alle Schattierung und Beleuchtung in seiner Ausgabe deaktiviert. Zusätzlich könnte es Video in einer viel niedrigeren Auflösung als normalerweise erforderlich liefern, da das Video nur repräsentativ für den Inhalt sein müsste, wobei die hochauflösenden Details vom neuronalen Motor gehandhabt werden, wodurch lokale Rechenressourcen weiter freigegeben werden.
Intel ISLs vorherige Arbeit mit Segmentierung > Bild
Die direkte Übersetzung von Segmentierung in fotorealistische Video ist weit von hypothetisch entfernt. Im Jahr 2017 veröffentlichte Intel ISL, der Schöpfer von gestern, erste Forschung, die in der Lage war, urbane Video-Synthese direkt aus semantischer Segmentierung durchzuführen.

Intel ISLs Arbeit zur Segmentierung in Bild aus dem Jahr 2017. Quelle: https://awesomeopensource.com/project/CQFIO/PhotographicImageSynthesis
Im Wesentlichen wurde diese ursprüngliche Pipeline von 2017 lediglich erweitert, um die vollständig gerenderte Ausgabe von GTA5 zu passen.
Neuronales Rendering in VFX
Neuronales Rendering aus künstlichen Segmentierungskarten scheint auch eine vielversprechende Technologie für VFX zu sein, mit der Möglichkeit, sehr grundlegende Videogramme direkt in fertige visuelle Effekt-Footage zu übersetzen, indem man bereichsspezifische Datensätze aus Modellen oder synthetischen (CGI-) Bildern generiert.

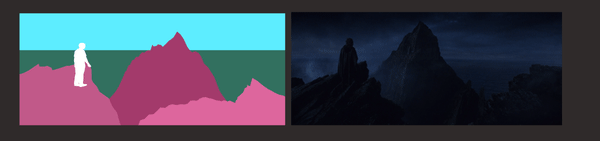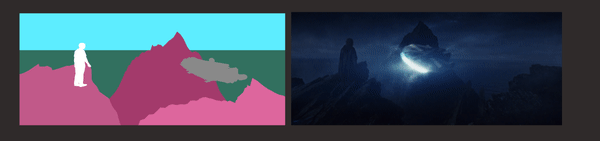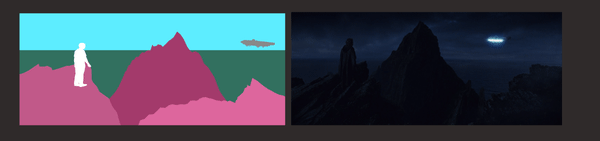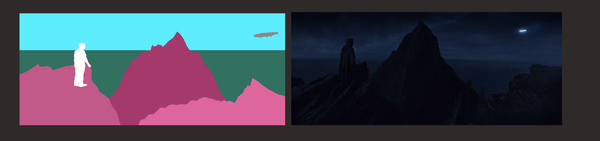
Ein hypothetisches neuronales Rendering-System, bei dem umfassende Abdeckung jedes Zielobjekts in einen Beitragendatensatz abstrahiert wird und bei dem künstlich generierte Segmentierungskarten als Grundlage für vollständig fotorealistische Ausgabe verwendet werden. Quelle: https://rossdawson.com/futurist/implications-of-ai/comprehensive-guide-ai-artificial-intelligence-visual-effects-vfx/
Die Entwicklung und der Einsatz solcher Systeme würden den Schwerpunkt der künstlerischen Anstrengung von einer interpretativen zu einer repräsentativen Arbeitsweise verlagern und die domänengetriebene Datenerfassung von einer unterstützenden zu einer zentralen Rolle in den visuellen Künsten erhöhen.
Artikel aktualisiert um 16:55 Uhr, um Material über Intel ISL-Forschung aus dem Jahr 2017 hinzuzufügen.


