
Andersons Blickwinkel
NeRF rückt einen Schritt näher an die Ersetzung von CGI heran

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen

Forscher am MIT und Google haben einen großen Schritt gemacht, um eines der grundlegendsten Hindernisse für eine aufkommende AI-getriebene Technologie zu überwinden, die möglicherweise CGI ersetzen wird – die Trennung von Neural-Radiance-Field- (NeRF-) Bildern in ihre konstituierenden visuellen Komponenten, damit die Bilder neu texturiert und neu beleuchtet werden können.
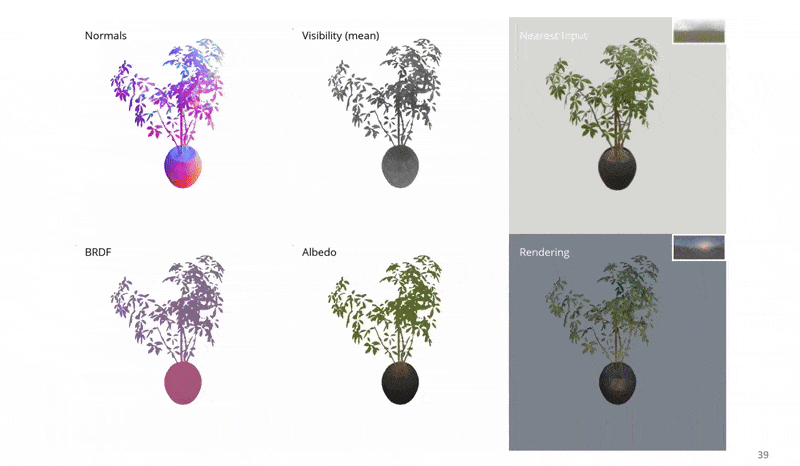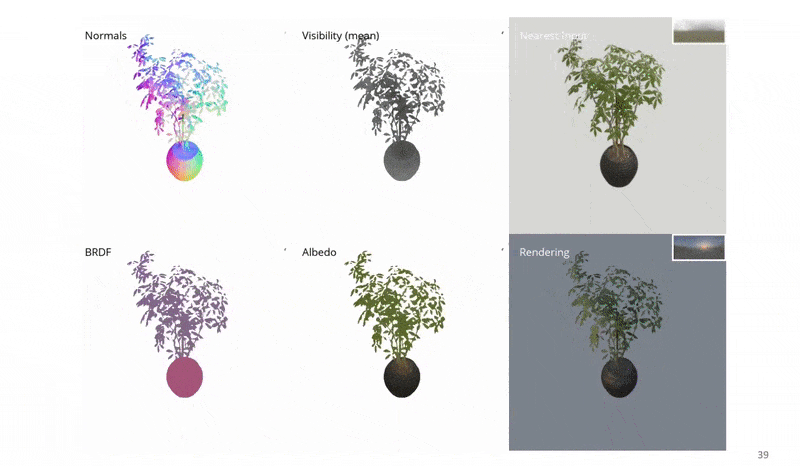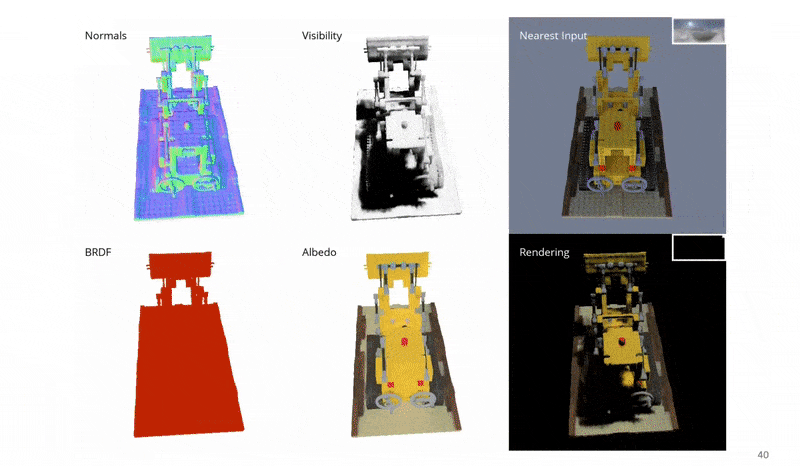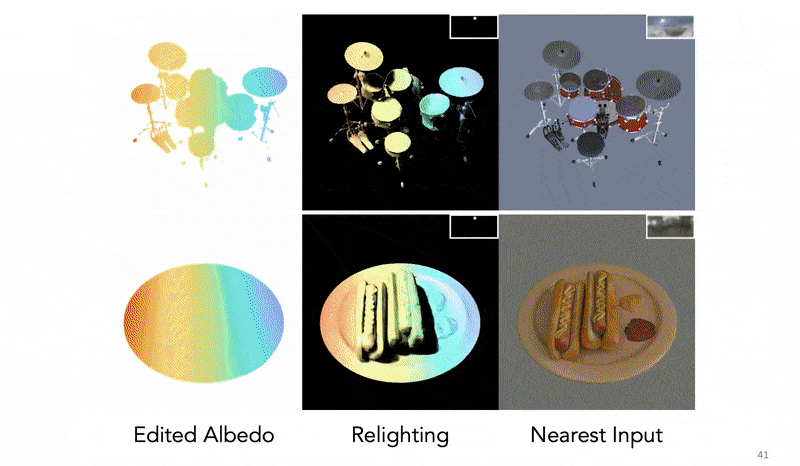
Der neue Ansatz, der als NeRFactor bezeichnet wird, teilt die aufgenommenen Bilder effektiv in pro-Objekt-Normale (auf die Texturen zugewiesen werden können), Lichtsichtbarkeit, Albedo (der Anteil des einfallenden Lichts, der von einer Oberfläche reflektiert wird) und Bidirektionale Reflexionsverteilungsfunktionen (BRDFs) auf.
Mit diesen isolierten Aspekten ist es möglich, nicht nur Texturen für einzelne Objekte oder Objektgruppen auszutauschen, sondern auch neue und einzigartige Lichtquellen und Schattenimplementierungen hinzuzufügen, ohne dass diese von den Multi-Kamera-Arrays aufgenommen werden, die als Eingabe für NeRF-Bilder dienen.
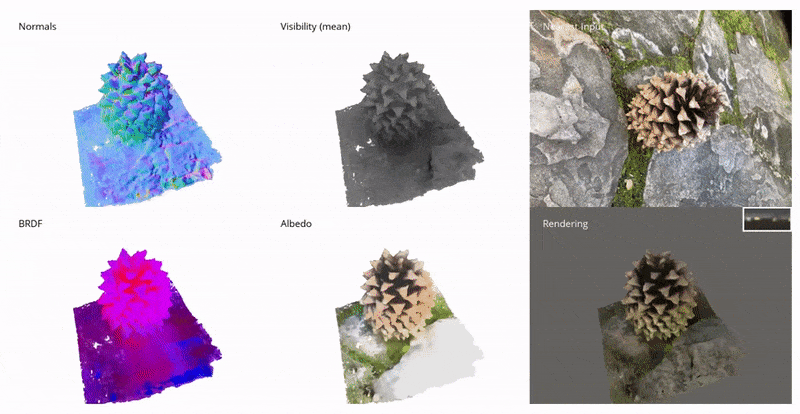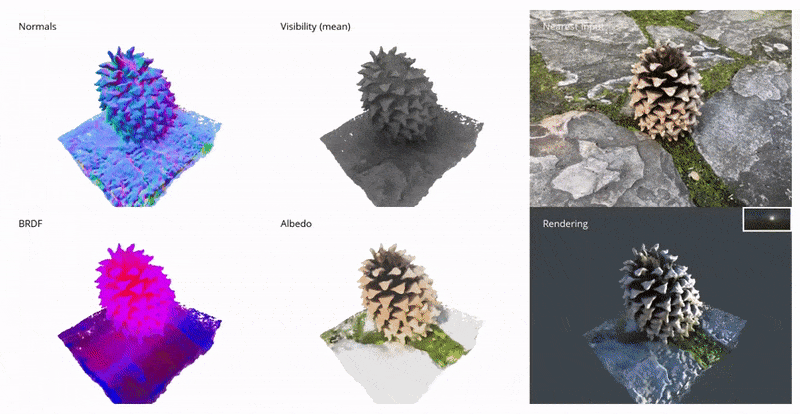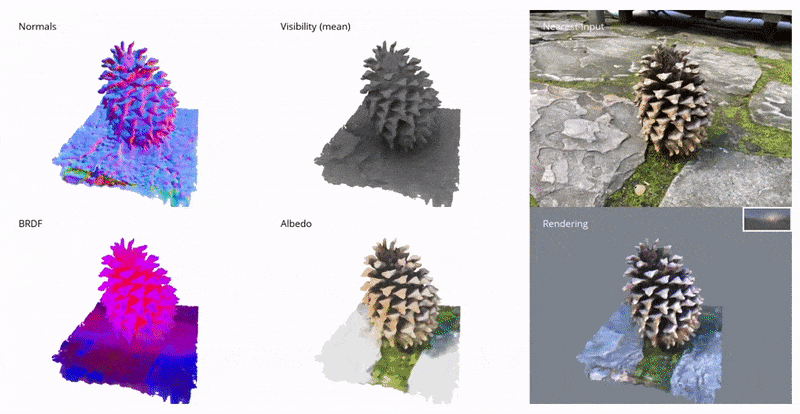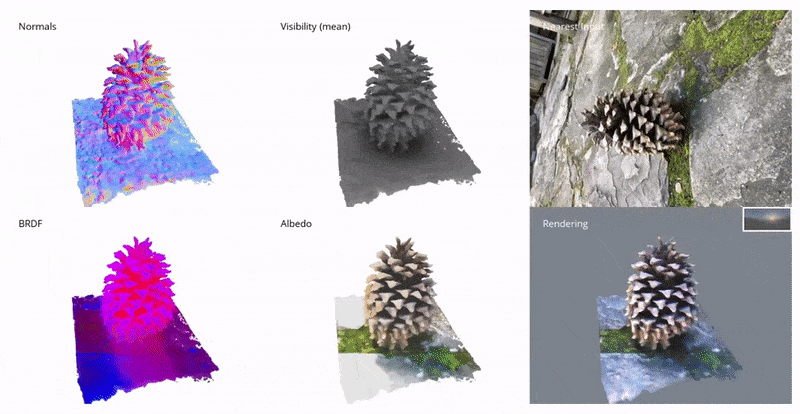
Normale, Sichtbarkeit, Albedo und BRDF unter NeRFactor. Quelle: https://www.youtube.com/watch?v=UUVSPJlwhPg
Das Modell unterstützt weiche oder harte Schatten von beliebigen, benutzerdefinierten Lichtquellen und trennt die vier Aspekte der aufgenommenen Video programmatisch, unter Verwendung einer Rekonstruktionsverlustfunktion, Daten aus vorherigen BRDF-Berechnungen und einfacher, glatter Regulierung.


NeRFactors Arbeitsablauf, der separate, handhabbare Aspekte von Bildern extrahiert, die aus Multi-Kamera-Arrays stammen. Quelle: https://arxiv.org/pdf/2106.01970.pdf
NeRFactor verwendet eine HDR-Lichtsonde, einen etablierten Ansatz, der seit seiner Einführung im Jahr 1998 die visuelle Industrie und die Kunstszene durchdrungen hat, um mögliche Wege für Strahlen zu bewerten, was willkürliche Beleuchtung ermöglicht. Da dies eine unüberschaubare Anzahl von Parametern erzeugt, wird die Lichtsonde durch ein Multi-Layer-Perzeptron (MLP) gefiltert, das die wahrgenommene Geometrie auf die Sonde abbildet, ohne zu versuchen, eine vollständige Beleuchtungsvolumenkarte für den Modellraum zu berechnen.

Zwei neuronale Radiance-Field-Modelle werden verwendet, um fünf Beleuchtungsmodelle unter NeRFactor zu demonstrieren. Klicken Sie auf das Bild für eine höhere Auflösung.
Anlass zur Reflexion
Die neue Forschung ist vielleicht am bedeutsamsten, da sie die Schichten der aufgenommenen Bilder trennt, die die Reflexion kontrollieren. Dies bleibt eine der größten Herausforderungen für neuronale Radiance-Field-Bilder, da ein wirklich neues und flexibles NeRF-System nicht nur in der Lage sein muss, Texturen auszutauschen, sondern auch eine Möglichkeit haben muss, sich bewegende Objekte (außer der allgemeinen festen Umgebung) zu reflektieren, die normalerweise in einem CGI-Workflow berücksichtigt würden.
Dieses Problem wurde kürzlich im Zusammenhang mit Intels beeindruckender neuer Forschung zur Umwandlung von Videospiel-Footage in photorealistische Videos über konvolutionale neuronale Netze festgestellt. In solchen Workflows müssten viele “gebackene” Aspekte des Quellmaterials diskret und austauschbar werden, und dies ist möglicherweise einfacher zu lösen für die Beleuchtung (die eine Funktion der in NeRF gerenderten Geometrie ist) als für Reflexionen (die “außerhalb des Bildschirms” liegende Geometrie verwenden, die völlig außerhalb des Modells liegt).
Daher bringt die Isolierung der Schichten in NeRF-Videos, die die Reflexion ermöglichen, NeRF einen Schritt näher an die Lösung seiner “Reflexionsherausforderung”.
Die Verwendung einer HDR-Umgebung löst bereits das Problem der Erzeugung von Umgebungsreflexionen (z. B. Himmel, Landschaften und andere “feste” Umgebungsfaktoren), aber neue Ansätze werden benötigt, um bewegliche und dynamische Reflexionen einzuführen.
Photogrammetrie mit NeRF
Neuronale Radiance-Field-Bilder verwenden maschinelles Lernen, um einen vollständig volumetrischen Raum aus einer Szene oder einem Objekt zu entwickeln, das aus mehreren Winkeln aufgenommen wurde.

Die verschiedenen NeRF-basierten Schemata, die im letzten Jahr aufgetaucht sind, haben eine Vielzahl von Kameras verwendet; einige verwenden 16 oder mehr Kameras, andere nur eine oder zwei. In allen Fällen werden die Zwischenansichten “aufgefüllt” (d. h. interpretiert), so dass die Szene oder das Objekt flüssig navigiert werden kann.
Das resultierende Objekt ist ein vollständig volumetrischer Raum mit einem inhärenten 3D-Verständnis, das auf viele Weise ausgenutzt werden kann, einschließlich der Fähigkeit, traditionelle CG-Netze aus der 3D-Parse-Summe der Eingabebilder zu erzeugen.
NeRF im Kontext eines “neuen CGI”
Neuronale Radiance-Field-Bilder werden direkt aus Bildern der realen Welt gezogen, einschließlich bewegter Bilder von Menschen, Objekten und Szenen. Im Gegensatz dazu erfordert eine CGI-Methode, dass die Welt “studiert” und interpretiert wird, was geschickte Arbeiter erfordert, um Netze, Rigs und Texturen zu erstellen, die reale Weltbilder verwenden (d. h. Gesichts- und Umgebungsaufnahmen). Es bleibt ein im Wesentlichen interpretativer und handwerklicher Ansatz, der teuer und arbeitsintensiv ist.
Darüber hinaus hat CGI immer wieder Probleme mit dem “uncanny valley”-Effekt bei der Nachbildung von menschlichen Ähnlichkeiten, was für einen NeRF-ansatz, der einfach Video- oder Bilder von realen Menschen aufnimmt und manipuliert, kein Problem darstellt.
Weiterhin kann NeRF traditionelle CGI-ähnliche Mesh-Geometrie direkt aus Fotos erzeugen, wenn erforderlich, und ersetzt damit viele der manuellen Verfahren, die immer notwendig waren, um computer-generierte Bilder zu erstellen.
Herausforderungen für NeRF
Diese neueste Forschung von MIT und Google kommt im Kontext einer Flut von NeRF-Papieren im letzten Jahr, viele davon haben Lösungen für die verschiedenen Herausforderungen angeboten, die durch das ursprüngliche Papier von 2020 aufgeworfen wurden.
Im April bot eine Innovation von einem chinesischen Forschungskonsortium eine Möglichkeit, diskret die individuellen Zeitleisten von Aspekten in einer NeRF-Szene zu isolieren, einschließlich Menschen.
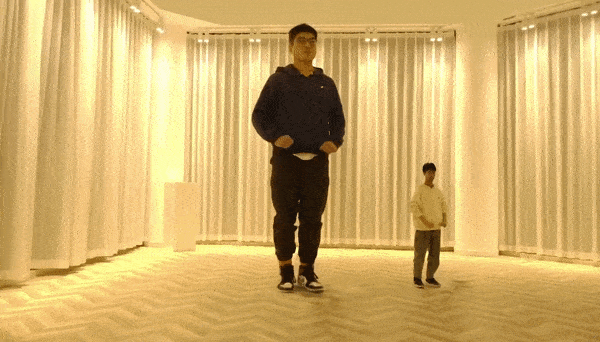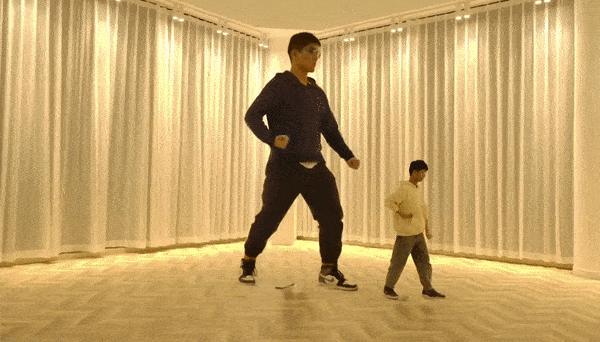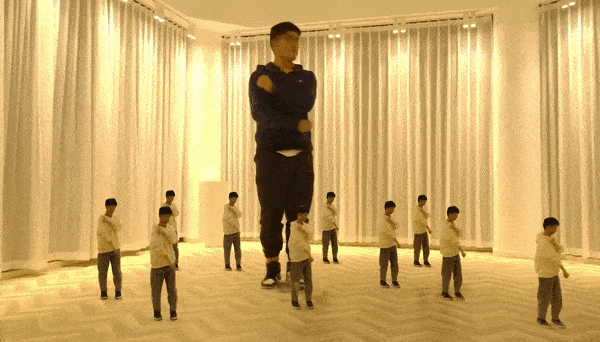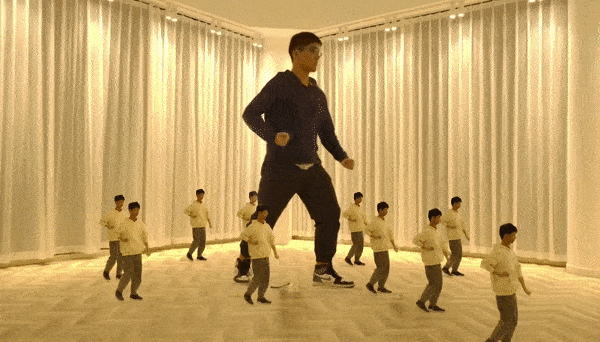
Das chinesische Forschungskonsortium ermöglicht es Benutzern, aufgenommene Elemente zu kopieren, zu bearbeiten und zu vergrößern, sie von der linearen Zeitleiste des ursprünglichen Quellvideos zu lösen. Quelle: https://www.youtube.com/watch?v=Wp4HfOwFGP4
Dieser Ansatz ermöglicht es nicht nur, die Szene aus jedem Winkel zu imaginieren, der von der Kamera-Array aufgenommen wurde (und nicht nur aus der einzelnen Ansicht, die in einer typischen Videoaufnahme dargestellt wird), sondern auch eine vielseitige Komposition – und sogar die Fähigkeit, zwei Aspekte aus dem gleichen Footage darzustellen, die in ihren eigenen individuellen Zeitleisten laufen (oder sogar rückwärts, wenn erforderlich).
Das chinesische Forschungskonsortium ermöglicht es Benutzern, aufgenommene Elemente zu kopieren, zu bearbeiten und zu vergrößern, sie von der linearen Zeitleiste des ursprünglichen Quellvideos zu lösen. Quelle: https://www.youtube.com/watch?v=Wp4HfOwFGP4
Eine der größten Herausforderungen für NeRF ist die Verringerung der erheblichen Ressourcen, die für die Ausbildung einer Szene benötigt werden, und dies wurde in einer Reihe von aktuellen Papieren angegangen. Zum Beispiel führte das Max-Planck-Institut für Intelligente Systeme kürzlich KiloNeRF ein, das nicht nur die Renderzeiten um einen Faktor von 1000 beschleunigt, sondern auch ermöglicht, NeRF interaktiv zu verwenden.
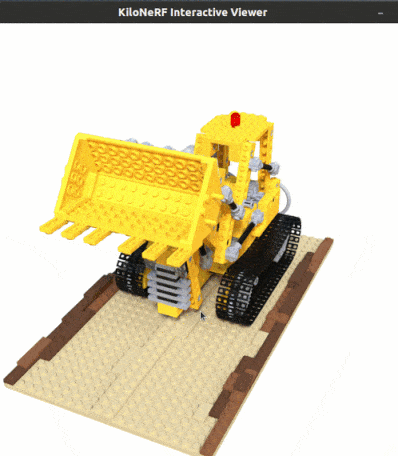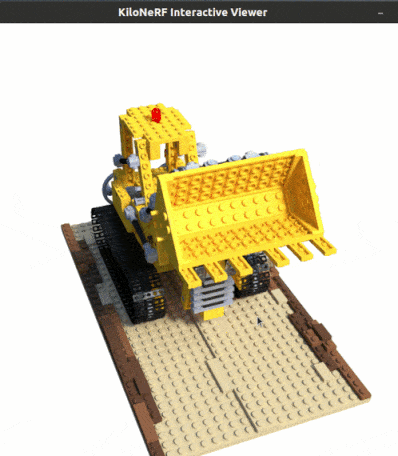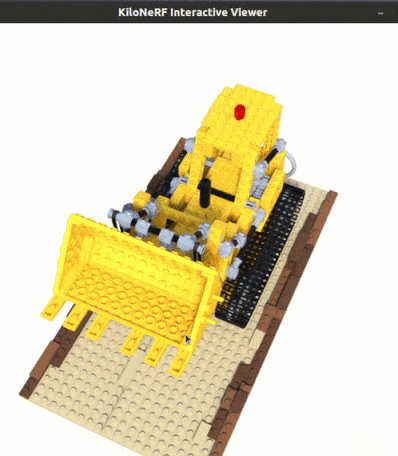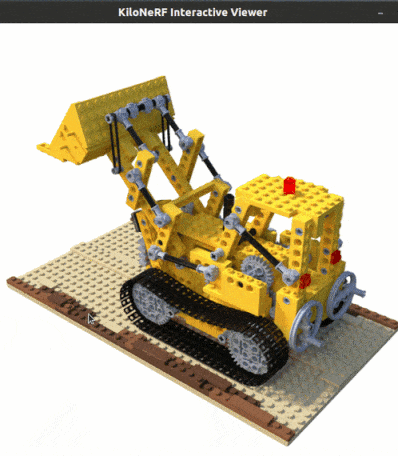
KiloNeRF läuft in einer interaktiven Umgebung mit 50 fps auf einem GTX 1080ti. Quelle: https://github.com/creiser/kilonerf
Ein anderer Ansatz ist PlenOctrees, eine Zusammenarbeit unter der Leitung der UC Berkeley, die Echtzeit-Rendering von neuronalen Radiance-Feldern anbietet:
Die Wirkung der interaktiven Fähigkeiten von PlenOctrees wurde in einer Live-Web-Oberfläche reproduziert.
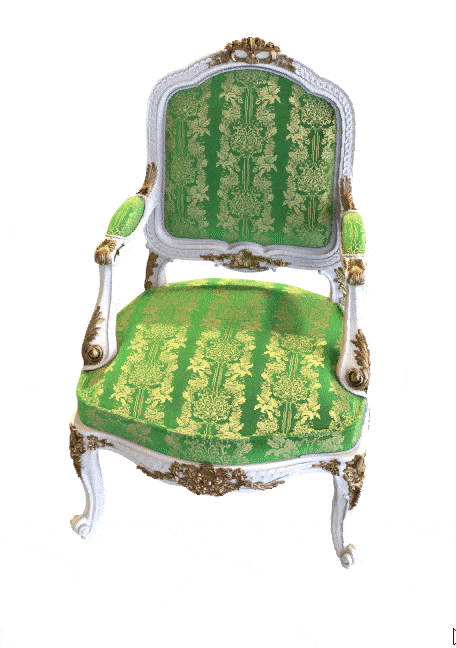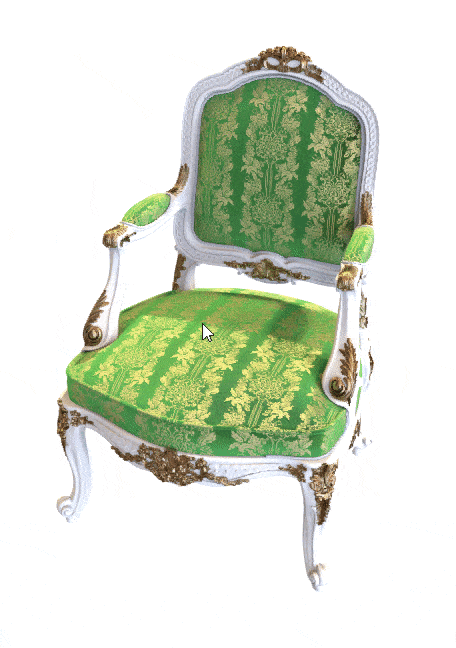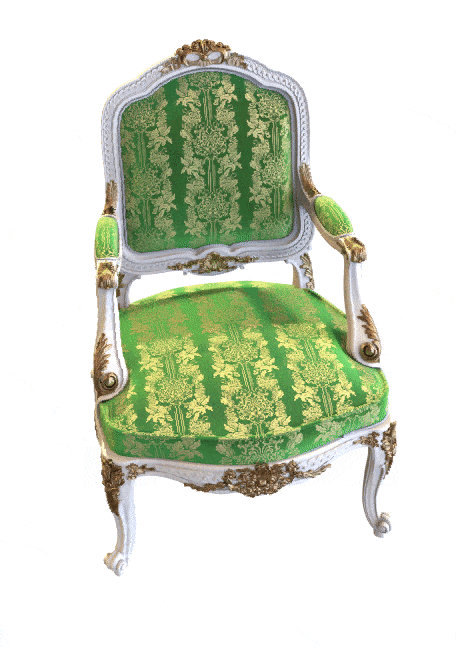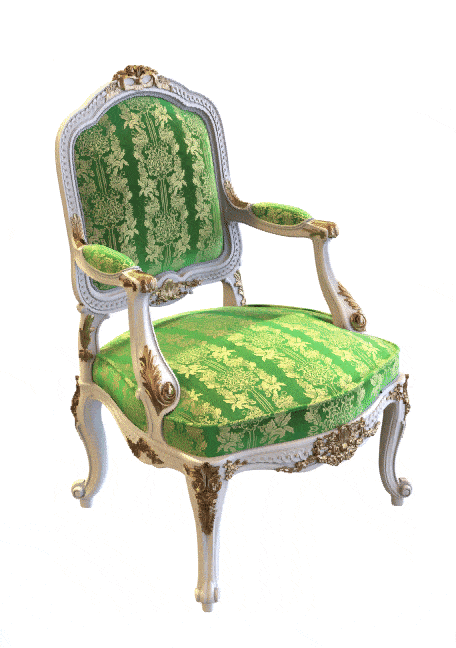
Live-Interaktion eines PlenOctrees-Objekts in Firefox (die Bewegung ist glatter und dynamischer als in diesem GIF dargestellt). Quelle: http://alexyu.net/plenoctrees/demo/
Darüber hinaus bietet Recursive-NeRF (aus einem Papier von Mai 2021 von Forschern an der Tsinghua-Universität) hochwertiges rekursives Rendering auf Abruf. Anstatt den Benutzer zu zwingen, ganze Szenen zu rendern, einschließlich Teilen, die möglicherweise nicht sichtbar sind, bietet Recursive-NeRF etwas Ähnliches wie die verlustbehaftete Kompression von JPEG und kann diskrete Sub-NeRFs erzeugen, um zusätzliche Bilder auf Abruf zu bearbeiten – was zu einer enormen Einsparung von Rechenressourcen führt.

Beibehaltung von Details bei der Entsorgung unnötiger Renderberechnungen mit Recursive-NeRF. Klicken Sie auf das Bild für eine höhere Auflösung. Quelle: https://arxiv.org/pdf/2105.09103.pdf
Andere Ansätze umfassen FastNeRF, das hochwertiges neuronales Rendering mit 200 fps beansprucht.
Es wurde festgestellt, dass viele der Optimierungstechniken für NeRF das “Backen” der Szene beinhalten, indem man sich auf die Aspekte verpflichtet, die gerendert werden sollen, und andere Aspekte verwerfen, was die Exploration einschränkt, aber die Interaktivität stark beschleunigt.
Der Nachteil davon ist, dass der Druck von der GPU auf die Speicherung verlagert wird, da “gebackene” Szenen einen enormen Speicherplatz beanspruchen; dies kann bis zu einem gewissen Grad durch Downsampling der “gebackenen” Daten gemildert werden, was jedoch auch eine bestimmte Verpflichtung beinhaltet, in Bezug auf die Schließung von Explorations- oder Interaktionsmöglichkeiten.
In Bezug auf Motion Capture und Rigging bot ein neuer Ansatz von den Universitäten Zheijang und Cornell, der im Mai veröffentlicht wurde, eine Methode, um animierbare Menschen mit Blendgewichtsfeldern und Skelettstrukturen zu rekonstruieren, die aus Eingabevideos interpretiert wurden:
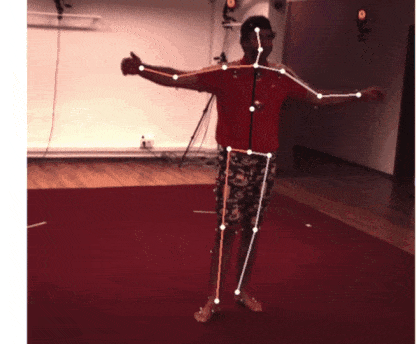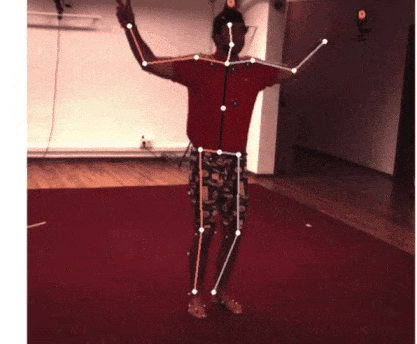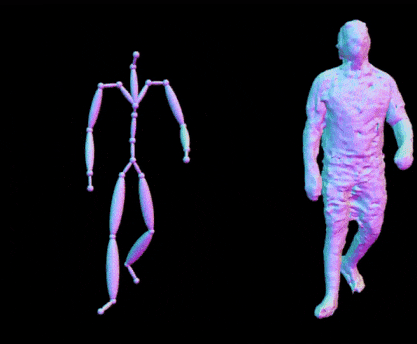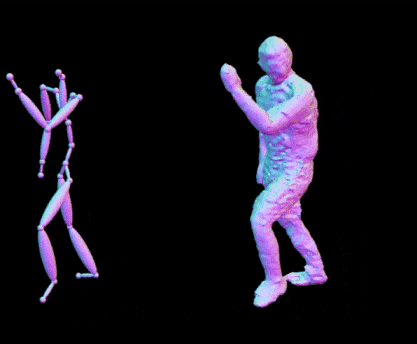
Abgeleitete Skelettstruktur in Animatable NeRF. Quelle: https://www.youtube.com/watch?v=eWOSWbmfJo4

Wann wird NeRF sein “Jurassic Park”-Moment haben?
Trotz des schnellen Fortschritts bei der Bildsynthese über neuronale Radiance-Felder wird es erst in dieser Periode eine Art “Gesetz der Thermodynamik” für die Einsatzfähigkeit von NeRF geben. In Bezug auf eine Zeitleiste, die der Geschichte von CGI ähnelt, schwebt NeRF derzeit um 1973, kurz vor der ersten Verwendung von CGI in Westworld.
Dies bedeutet nicht, dass NeRF notwendigerweise neun Jahre auf seine äquivalente Wrath Of Khan-Meilenstein warten muss oder Jahrzehnte für die ähnlichen Durchbrüche, die CGI unter der enthusiastischen Förderung von James Cameron in The Abyss von 1989 oder Terminator 2 von 1991 erreicht hat – und dann, die technologische Durchbruch in Jurassic Park von 1993.

Die Bildszene hat sich seit der langen Periode der Stagnation für photochemische visuelle Effekte, die die Film- und Fernsehproduktion von der Geburt des Kinos bis in die frühen 1990er Jahre dominierten, stark verändert. Der Beginn der PC-Revolution und die Beschleunigung von Moores Gesetz führten zur CGI-Revolution, die möglicherweise bereits in den 1960er Jahren hätte stattfinden können.
Es bleibt abzuwarten, ob es ein so unüberwindbares Hindernis gibt, das NeRFs Fortschritt so lange aufhalten könnte – und ob sich möglicherweise Innovationen in der Computer-Vision nicht inzwischen als der Schlüsselkontender für CGI’s Krone erweisen und neuronale Radiance-Felder als das “Faxgerät” der neuronalen Bildsynthese charakterisieren.
Bisher wurde NeRF nicht in einem anderen Kontext als der akademischen Forschung verwendet; jedoch ist es bemerkenswert, dass große Spieler wie Google Research und viele der prominentesten Computer-Vision-Forschungslabore um die neuesten NeRF-Durchbrüche konkurrieren.
Viele von NeRFs größten Hindernissen haben begonnen, direkt in diesem Jahr angegangen zu werden; wenn sich die Forschung als Lösung für das “Reflexionsproblem” anbietet und die vielen Stränge der NeRF-Optimierungs-Forschung zu einer entscheidenden Lösung für die erheblichen Verarbeitungs- und/oder Speicheranforderungen der Technologie zusammenlaufen, hat NeRF wirklich eine Chance, in den nächsten fünf Jahren zum “neuen CGI” zu werden.


