KI-Modelle und Plattformen
Was ist das Mooresche Gesetz und wie beeinflusst es KI?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Das Mooresche Gesetz ist die historische Beobachtung, dass wirtschaftlich nutzbare integrierte Schaltkreise ihre Bauteilzahl exponentiell steigerten. Es ist kein physikalisches Gesetz und besagt nicht, dass Computer automatisch alle zwei Jahre doppelt so schnell werden.
Für KI ist die Transistordichte wichtig, weil sie mehr Recheneinheiten, Speicher und Verbindungen ermöglicht. Der praktische Fortschritt hängt jedoch auch von Architektur, numerischer Präzision, Verpackung, Speicherbandbreite, Algorithmen, Software, Energie, Fertigungs‑ausbeute und der Menge nützlicher Daten ab.
Wesentliche Erkenntnisse
- Moores ursprünglicher Artikel von 1965 beschrieb einen wirtschaftlichen und ingenieurtechnischen Trend, keine physikalische Garantie.
- Die Skalierung der Taktfrequenz verlangsamte sich; heutige Fortschritte resultieren zunehmend aus Parallelität und spezialisierten Beschleunigern.
- Die KI‑Leistung wird oft eher durch Speicherbewegungen und Energieverbrauch begrenzt als durch reine Rechenleistung.
- Vergleichen Sie Systeme anhand von Latenz, Durchsatz, Qualität, Energieverbrauch und Gesamtkosten auf Workload‑Ebene – nicht anhand der Transistorzahl.
Was Moore tatsächlich beobachtete
Gordon Moore stellte die Anzahl der Bauteile in führenden integrierten Schaltkreisen dar und prognostizierte ein weiterhin rasches Wachstum bei minimalen Kosten pro Bauteil. Der Rhythmus wurde später häufig als etwa eine Verdopplung alle zwei Jahre zusammengefasst, wobei Formulierungen und gemessene Größen variieren.
Kleinere Strukturen können die Dichte erhöhen und einige Schaltkosten senken, doch Fertigungskomplexität und Wirtschaftlichkeit entscheiden, ob der Trend weiterhin nützlich ist. Knotennamen sind Marketing‑Bezeichnungen und sollten nicht als direkter physikalischer Vergleich zwischen Foundries verwendet werden.
Von schnelleren Kernen zu heterogenem Computing
Die Dennard‑artige Spannungsskalierung ermöglichte einst höhere Taktfrequenzen ohne proportionalen Anstieg des Stromverbrauchs, doch diese Beziehung schwächte sich ab. Designer wandten sich vermehrt zu Mehrkern‑CPUs, GPUs, Tensor‑Einheiten, Chiplets, fortschrittlichen Verpackungen und domänenspezifischen Beschleunigern.
Diese Heterogenität ist zentral für Deep Learning. Dichte Matrixoperationen können effizient auf paralleler Hardware ausgeführt werden, während CPUs unregelmäßige Logik und Datenbewegungen koordinieren. Die schnellste Komponente hilft wenig, wenn die Pipeline sie nicht versorgen kann.
Speicher, Präzision und Algorithmen
Training und Inferenz bewegen wiederholt Gewichte, Aktivierungen und Cache‑Daten durch eine Hierarchie von On‑Chip‑ und Off‑Chip‑Speichern. Bandbreite, Kapazität, Lokalität und Kommunikation können die Kosten dominieren. Niedrigere numerische Präzision und Quantisierung reduzieren die Datenbewegung, solange die Qualität akzeptabel bleibt.
Algorithmische Verbesserungen können den für ein Zielresultat benötigten Rechenaufwand senken. Sparse Modelle, Transformer-Effizienz‑Methoden, bessere Optimierer und hochwertigere Daten beeinflussen alle den wahrgenommenen Fortschritt der Nutzer.
Wie man KI‑Hardware vergleicht
Peak‑Operationen pro Sekunde sind theoretisch. Verwenden Sie ein repräsentatives Modell, Batch‑Größe, Sequenzlänge, Präzision, Software‑Stack und Qualitäts‑Schwelle. Geben Sie End‑zu‑End‑Latenz, Durchsatz, Energieverbrauch, Speicherbedarf, Auslastung und Kosten an.
Edge‑Systeme können Datenschutz und geringen Stromverbrauch höher gewichten als maximalen Durchsatz; Rechenzentren können die Gesamtzahl an Tokens oder Samples pro Watt priorisieren. Edge‑KI verdeutlicht, warum eine einzelne Kennzahl nicht jedes nützliche System beschreiben kann.
Warum die Skalierung von Halbleitern sich veränderte
Der frühe Fortschritt bei integrierten Schaltkreisen kombinierte kleinere Bauelemente, bessere Fertigung, geringere Kosten pro Bauteil und Designverbesserungen. Jahrelang unterstützten reduzierte Transistordimensionen schnellere Schaltvorgänge und geringeren Energieverbrauch pro Operation. Schließlich schwächten Leckströme, Spannungsgrenzen, Wärmedichte, Interconnect‑Verzögerungen und Fertigungskosten die einfache Beziehung zwischen einem neuen Prozess‑Node und schnelleren allgemein‑zweckmäßigen Kernen.
Der heutige Fortschritt ist daher multidimensional. FinFET‑ und Gate‑All‑Around‑Technologien verbessern die elektrostatische Kontrolle; extreme‑ultraviolette Lithografie ermöglicht kleinere Strukturen; Chiplets erlauben Designern, Dies aus unterschiedlichen Prozessen zu kombinieren; fortschrittliche Verpackungen bringen Rechen‑ und Speichereinheiten näher zusammen. Ausbeute und Verpackung bestimmen, ob ein technisch beeindruckendes Design in der Serienproduktion wirtschaftlich ist.
Das Verlangsamen eines Skalierungsmechanismus bedeutet nicht, dass die Hardware aufgehört hat, sich zu verbessern. Es bedeutet, dass Architekten Transistoren gezielter einsetzen müssen. Spezial‑einheiten tauschen Flexibilität gegen Durchsatz oder Effizienz bei ausgewählten Workloads, während größere Caches und Interconnects versuchen, diese Einheiten zu versorgen.
Wie KI‑Workloads Hardware belasten
Das Training wechselt zwischen Vorwärtsberechnung, Backpropagation, Optimierer‑Updates und Kommunikation über Beschleuniger. Die Inferenz reicht von Batch‑Scoring bis zur interaktiven Token‑Generierung. Matrixmultiplikation ist wichtig, doch Einbettungen, Normalisierung, Aktivierungsfunktionen, Attention, Routing, Cache‑Zugriff und Host‑Orchestrierung tragen ebenfalls zur tatsächlichen Leistung bei.
Die arithmetische Intensität – die Menge an Berechnungen pro bewegtem Byte – erklärt, ob ein Workload rechen‑ oder bandbreitengebunden ist. Kleine Batch‑Größen und autoregressive Decodierung lassen Recheneinheiten oft ungenutzt, weil Gewichte oder Cache‑Daten wiederholt abgerufen werden müssen. Größere Batches erhöhen die Auslastung, steigern jedoch Latenz und Speicherbedarf.
Das Zahlenformat ändert den Kompromiss. FP32, BF16, FP16, FP8 und Ganzzahl‑Formate unterscheiden sich in Wertebereich, Präzision, Hardware‑Unterstützung und Fehler. Mixed‑Precision‑Training bewahrt empfindliche Operationen in höherer Präzision; quantisierte Inferenz erfordert Kalibrierung und Qualitätstests, anstatt die Annahme, dass jedes Modell dieselbe Bit‑Breite toleriert.
Systemökonomie und zukünftige Entwicklungen
Die Gesamtkosten von KI umfassen den Kauf oder das Mieten von Beschleunigern, Stromversorgung, Kühlung, Netzwerk, Speicher, Software‑Engineering, Leerlaufkapazität und gescheiterte Experimente. Ein schnellerer Chip kann insgesamt teurer sein, wenn die Auslastung gering ist oder das Modell eine teure verteilte Topologie erfordert. Messen Sie den nützlichen Output bei einer definierten Qualitäts‑Schwelle.
Skalierung wird zudem durch Daten und Algorithmen begrenzt. Mehr Rechenleistung kann falsch gekennzeichnete Daten oder eine Bewertung, die Abkürzungen belohnt, nicht reparieren. Effiziente Attention, bessere Optimierer, Sparsität, Retrieval, Distillation und algorithmische Entdeckungen können Ergebnisse verbessern, ohne proportional mehr Hardware zu benötigen, wobei Kosten jedoch anderweitig verschoben werden können.
Zukünftige Systeme werden Prozess‑Fortschritte mit dreidimensionalem Stacking, High‑Bandwidth‑Memory, optischen oder fortschrittlichen elektrischen Interconnects, domänenspezifischem Dataflow und ko‑designt‑Software kombinieren. Das Mooresche Gesetz bleibt ein wertvoller historischer Kontext, jedoch sollte die Planung gemessene Workload‑Kurven und realistische Versorgungs‑, Energie‑ und Einsatz‑Beschränkungen berücksichtigen.
Mooresches Gesetz in einem KI‑Systemdesign korrekt interpretieren
Eine sinnvolle Analyse trennt Transistordichte, CPU‑Leistung für allgemeine Zwecke, Beschleuniger‑Durchsatz, Speicherkapazität, Speicherbandbreite, Interconnect, Energie, Fertigungs‑Ausbeute und Kosten. Diese verbessern sich nicht alle gleich schnell. Ein KI‑Workload, der hauptsächlich das Verschieben von Modellgewichten erfordert, profitiert wenig von mehr Recheneinheiten, während ein kleines On‑Chip‑Modell erheblich von spezialisierten Low‑Precision‑Hardware profitieren kann. Nennen Sie die exakte Kennzahl, Präzision, Workload und Leistungs‑Envelope, anstatt einen Prozess‑Node als Leistungsmaß zu behandeln.
Das Skalieren eines KI‑Modells verändert zudem die Software‑ und Systemanforderungen. Größere Trainingsläufe benötigen parallele Algorithmen, zuverlässiges Checkpointing, Hochgeschwindigkeits‑Netzwerke, Speicher‑Pipelines und ausreichend Daten, um die zusätzliche Kapazität zu nutzen. Bei der Inferenz hängt die Latenz von der Prompt‑Länge, den generierten Tokens, dem Batching, dem Cache‑Speicher und den Service‑Level‑Zielen ab. Algorithmische Verbesserungen, Sparsität, Quantisierung, Retrieval und bessere Daten können Gewinne erzielen, die unabhängig von Transistor‑Trends sind und manchmal eine Hardware‑Generation übertreffen.
Für die Planung sollten repräsentative Modelle auf Kandidaten‑Systemen benchmarked und die Gesamtkosten über die Lebensdauer des Einsatzes modelliert werden: Anschaffungs‑ oder Cloud‑Preis, Energie, Kühlung, Auslastung, Engineering, Migration und Versorgungs‑Risiko. Verwenden Sie Szenarien statt einer einzigen exponentiellen Prognose. Das Mooresche Gesetz bleibt eine wertvolle historische Beobachtung zur Integration‑Wirtschaftlichkeit, garantiert jedoch nicht, dass KI proportional schneller, günstiger, leistungsfähiger oder nachhaltiger nach einem festen Zeitplan wird.
Praktische Implementierungs‑Checkliste
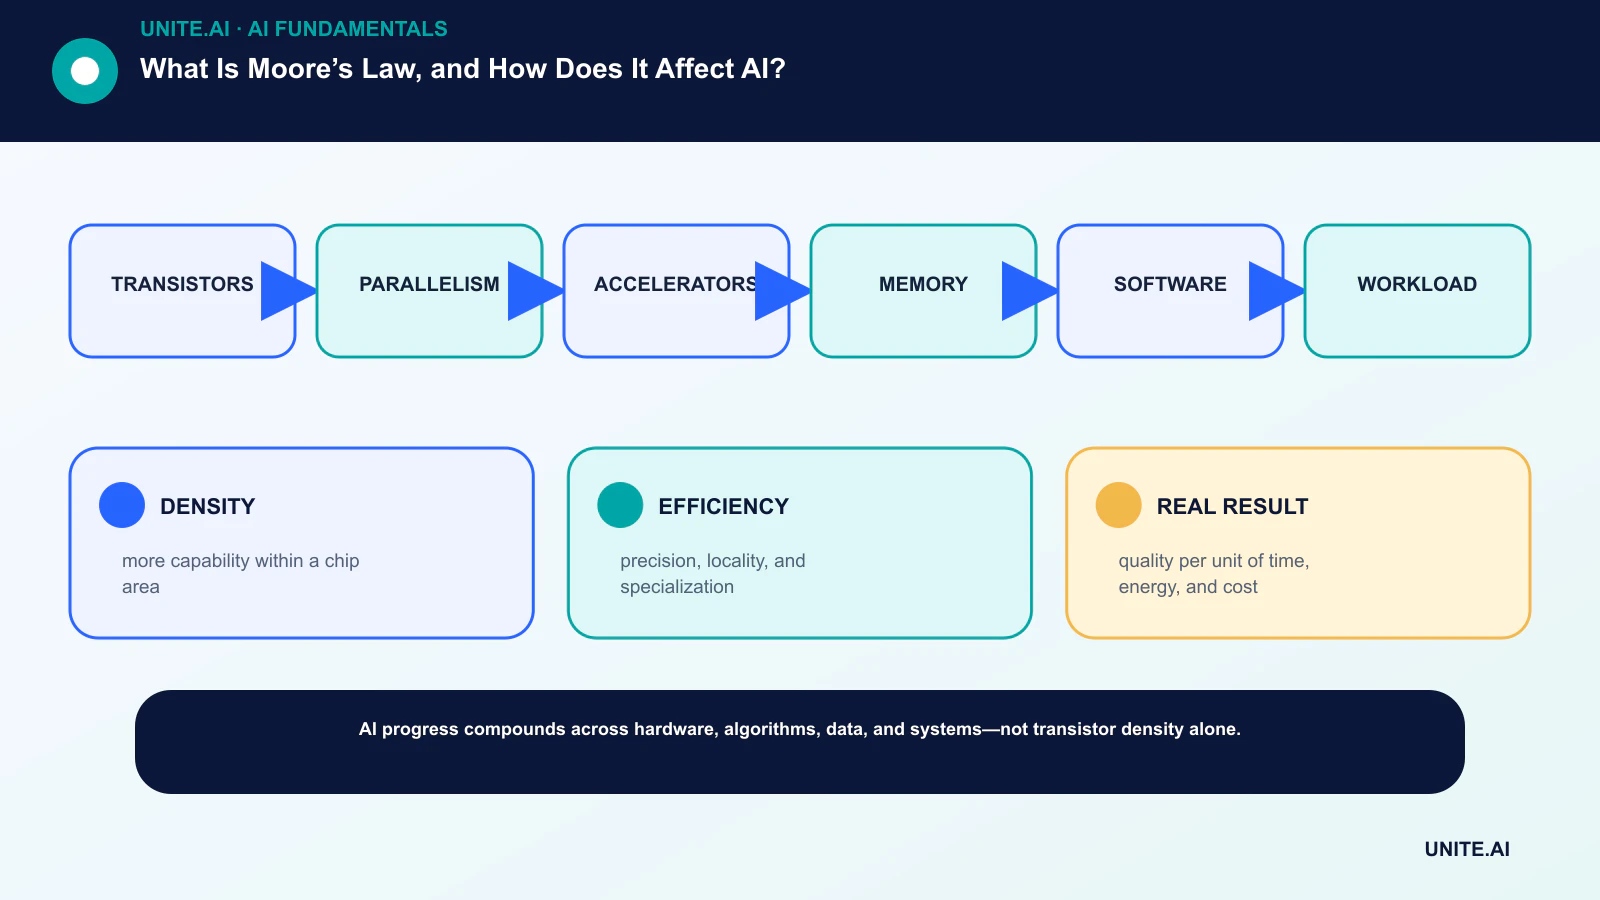
Verwandeln Sie das Konzept in einen abgegrenzten, testbaren Workflow: Transistoren → Parallelität → Beschleuniger → Speicher → Software → Workload. Benennen Sie einen verantwortlichen Eigentümer, dokumentieren Sie Daten und Abhängigkeiten, etablieren Sie eine einfache Basislinie, setzen Sie Akzeptanz‑ und Abbruchkriterien, testen Sie repräsentative Fehler und definieren Sie Monitoring, Rollback und Review, bevor Sie den Umfang erweitern. Protokollieren Sie Versionen und Annahmen, damit ein anderes Team das Ergebnis reproduzieren und die Änderungen nachvollziehen kann.
Vor dem Start führen Sie eine dokumentierte Readiness‑Review mit den Personen durch, die das System bauen, betreiben, sichern und von ihm betroffen sind. Testen Sie Normalfälle, Grenzbedingungen, Ausfall von Abhängigkeiten und Fehlgebrauch; bewahren Sie die Beweise und offenen Risiken auf. Definieren Sie, wer die Freigabe genehmigen, Schwellenwerte ändern, Ausgaben überschreiben oder den Betrieb stoppen kann. Überprüfen Sie die Entscheidung erneut, sobald reale Daten vorliegen, da ein technisch erfolgreicher Pilot nicht automatisch zuverlässige Leistung in größerem Maßstab garantiert.
- DENSITY: mehr Leistungsfähigkeit pro Chip‑Fläche.
- EFFICIENCY: Präzision, Lokalität und Spezialisierung.
- REAL RESULT: Qualität pro Zeiteinheit, Energie und Kosten.
Häufig gestellte Fragen
Ist das Mooresche Gesetz vorbei?
Der einfache historische Trend hat sich verlangsamt und sein Charakter hat sich geändert, doch der Fortschritt in der Halbleitertechnologie setzt sich durch Geräte, Architekturen, Verpackungen, Speicher und Software fort. Ob die Formulierung noch zutrifft, hängt vom gewählten Messwert ab.
Bedeutet doppelt so viele Transistoren doppelte KI‑Leistung?
Nein. Die Leistung hängt davon ab, wie die Transistoren eingesetzt werden, sowie von Bandbreite, Präzision, Modellstruktur, Software‑Effizienz, Energieverbrauch und Workload‑Beschränkungen.
Primärreferenzen