
Interviews
Ben Koska, Gründer und CEO von SF Tensor – Interview-Serie

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
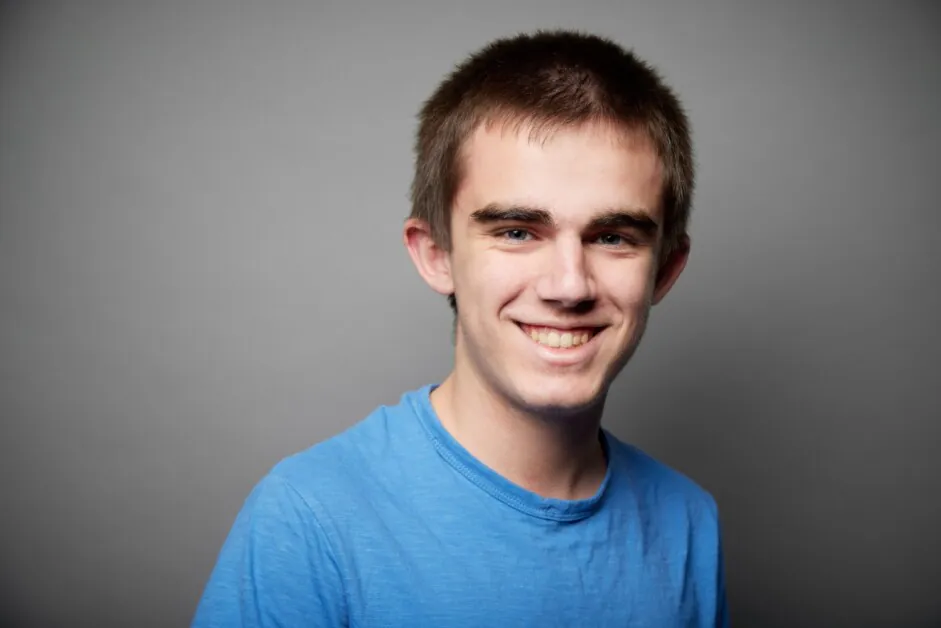
Ben Koska, Gründer und CEO von SF Tensor, ist ein AI-Forscher und Systemingenieur, der für seine Arbeit an Hochleistungsrechnern, Kernel-Optimierung und effizienter Modellierung bekannt ist. Sein Hintergrund umfasst die Entwicklung von Low-Level-AI-Infrastrukturen, die Verbesserung der Trainingsdurchlaufzeit und die Gestaltung von Tools, die fortschrittliche Modellentwicklung ohne schwerwiegende technische Überhead ermöglichen. Er konzentriert sich auf den Bau von Systemen, die die Grenzen von Geschwindigkeit, Portabilität und Zuverlässigkeit über heterogene Hardware hinauspushen.
SF Tensor ist das Unternehmen, das er leitet, um diese Philosophie in eine praktische Plattform umzusetzen. Es führt ein einheitliches Programmiermodell, einen Kernel-Optimizer und eine Cross-Cloud-Orchestrierungsschicht ein, die darauf abzielt, die Komplexität von verteilten AI-Workloads zu entfernen. Die Plattform zielt darauf ab, Ingenieuren eine saubere, hardwareunabhängige Umgebung zu bieten, in der sie einmal schreiben und überall bereitstellen können, um automatisch hohe Leistung zu erzielen. Die Mission von SF Tensor ist es, AI-Rechnen dramatisch schneller, einfacher zu verwalten und frei von Anbieterbindung zu machen.
Sie haben SF Tensor im Alter von 19 Jahren gegründet, nachdem Sie bereits bei mehreren Start-ups als Leiter der Ingenieurabteilung tätig waren. Was hat Sie dazu inspiriert, die Herausforderung der Neuerfindung von AI-Infrastruktur so früh in Ihrer Karriere anzunehmen?
Das Problem, das wir lösen, ist eines, das ich sehr stark betreibe, weil es eines ist, das ich selbst erlebt habe. Als wir das entwickelten, was jetzt SF Tensors Kernstack ist, arbeiteten wir nicht an einem kommerziellen Projekt, es war tatsächlich ein akademisches Vorhaben. Wir hatten ein Stipendium erhalten, um einige interessante Forschung durchzuführen, aber wir verbrachten den größten Teil unserer Zeit damit, Infrastruktur und Optimierungen zu bearbeiten, anstatt Forschung zu betreiben. Wir stellten fest, dass die Menschen universell mehr an unserer Infrastruktur-Technologie interessiert waren als an unserem Forschungsprojekt.
SF Tensor geht eines der schwierigsten Probleme im Bereich KI an – die Befreiung von NVIDIAs CUDA-Dominanz. Wie haben Sie einen Ansatz entwickelt, um ein System zu entwerfen, das wahre Hardware-Portabilität ohne Kompromisse bei der Leistung erreichen kann
Am Ende des Tages lässt sich alles in der KI auf einfache Mathematik zurückführen. Jedes Modell ist im Wesentlichen eine Menge mathematischer Operationen, die wir ausführen müssen, um die Ergebnisse zu berechnen. Indem wir es hauptsächlich als mathematisches Problem und nicht als Computer-Science-Problem betrachten, können wir die kleinstmögliche Menge an Einschränkungen auf die Berechnungen identifizieren und dann Millionen bis Milliarden verschiedene Möglichkeiten finden, diese Berechnungen in Maschinencode umzuwandeln, um die schnellste zu finden. Das ist leichter gesagt als getan, da wir nicht tatsächlich Milliarden von verschiedenen Programmen ausführen können, um die schnellste zu finden, also mussten wir, um unseren Suchraum zu beschneiden, ein genaues mathematisches Modell entwickeln, um die Geschwindigkeit eines gegebenen Programms für eine gegebene Hardware zu schätzen, was eine der Kerninnovationen ist, die es uns heute ermöglicht, was wir tun.
Das Unternehmen bloggt über Innovationen im Bereich Compiler-Optimierung und Cross-Cloud-Orchestrierung. Können Sie erklären, wie SF Tensors Ansatz sich von bestehenden Frameworks wie PyTorch oder JAX unterscheidet?
Wir haben noch keinen technischen Blog darüber geschrieben, aber wir unterstützen tatsächlich Frameworks wie PyTorch und JAX, sodass Code, der in ihnen geschrieben wurde, durch unseren Stack optimiert werden kann. Es gibt mehrere architektonische Entscheidungen, die JAX und PyTorch getroffen haben, die sie von unserem Stack unterscheiden, aber die bedeutendste ist, dass wir das gesamte Modell als eine einzelne Berechnung behandeln, die gelöst werden muss, anstatt einzelne Module, die individuell und dann gemeinsam optimiert werden müssen. In diesem Sinne erstellen wir anstatt traditioneller Compiler-Optimierungstechniken und dem Versuch, jede einzelne Optimierung anzuwenden, einen Suchraum von Millionen bis hin und wieder Milliarden von potenziellen Kernels und machen den Anspruch, dass kein Mensch possibly eine Menge von Regeln entwickeln kann, um jeden gegebenen Code in den schnellsten umzuwandeln, also müssen wir stattdessen einfach jeden möglichen Kombination erstellen und dann die schnellste identifizieren.
Viele Start-ups konzentrieren sich auf TrainingsEffizienz, aber Sie haben den “Infrastruktur-Steuer” – die Zeit, die Forscher mit der Verwaltung von Rechenleistung verbringen, anstatt zu innovieren – betont. Wie geht SF Tensor auf diese Ungleichgewicht?
Wir glauben, dass beide Probleme angegangen werden müssen, und ein Großteil unserer Arbeit konzentriert sich auf die Lösung der TrainingsEffizienz, aber das akuteste Problem, das wir derzeit ohne auf zukünftige Innovationen angewiesen zu sein lösen können, ist die Infrastruktur-Steuer, da es ein Problem ist, das wir bereits für uns selbst gelöst haben.
Sie haben bis zu 80% Reduzierung der Trainingskosten erwähnt. Welche spezifischen Optimierungen oder architektonischen Durchbrüche machen das möglich?
Unser gesamter Software-Stack basiert auf der Idee, dass ein Such-basierter Compiler immer menschliche Regeln schlagen wird. Bisher war die größte Einschränkung auf diese Compiler die Tatsache, dass es nicht möglich ist, Milliarden oder sogar Millionen von Kernels zu benchmarken und zu bewerten. Es war daher notwendig für uns, ein mathematisches Modell von Rechenleistung zu erstellen, das in der Lage ist, die Zeit, die eine gegebene Berechnung oder eine Menge von Berechnungen auf einer gegebenen Hardware benötigt, genau zu schätzen. Indem wir dies tun, können wir unseren Suchraum erweitern und dann beschneiden, was eine Notwendigkeit ist, wenn man die schnellsten Kernels konsistent finden will.
Wie beeinflusst Ihre Erfahrung bei der Entwicklung der Emma-Programmiersprache die Architektur und Philosophie von SF Tensor in Bezug auf Leistung und Abstraktion?
Ich bin immer noch ein Compiler-Ingenieur. Ich habe immer daran interessiert, verschiedene Möglichkeiten zu finden, um Dinge nur ein bisschen schneller zu machen. Bei der Entwicklung von Emma haben wir den Compiler 4 oder 5 Mal neu aufgebaut; wir haben von vorne begonnen, jedes Mal, weil wir auf eine Optimierung stießen, die wir nicht implementieren konnten, gezwungen, das System zu reorganisieren, um es noch allgemeiner zu machen, während wir gleichzeitig in der Lage waren, auf die niedrigste Ebene der Optimierung herabzusetzen, wenn notwendig, oft gegen gemeinsame Prinzipien von Compiler- und Sprachdesign. Diese Erkenntnisse und die resultierende Architektur haben fast zwei Jahre von dem ausgemacht, was wie kleine Optimierungen und falsche Wetten aussah, sich jedoch zu einem System zusammengesetzt haben, das es uns ermöglicht, jetzt schneller zu iterieren und besser zu optimieren als die Systeme, die gemeinsame Prinzipien befolgten, da diese Prinzipien grundlegend für CPUs und nicht für GPUs und AI-Modelle konzipiert sind.
Sie haben an großen Trainingsläufen mit über 4.000 GPUs gearbeitet – was waren einige der größten Lektionen, die Sie bei der Verwaltung von Rechenleistung in diesem Maßstab gelernt haben?
Eine der größten Lektionen ist, dass Hardware-Ausfälle viel häufiger und problematischer sind, als man annimmt. Nachdem ich viel Zeit mit traditionellen Programmen und Compilern verbracht habe, ist es allgemein so, dass ein Computer genau das tut, was er tut, und wenn etwas schiefgeht, ist es fast immer die Schuld des Menschen, der den Code geschrieben hat. Bei GPUs hingegen sind Hardware-Ausfälle ein häufiges Ereignis, insbesondere bei verteilten Trainingsläufen auf extrem großen Clustern. Dazu gehört die Tatsache, dass GPUs manchmal unerklärlicherweise Dinge tun, wie z.B. die Taktfrequenz senken, ohne erkennbaren Grund, und den gesamten Trainingsprozess verlangsamen, weil ein einzelner Chip langsamer läuft.
Y Combinator hat einige der transformierendsten Infrastruktur-Unternehmen in der Technologie-Branche unterstützt. Wie hat diese Erfahrung Ihren Ansatz bei der Skalierung von SF Tensors Produkt und Vision geprägt?
Als ich zu Y Combinator kam, dachte ich, dass die Wette, die wir damals machen wollten, ambitioniert war. Nach nur wenigen Wochen hatte sich unsere Definition von ambitioniert jedoch dramatisch geändert, und wir verdoppelten unsere Wette auf eine noch größere Wette. Zum anderen hat die Gemeinschaft und das Lernen, das ich durch Y Combinator erfahren habe, meine Art und Weise, Probleme anzugehen und eine viel kollaborativere Herangehensweise zu verfolgen, verändert.
Wenn Sie in die Zukunft blicken, haben Sie Interesse an nicht-LLM-Modellen, Robotik und synthetischen Daten geäußert. Wie passen diese Bereiche in Ihre langfristige Vision für das Unternehmen?
LLMs sind absolut eine interessante Technologie und werden einen integralen Teil davon ausmachen, wie die Welt in der Zukunft aussehen wird, aber der Grund, warum sie so viel weiter entwickelt sind als andere Bereiche der KI, liegt darin, dass viel Geld in ihre Entwicklung investiert wird und genug Menschen an dem Problem arbeiten, um es zu optimieren. Wenn wir die Hürde für den Einstieg senken können und Forschern auf der ganzen Welt, auch denen mit begrenzten Ressourcen und wenig bis keinem Wissen über Optimierungen, ermöglichen, ihre Forschung so billig und effizient wie möglich durchzuführen, denke ich, dass wir eine ganze neue Generation von Modellen sehen werden, die Probleme angehen, die LLMs nicht lösen können, entweder weil sie mit der physischen Welt interagieren oder weil sie Probleme sind, die nicht angemessen in Sprache ausgedrückt werden können.
Was denken Sie, wie die KI-Infrastruktur-Stack in fünf Jahren aussehen wird – und wo sehen Sie SF Tensors Rolle darin?
In fünf Jahren hoffe ich, dass viele mehr Unternehmen ihre eigenen spezialisierten Chips entwickelt und veröffentlicht haben werden und dass Forscher in der Lage sein werden, diese ohne spezielle Codierung für sie zu nutzen, idealerweise ohne überhaupt zu wissen, dass sie existieren. Das ist die Zukunft, auf die wir hinarbeiten, und ich glaube, dass wir eine bedeutende Rolle bei ihrer Gestaltung spielen werden.
Vielen Dank für das großartige Interview, Leser, die mehr erfahren möchten, sollten SF Tensor besuchen.


