

KI-Modelle und Plattformen
AniPortrait: Audio-gesteuerte Synthese von photorealistischen Porträt-Animationen

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
Im Laufe der Jahre hat die Erstellung realistischer und ausdrucksstarker Porträt-Animationen aus statischen Bildern und Audio eine Vielzahl von Anwendungen gefunden, darunter Gaming, digitale Medien, virtuelle Realität und vieles mehr. Trotz ihrer potenziellen Anwendungen ist es für Entwickler immer noch schwierig, Frameworks zu erstellen, die in der Lage sind, hochwertige Animationen zu generieren, die temporale Konsistenz aufrechterhalten und visuell ansprechend sind. Ein wesentlicher Grund für diese Komplexität ist die Notwendigkeit einer feinen Koordination von Lippenbewegungen, Kopfpositionen und Gesichtsausdrücken, um einen visuell überzeugenden Effekt zu erzielen.
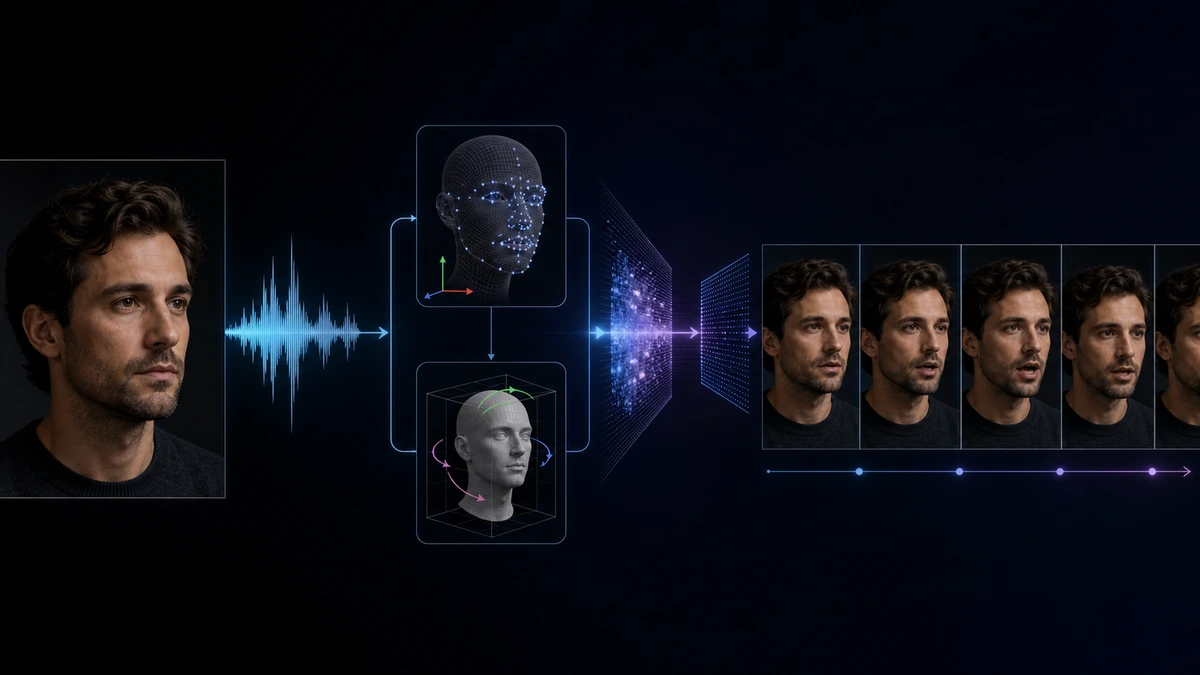
In diesem Artikel werden wir über AniPortrait sprechen, einem neuen Framework, das darauf ausgelegt ist, hochwertige Animationen zu generieren, die von einem Referenzporträtbild und einer Audio-Probe gesteuert werden. Die Funktionsweise des AniPortrait-Frameworks ist in zwei Stadien unterteilt. Zunächst extrahiert das AniPortrait-Framework die intermediären 3D-Darstellungen aus den Audio-Proben und projiziert sie in eine Sequenz von 2D-Gesichtsmerkmalen. Anschließend verwendet das Framework ein robustes Diffusionsmodell in Kombination mit einem Bewegungsmodul, um die Merkmalssequenzen in temporale und photorealistische Animationen umzuwandeln. Die experimentellen Ergebnisse zeigen die Überlegenheit und Fähigkeit des AniPortrait-Frameworks, hochwertige Animationen mit außergewöhnlicher visueller Qualität, Pose-Vielfalt und Gesichtsnaturalität zu generieren, was zu einem verbesserten und bereicherten Wahrnehmungserlebnis führt. Darüber hinaus bietet das AniPortrait-Framework ein bemerkenswertes Potenzial in Bezug auf Steuerbarkeit und Flexibilität und kann effektiv in Bereichen wie Gesichtsreenactment, Gesichtsbewegungseditierung und mehr eingesetzt werden. Dieser Artikel zielt darauf ab, das AniPortrait-Framework in-depth zu beleuchten und wir erforschen den Mechanismus, die Methodik, die Architektur des Frameworks sowie seinen Vergleich mit State-of-the-Art-Frameworks. Also los geht’s.
AniPortrait: Photorealistische Porträt-Animation
Die Erstellung realistischer und ausdrucksstarker Porträt-Animationen ist seit geraumer Zeit das Ziel von Forschern, aufgrund ihres enormen Potenzials und ihrer Anwendungen, die von digitalen Medien und virtueller Realität bis hin zu Gaming und mehr reichen. Trotz jahrelanger Forschung und Entwicklung stellt die Erstellung hochwertiger Animationen, die temporale Konsistenz aufrechterhalten und visuell ansprechend sind, immer noch eine erhebliche Herausforderung dar. Ein wesentlicher Hürde für Entwickler ist die Notwendigkeit einer feinen Koordination zwischen Kopfpositionen, visuellen Ausdrücken und Lippenbewegungen, um einen visuell überzeugenden Effekt zu erzielen. Bestehende Methoden haben es nicht geschafft, diese Herausforderungen zu meistern, da sie hauptsächlich auf begrenzten Kapazitäten wie NeRF, motion-basierten Decodern und GAN für die visuelle Inhaltserschaffung angewiesen sind. Diese Netzwerke zeigen begrenzte Generalisierungsfähigkeiten und sind instabil bei der Generierung hochwertiger Inhalte. Die jüngste Entwicklung von Diffusionsmodellen hat jedoch die Generierung hochwertiger Bilder ermöglicht, und einige auf Diffusionsmodellen basierende Frameworks haben die Erstellung überzeugender Videos ermöglicht, indem sie Diffusionsmodelle mit temporalen Modulen kombinierten.
Basierend auf den Fortschritten der Diffusionsmodelle zielt das AniPortrait-Framework darauf ab, hochwertige animierte Porträts unter Verwendung eines Referenzbildes und einer Audio-Probe zu generieren. Die Funktionsweise des AniPortrait-Frameworks ist in zwei Stadien unterteilt. Im ersten Stadium verwendet das AniPortrait-Framework transformer-basierte Modelle, um eine Sequenz von 3D-Gesichtsnetzen und Kopfpositionen aus Audio-Eingaben zu extrahieren und projiziert sie anschließend in eine Sequenz von 2D-Gesichtsmerkmalen. Das erste Stadium ermöglicht es dem AniPortrait-Framework, Lippenbewegungen und subtile Ausdrücke aus der Audio-Probe zu erfassen, zusätzlich zu Kopfbewegungen, die mit dem Rhythmus der Audio-Probe synchronisiert sind. Im zweiten Stadium verwendet das AniPortrait-Framework ein robustes Diffusionsmodell in Kombination mit einem Bewegungsmodul, um die Merkmalssequenzen in photorealistische und temporale Animationen umzuwandeln. Um genauer zu sein, basiert das AniPortrait-Framework auf der Netzwerkarchitektur des bestehenden AnimateAnyone-Modells, das Stable Diffusion 1.5, ein leistungsfähiges Diffusionsmodell, verwendet, um lebendige und flüssige Animationen basierend auf einem Referenzbild und einer Körperbewegungssequenz zu generieren. Was beachtenswert ist, ist, dass das AniPortrait-Framework nicht den Pose-Guider-Modul innerhalb dieses Netzwerks verwendet, sondern ihn neu entwirft, was es dem AniPortrait-Framework ermöglicht, nicht nur ein leichtes Design zu haben, sondern auch eine verbesserte Genauigkeit bei der Generierung von Lippenbewegungen zu zeigen.
Die experimentellen Ergebnisse zeigen die Überlegenheit des AniPortrait-Frameworks bei der Erstellung von Animationen mit beeindruckender Gesichtsnaturalität, exzellenter visueller Qualität und vielfältigen Posen. Durch die Verwendung von 3D-Gesichtsrepräsentationen als intermediäre Merkmale gewinnt das AniPortrait-Framework die Flexibilität, diese Repräsentationen nach Bedarf zu modifizieren. Diese Anpassungsfähigkeit verbessert die Anwendbarkeit des AniPortrait-Frameworks in verschiedenen Bereichen, einschließlich Gesichtsreenactment und Gesichtsbewegungseditierung.
AniPortrait: Funktionsweise und Methodik
Das vorgeschlagene AniPortrait-Framework besteht aus zwei Modulen, nämlich Lmk2Video und Audio2Lmk. Das Audio2Lmk-Modul versucht, eine Sequenz von Merkmalen zu extrahieren, die feine Lippenbewegungen und Gesichtsausdrücke aus der Audio-Eingabe erfassen, während das Lmk2Video-Modul diese Merkmalssequenz verwendet, um hochwertige Porträt-Videos mit temporaler Stabilität zu generieren. Die folgende Abbildung zeigt eine Übersicht über die Funktionsweise des AniPortrait-Frameworks. Wie man sehen kann, extrahiert das AniPortrait-Framework zunächst die 3D-Gesichtsnetze und Kopfpositionen aus der Audio-Eingabe und projiziert sie anschließend in 2D-Schlüsselpunkte. Im zweiten Stadium verwendet das Framework ein Diffusionsmodell, um die 2D-Schlüsselpunkte in ein Porträt-Video umzuwandeln, wobei beide Stadien innerhalb des Netzwerks gleichzeitig trainiert werden.

Audio2Lmk
Für eine gegebene Sequenz von Sprachproben ist das primäre Ziel des AniPortrait-Frameworks, die entsprechende 3D-Gesichtsnetz-Sequenz mit Vektor-Repräsentationen von Translation und Rotation vorherzusagen. Das AniPortrait-Framework verwendet die vorgebildete Wav2Vec-Methode, um Audio-Merkmale zu extrahieren, und das Modell zeigt eine hohe Generalisierungsfähigkeit und ist in der Lage, Intonation und Aussprache aus der Audio-Eingabe genau zu erkennen, was eine entscheidende Rolle bei der Generierung realistischer Gesichtsanimationen spielt. Durch die Nutzung der erworbenen robusten Sprachmerkmale kann das AniPortrait-Framework effektiv eine einfache Architektur bestehend aus zwei fc-Schichten verwenden, um diese Merkmale in 3D-Gesichtsnetze umzuwandeln. Das AniPortrait-Framework beobachtet, dass diese einfache Designimplementierung durch das Modell nicht nur die Effizienz des Inferenzprozesses verbessert, sondern auch die Genauigkeit sicherstellt. Wenn das Audio in Pose umgewandelt wird, verwendet das AniPortrait-Framework das gleiche Wav2Vec-Netzwerk als Backbone, obwohl das Modell nicht die Gewichte mit dem Audio-zu-Mesh-Modul teilt. Dies liegt hauptsächlich daran, dass die Pose eher mit dem Ton und dem Rhythmus in der Audio-Eingabe assoziiert ist, was einen anderen Schwerpunkt im Vergleich zu Audio-zu-Mesh-Aufgaben hat. Um den Einfluss der vorherigen Zustände zu berücksichtigen, verwendet das AniPortrait-Framework einen Transformer-Decoder, um die Pose-Sequenz zu decodieren. Während dieses Prozesses integriert das Framework die Audio-Merkmale in den Decoder mithilfe von Cross-Attention-Mechanismen, und für beide Module trainiert das Framework sie mithilfe des L1-Verlusts. Sobald das Modell die Pose- und Mesh-Sequenz erhält, verwendet es die Perspektivprojektion, um diese Sequenzen in eine 2D-Sequenz von Gesichtsmerkmalen umzuwandeln, die dann als Eingabesignale für das nächste Stadium verwendet werden.
Lmk2Video
Für eine gegebene Referenz-Porträt-Bild und eine Sequenz von Gesichtsmerkmalen erstellt das Lmk2Video-Modell eine temporale konsistente Porträt-Animation, die die Bewegung mit der Merkmalssequenz ausrichtet und ein Aussehen aufrechterhält, das mit dem Referenzbild konsistent ist, und schließlich stellt das Framework die Porträt-Animation als eine Sequenz von Porträt-Bildern dar. Die Designstruktur des Lmk2Video-Netzwerks sucht Inspiration bei dem bestehenden AnimateAnyone-Framework. Das AniPortrait-Framework verwendet Stable Diffusion 1.5, ein extrem leistungsfähiges Diffusionsmodell, als Backbone und integriert ein temporales Bewegungsmodul, das effektiv multi-frame-Rausch-Eingaben in eine Sequenz von Video-Bildern umwandelt. Gleichzeitig verwendet ein ReferencenNet-Netzwerk-Komponente die Struktur von Stable Diffusion 1.5 und verwendet es, um die Erscheinungsinformationen aus dem Referenzbild zu extrahieren und in den Backbone zu integrieren. Die strategische Designentscheidung stellt sicher, dass die Gesichts-ID während des gesamten Ausgabevideos konsistent bleibt. Im Gegensatz zum AnimateAnyone-Framework verbessert das AniPortrait-Framework die Komplexität des Pose-Guider-Designs. Die ursprüngliche Version des AnimateAnyone-Frameworks besteht nur aus einigen Convolution-Schichten, nach denen die Merkmalsinformationen mit den Latenten auf der Eingabeschicht des Backbones fusionieren. Das AniPortrait-Framework entdeckt, dass dieses Design nicht in der Lage ist, feine Lippenbewegungen zu erfassen, und um dieses Problem zu lösen, verwendet das Framework die Multi-Scale-Strategie der ConvNet-Architektur und integriert Merkmalsinformationen entsprechender Skalen in verschiedene Blöcke des Backbones. Darüber hinaus führt das AniPortrait-Framework eine zusätzliche Verbesserung ein, indem es die Merkmale des Referenzbildes als zusätzliche Eingabe hinzufügt. Der Cross-Attention-Modul der Pose-Guider-Komponente ermöglicht die Interaktion zwischen den Zielmerkmalen jedes Rahmens und den Referenzmerkmalen. Dieser Prozess stellt dem Netzwerk zusätzliche Hinweise bereit, um die Korrelation zwischen Erscheinung und Gesichtsmerkmalen zu verstehen, was bei der Generierung von Porträt-Animationen mit präziserer Bewegung hilft.
AniPortrait: Implementierung und Ergebnis
Für das Audio2Lmk-Stadium verwendet das AniPortrait-Framework die Wav2Vec2.0-Komponente als Backbone und nutzt die MediaPipe-Architektur, um 3D-Meshes und 6D-Posen für Annotationen zu extrahieren. Das Modell bezieht die Trainingsdaten für die Audio2Mesh-Komponente aus seinem internen Datensatz, der etwa 60 Minuten hochwertiger Sprachdaten von einem einzigen Sprecher umfasst. Um sicherzustellen, dass der 3D-Mesh, der von der MediaPipe-Komponente extrahiert wird, stabil ist, wird der Sprecher angewiesen, während des gesamten Aufnahmeprozesses in die Kamera zu schauen und eine feste Kopfposition beizubehalten. Für das Lmk2Video-Modul implementiert das AniPortrait-Framework einen zweistufigen Trainingsansatz. Im ersten Stadium konzentriert sich das Framework auf das Training von ReferenceNet und PoseGuider, der 2D-Komponente des Backbones, und lässt das Bewegungsmodul außer Acht. Im zweiten Schritt friert das AniPortrait-Framework alle anderen Komponenten ein und konzentriert sich auf das Training des Bewegungsmoduls. Für dieses Stadium verwendet das Framework zwei große, hochwertige Gesichts-Video-Datensätze, um das Modell zu trainieren, und verarbeitet alle Daten mithilfe der MediaPipe-Komponente, um 2D-Gesichtsmerkmale zu extrahieren. Darüber hinaus verwendet das AniPortrait-Modell, um die Empfindlichkeit des Netzwerks gegenüber Lippenbewegungen zu erhöhen, die oberen und unteren Lippen mit unterschiedlichen Farben, wenn es das Pose-Bild aus 2D-Merkmalen rendern lässt.
Wie in der folgenden Abbildung gezeigt wird, generiert das AniPortrait-Framework eine Reihe von Animationen, die eine überlegene Qualität und Realität aufweisen.

Das Framework verwendet dann eine intermediäre 3D-Repräsentation, die bearbeitet werden kann, um die Ausgabe nach Bedarf zu manipulieren. Beispielsweise können Benutzer Merkmale aus einer bestimmten Quelle extrahieren und ihre ID ändern, was es dem AniPortrait-Framework ermöglicht, einen Gesichtsreenactment-Effekt zu erzeugen.
Final Thoughts
In diesem Artikel haben wir über AniPortrait gesprochen, einem neuen Framework, das darauf ausgelegt ist, hochwertige Animationen zu generieren, die von einem Referenzporträtbild und einer Audio-Probe gesteuert werden. Durch die einfache Eingabe eines Referenzbildes und einer Audio-Datei kann das AniPortrait-Framework ein Porträt-Video generieren, das natürliche Kopfbewegungen und glatte Lippenbewegungen aufweist. Durch die Nutzung der robusten Generalisierungsfähigkeiten des Diffusionsmodells generiert das AniPortrait-Framework Animationen, die eine beeindruckende realistische Bildqualität und lebendige Bewegungen aufweisen. Die Funktionsweise des AniPortrait-Frameworks ist in zwei Stadien unterteilt. Zunächst extrahiert das AniPortrait-Framework die intermediären 3D-Repräsentationen aus den Audio-Proben und projiziert sie in eine Sequenz von 2D-Gesichtsmerkmalen. Anschließend verwendet das Framework ein robustes Diffusionsmodell in Kombination mit einem Bewegungsmodul, um die Merkmalssequenzen in temporale und photorealistische Animationen umzuwandeln. Die experimentellen Ergebnisse zeigen die Überlegenheit und Fähigkeit des AniPortrait-Frameworks, hochwertige Animationen mit außergewöhnlicher visueller Qualität, Pose-Vielfalt und Gesichtsnaturalität zu generieren, was zu einem verbesserten und bereicherten Wahrnehmungserlebnis führt. Darüber hinaus bietet das AniPortrait-Framework ein bemerkenswertes Potenzial in Bezug auf Steuerbarkeit und Flexibilität und kann effektiv in Bereichen wie Gesichtsreenactment, Gesichtsbewegungseditierung und mehr eingesetzt werden.


